把图像库装进镜像后,读书笔记 API 终于能在另一台机器上处理上传。可是几张大图片同时到来,后台摘要任务明显变慢;重新创建 API 容器后,图片又不见了。容器已经启动成功,为什么这些问题仍然存在?
这里先从三个地方看:进程能看到什么,能使用多少资源,能访问哪些文件。容器分别通过 namespaces、cgroups 和文件系统安排这些条件。这几种机制各有职责,配置错一个边界,就可能得到完全不同的运行结果。本文以 Linux 容器为主,网络示例使用常见的 Docker bridge 模式。
namespaces 改变进程看到的视图
在普通 Linux 系统里,进程通过内核访问文件、网络和其他资源。容器运行时仍然要启动进程,只是在启动前后为它安排隔离环境。
namespaces 改变进程看到的系统视图。PID namespace 可以让 API 进程在容器里显示为 PID 1,在宿主机上却有另一个进程号;network namespace 提供独立的网络接口、路由和端口空间;mount namespace 让进程拥有独立的挂载视图。因此,两份 API 都能在各自的环境里监听 8080,也能看到不同的根目录内容。OCI 的 Linux 运行规范分别定义了这些隔离对象。
rootfs 是进程使用的根文件系统,其中可以有应用代码、动态链接库、证书和命令行工具。镜像负责提供这些用户空间文件。程序调用文件读写或网络接口时,真正完成操作的仍是宿主机内核。换一个发行版的镜像,通常是换了用户空间文件,并没有顺带启动那个发行版自己的内核。
chroot 可以改变进程解析绝对路径时使用的根目录,但它本身不是完整的安全沙箱。容器运行时还需要准备挂载、权限和其他隔离条件。理解 rootfs 时,可以把“目录里有什么”与“进程被允许做什么”分开看。chroot 的边界
虚拟机则有自己的客户机内核。这是理解两者边界的重要区别:同一 Linux 宿主上的普通容器共享内核,虚拟机里的应用先与客户机内核交互。Docker 对容器与虚拟机的说明也以此作区分。
在 Mac 上用 Docker Desktop 运行 Linux 容器时,中间还隔着 Linux 虚拟机。容器共享的是那台虚拟机的 Linux 内核,文件共享和端口转发由 Desktop 的相关组件连接到 Mac。Windows 的 Linux 容器环境同样需要相应的 Linux 后端。排查挂载速度或网络差异时,应把这层边界算进去。Docker Desktop 网络架构
这些视图并非永远固定。运行时可以让两个容器共享某个 namespace,也可以使用宿主网络。分析问题时应看实际配置,不能只看到“容器”两个字就推断隔离程度。后面介绍 Kubernetes 的 Pod 时,同一 Pod 内容器共享网络、能够通过 localhost 通信,就建立在这种可组合性上。Pod 的网络共享
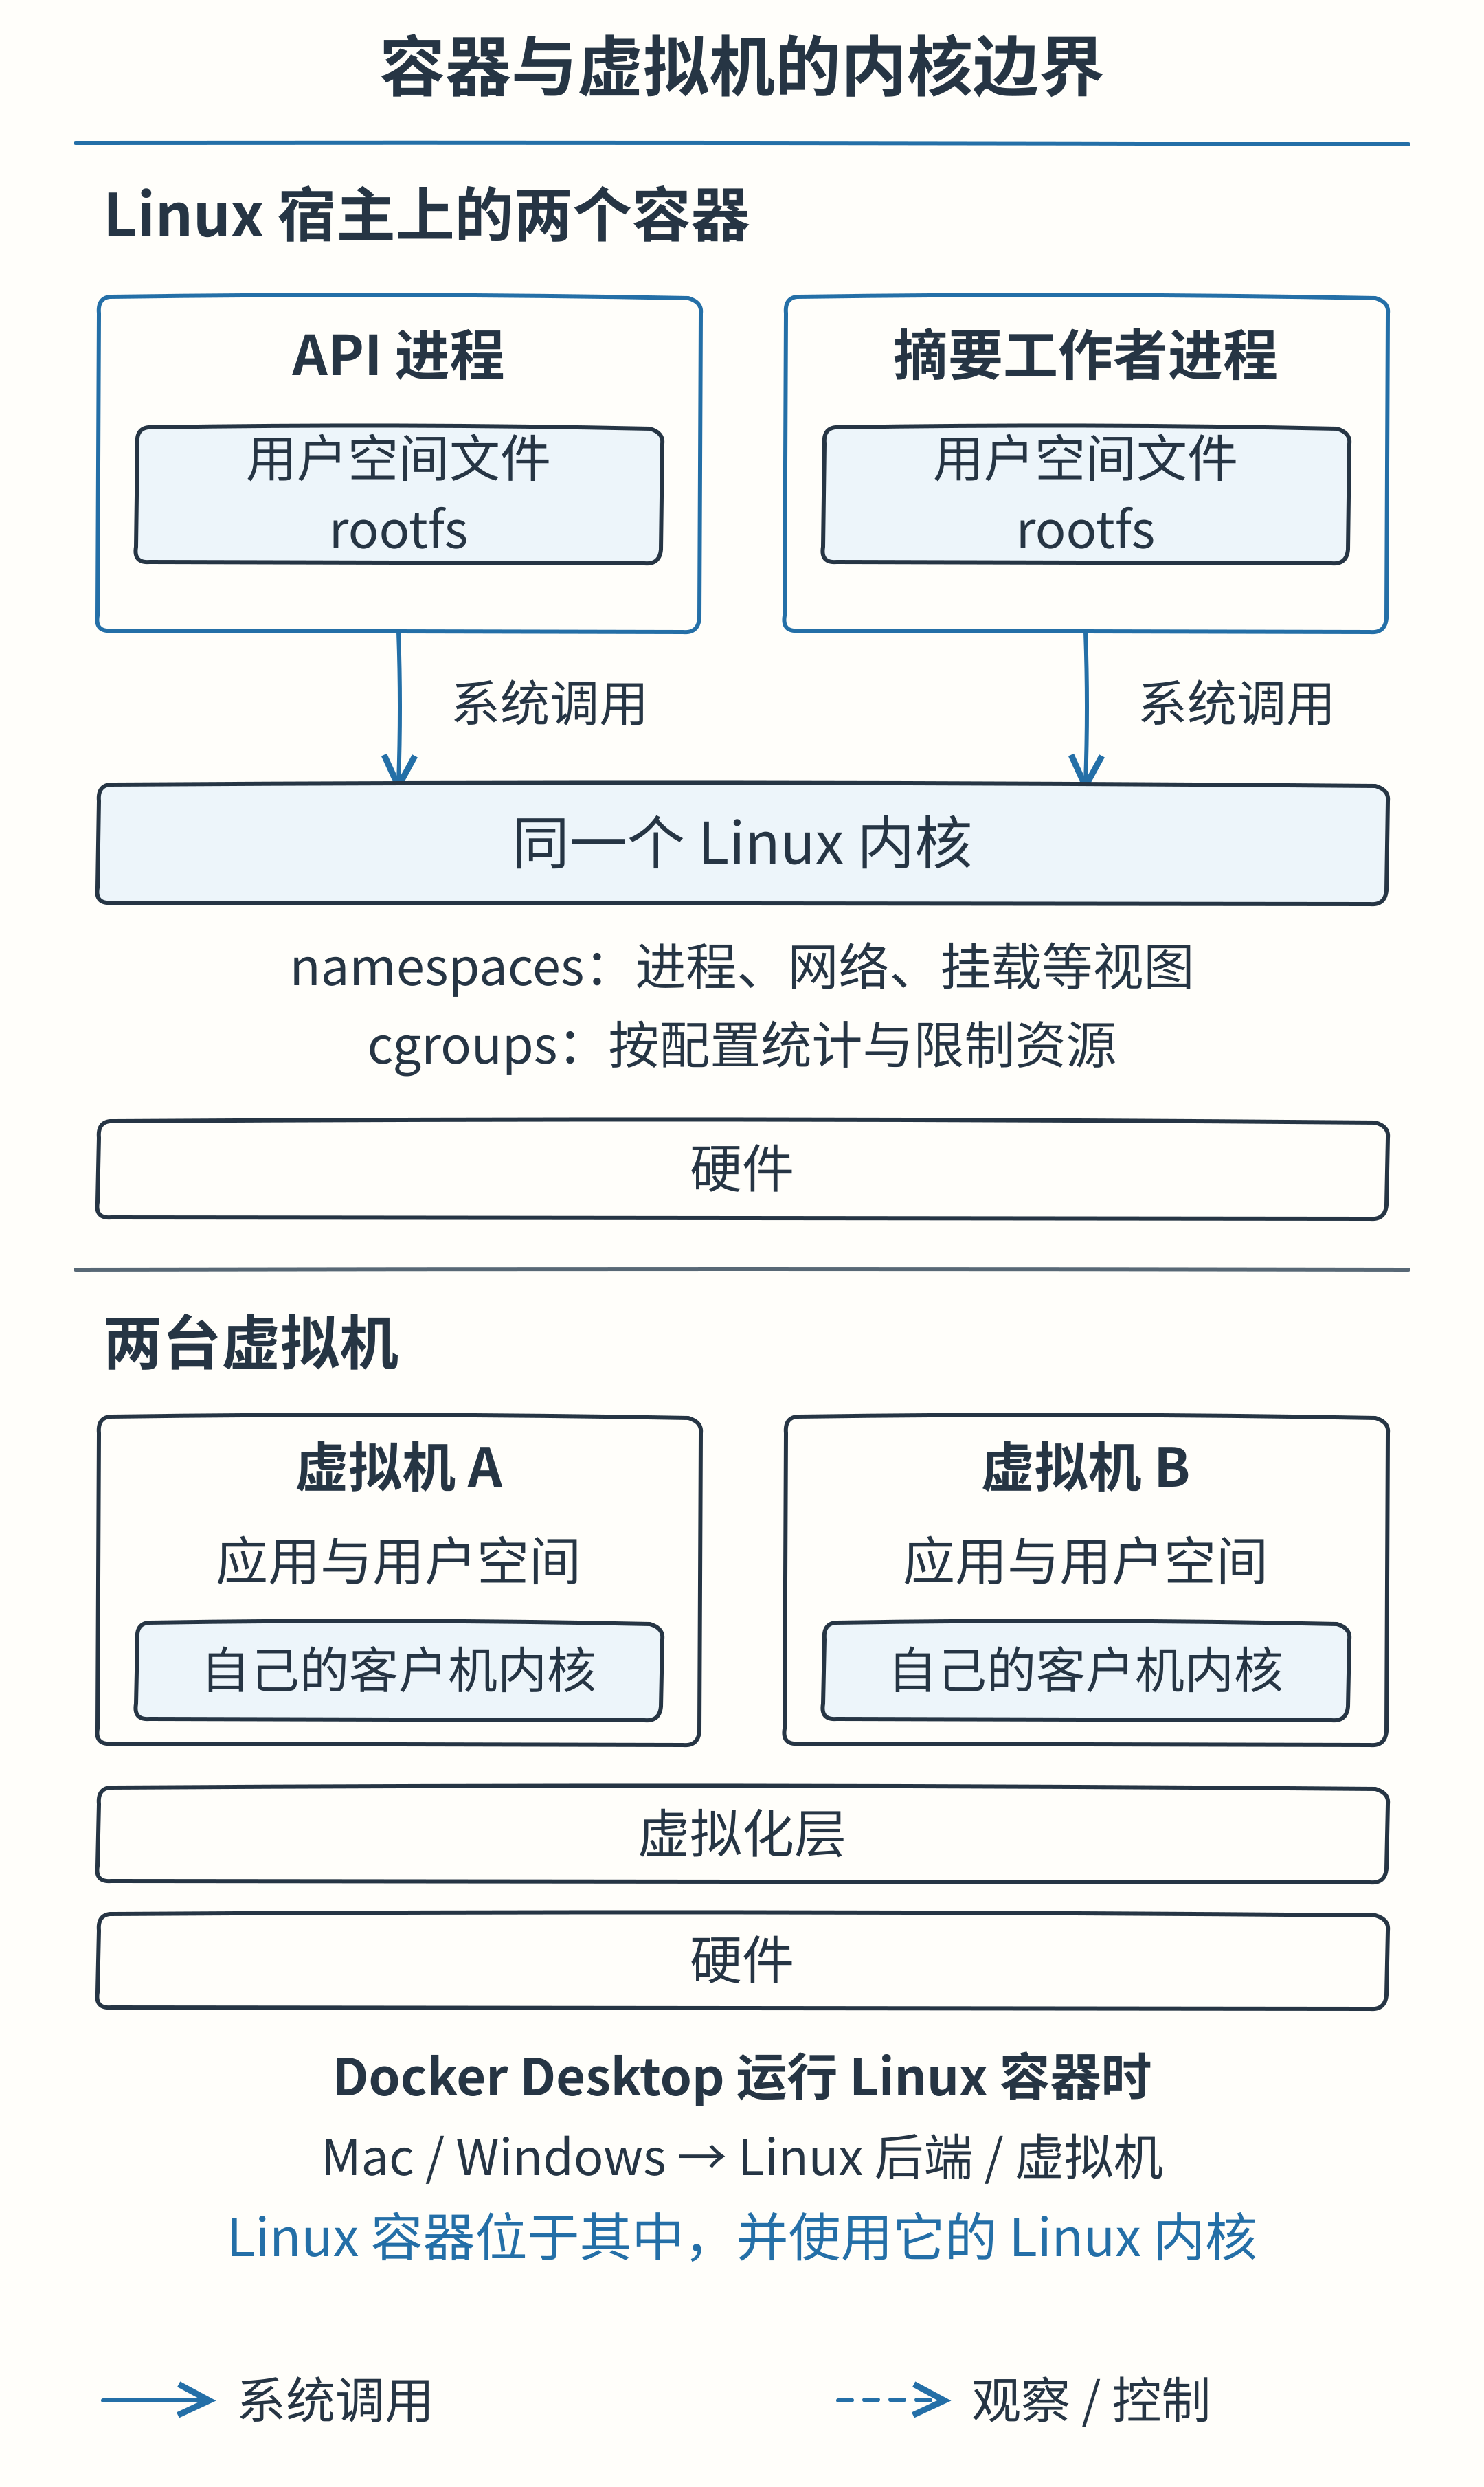
容器改变进程所处的运行环境;图中容器共享一个 Linux 内核,虚拟机各自具有客户机内核。资源限制取决于配置。
docker exec 怎样进入已有容器
运行中的 namespace 可以通过 Linux 宿主的 /proc/<pid>/ns/ 观察。这里是 procfs 提供的特殊链接,不是保存在磁盘上的一组普通配置文件。在 Docker Desktop 环境里,还要注意这个 PID 属于 Linux 后端,不能直接拿它去查 Mac 的进程目录。
执行 docker exec notes-api sh,是在运行中的容器环境里启动一个新进程,并非把本地终端搬进另一个操作系统。运行时可以借助 setns() 加入已有 namespace,再按要求创建进程;同时还需要安排根目录、用户身份与 cgroup 等条件。docker exec
这里有个容易忽略的细节:对 PID namespace 调用 setns(),影响的是调用者随后创建的子进程,不会把调用者现有的 PID 重新编号。加入 cgroup namespace 也不等于把进程移动到对应资源组。setns 系统调用
cgroups 限制一组进程的资源
假设一张压缩图片只有几兆字节,解码后的像素数据却大得多。API 一次并行处理很多张图片,可能占满内存;摘要进程虽然看不到 API 的进程列表,仍然要和它争用同一台机器的资源。
cgroups 把进程组织成组,统计并控制资源使用。Docker 默认不会为每个容器自动设置 CPU、内存上限;它们能用多少,仍受宿主机、上级资源限制和内核调度约束。容器之间有隔离视图,并不能据此假定资源已经公平分配。Docker 资源限制
例如给 API 配置 --memory=512m --cpus=1,表达的是内存上限和 CPU 时间配额。后者没有给它预留一颗独占 CPU。CPU 配额耗尽后,进程可能暂时被节流,请求延迟随之上升。若改成每100毫秒周期给20毫秒 CPU 配额,约等于一颗逻辑 CPU 的20%时间额度;多线程会共同消耗它,并不保证每个瞬间都只显示20%使用率。内存达到硬限制且无法回收时,则可能触发该组内的 OOM 杀进程。两种限制的失败方式不同。Linux cgroup v2 资源控制
查底层配置时,需要先区分 cgroup 版本。旧教程中的 cpu.cfs_quota_us、cpu.cfs_period_us 和 tasks 属于 v1 的接口;v2 使用统一层级,CPU 配额对应 cpu.max,进程归属可以查看 cgroup.procs。不要照着固定的 /sys/fs/cgroup/cpu/ 路径判断所有机器。Docker 运行指标与 cgroup 版本
top 等工具读取 procfs 数据,但其中部分信息可能仍反映宿主范围。CPU 汇总文件是 /proc/stat,进程信息还涉及 /proc/<pid>/stat。LXCFS 可以为部分 procfs 文件提供容器感知视图;排障时仍应同时核对实际 cgroup 限制。Linux procfs、LXCFS
设置上限之后还要回到应用设计:限制上传尺寸和解码后的像素数,控制图片处理并发,给摘要任务设置合适的工作者数量。上限只约束损害范围,不能减少每次处理本身需要的内存。
如果容器突然退出,应把内存曲线、容器的 OOM 状态和宿主日志放在一起看。退出码 137 是进程遭到 SIGKILL 的线索,人工强制终止也能产生相似结果,不能只凭这个数字判定内存泄漏。反过来,进程还活着但响应变慢,也可能与 CPU 节流有关。
文件写到哪里决定它能活多久
镜像可以被多个容器复用,因为运行时不会直接把各自的修改写回共享镜像。在常见的分层文件系统中,只读镜像层之上还有容器自己的可写层;新增文件和文件修改记录在这层。底层文件被修改时,存储实现可能先将它复制到可写层,再进行写入。
具体落盘目录取决于存储后端。旧资料中的 AUFS 目录不能当作通用默认值;Docker 也有传统存储驱动与 containerd snapshotter 等不同实现。理解分层和写时复制之后,再通过实际运行配置确认后端。Docker 的 containerd 镜像存储
于是,同一镜像启动的两个 API 实例,各自写入 /app/uploads,得到的是两份独立的数据。请求打到实例 A 可以看到图片,打到实例 B 就可能返回不存在。问题的原因已经发生在存储边界,负载均衡只把它暴露出来。
停止后再次启动同一个容器,通常仍保留可写层;删除旧容器、从镜像新建容器,可写层就不会继承过去。因此,“重启会丢文件”说得太粗,必须问清楚究竟是重启进程、重启原容器,还是删除后重建。Docker 镜像层与容器可写层
再看挂载。Docker 管理的 volume 和直接指定宿主路径的 bind mount,需要区分。两者挂载到容器里的路径后,写入落到挂载目标,生命周期与容器可写层另算。Docker volumes
例如镜像原本在 /app/config 放了默认配置,后来把宿主机的空目录 bind mount 到这里,默认配置就被遮蔽了。它没有从镜像中删除,只是在当前挂载视图里看不到。若容器因此启动失败,应先检查挂载目标,而不是立即重建镜像。Bind mount 的遮蔽行为
mount namespace 隔离的是挂载视图,不能据此断言挂载一定安全。把宿主敏感目录以可写方式暴露给容器,进程就可能修改其中的数据。需要看清共享了什么、给了什么权限;只需读取的配置可使用只读挂载。
读书笔记可以把临时缩略图放在可丢弃目录,把正式图片上传到对象存储;数据库数据交给单独管理的持久存储。卷也需要备份和权限管理,挂载成功不代表数据已经能够抵御误删与主机故障。
容器里的 localhost 到底是谁
开发时,API 用 localhost:5432 连接本机数据库。分别装进两个容器后,这个地址通常就不对了:API 的 localhost 指向自己的网络命名空间,而数据库监听在另一份网络空间里。
在 Linux 的典型 bridge 网络里,容器网卡通过 veth pair 接到宿主网桥:一端位于容器 network namespace,另一端连接网桥。veth 两端像一条虚拟网线,网桥负责在端口间转发二层帧。默认 bridge 常见名称是 docker0,用户自定义网络则有自己的网桥,不能把所有环境都画成同一个 docker0。Linux veth、Docker bridge
把两者接入同一个用户自定义 bridge 网络后,可以通过已配置的数据库容器名或网络别名,例如 db:5432,进行连接。这里用的是数据库的容器端口,不需要先绕到宿主机的发布端口。是否能够通信,还要满足监听地址、网络规则与数据库认证等条件。Docker 容器网络
浏览器从宿主机访问 API 则是另一条路径。发布参数 -p 127.0.0.1:8080:8080 的含义是:将宿主机回环地址上的 8080 端口转发到容器的 8080 端口。API 通常需要在容器内监听 0.0.0.0:8080,只监听自己的 127.0.0.1,从容器网卡进来的连接仍可能到不了它。
宿主侧绑定回环地址适合本地开发。省略地址写成 -p 8080:8080,通常会绑定宿主机所有接口,可能对外暴露服务。旧版 Docker 还存在回环发布可被同一二层网络访问的例外,安全边界应结合版本与防火墙核验。Docker 端口发布说明
由此可见,“端口已经映射”只验证了链路中的一段。容器里应用有没有监听、监听在哪个地址、宿主端口绑定在哪里,应分别检查。
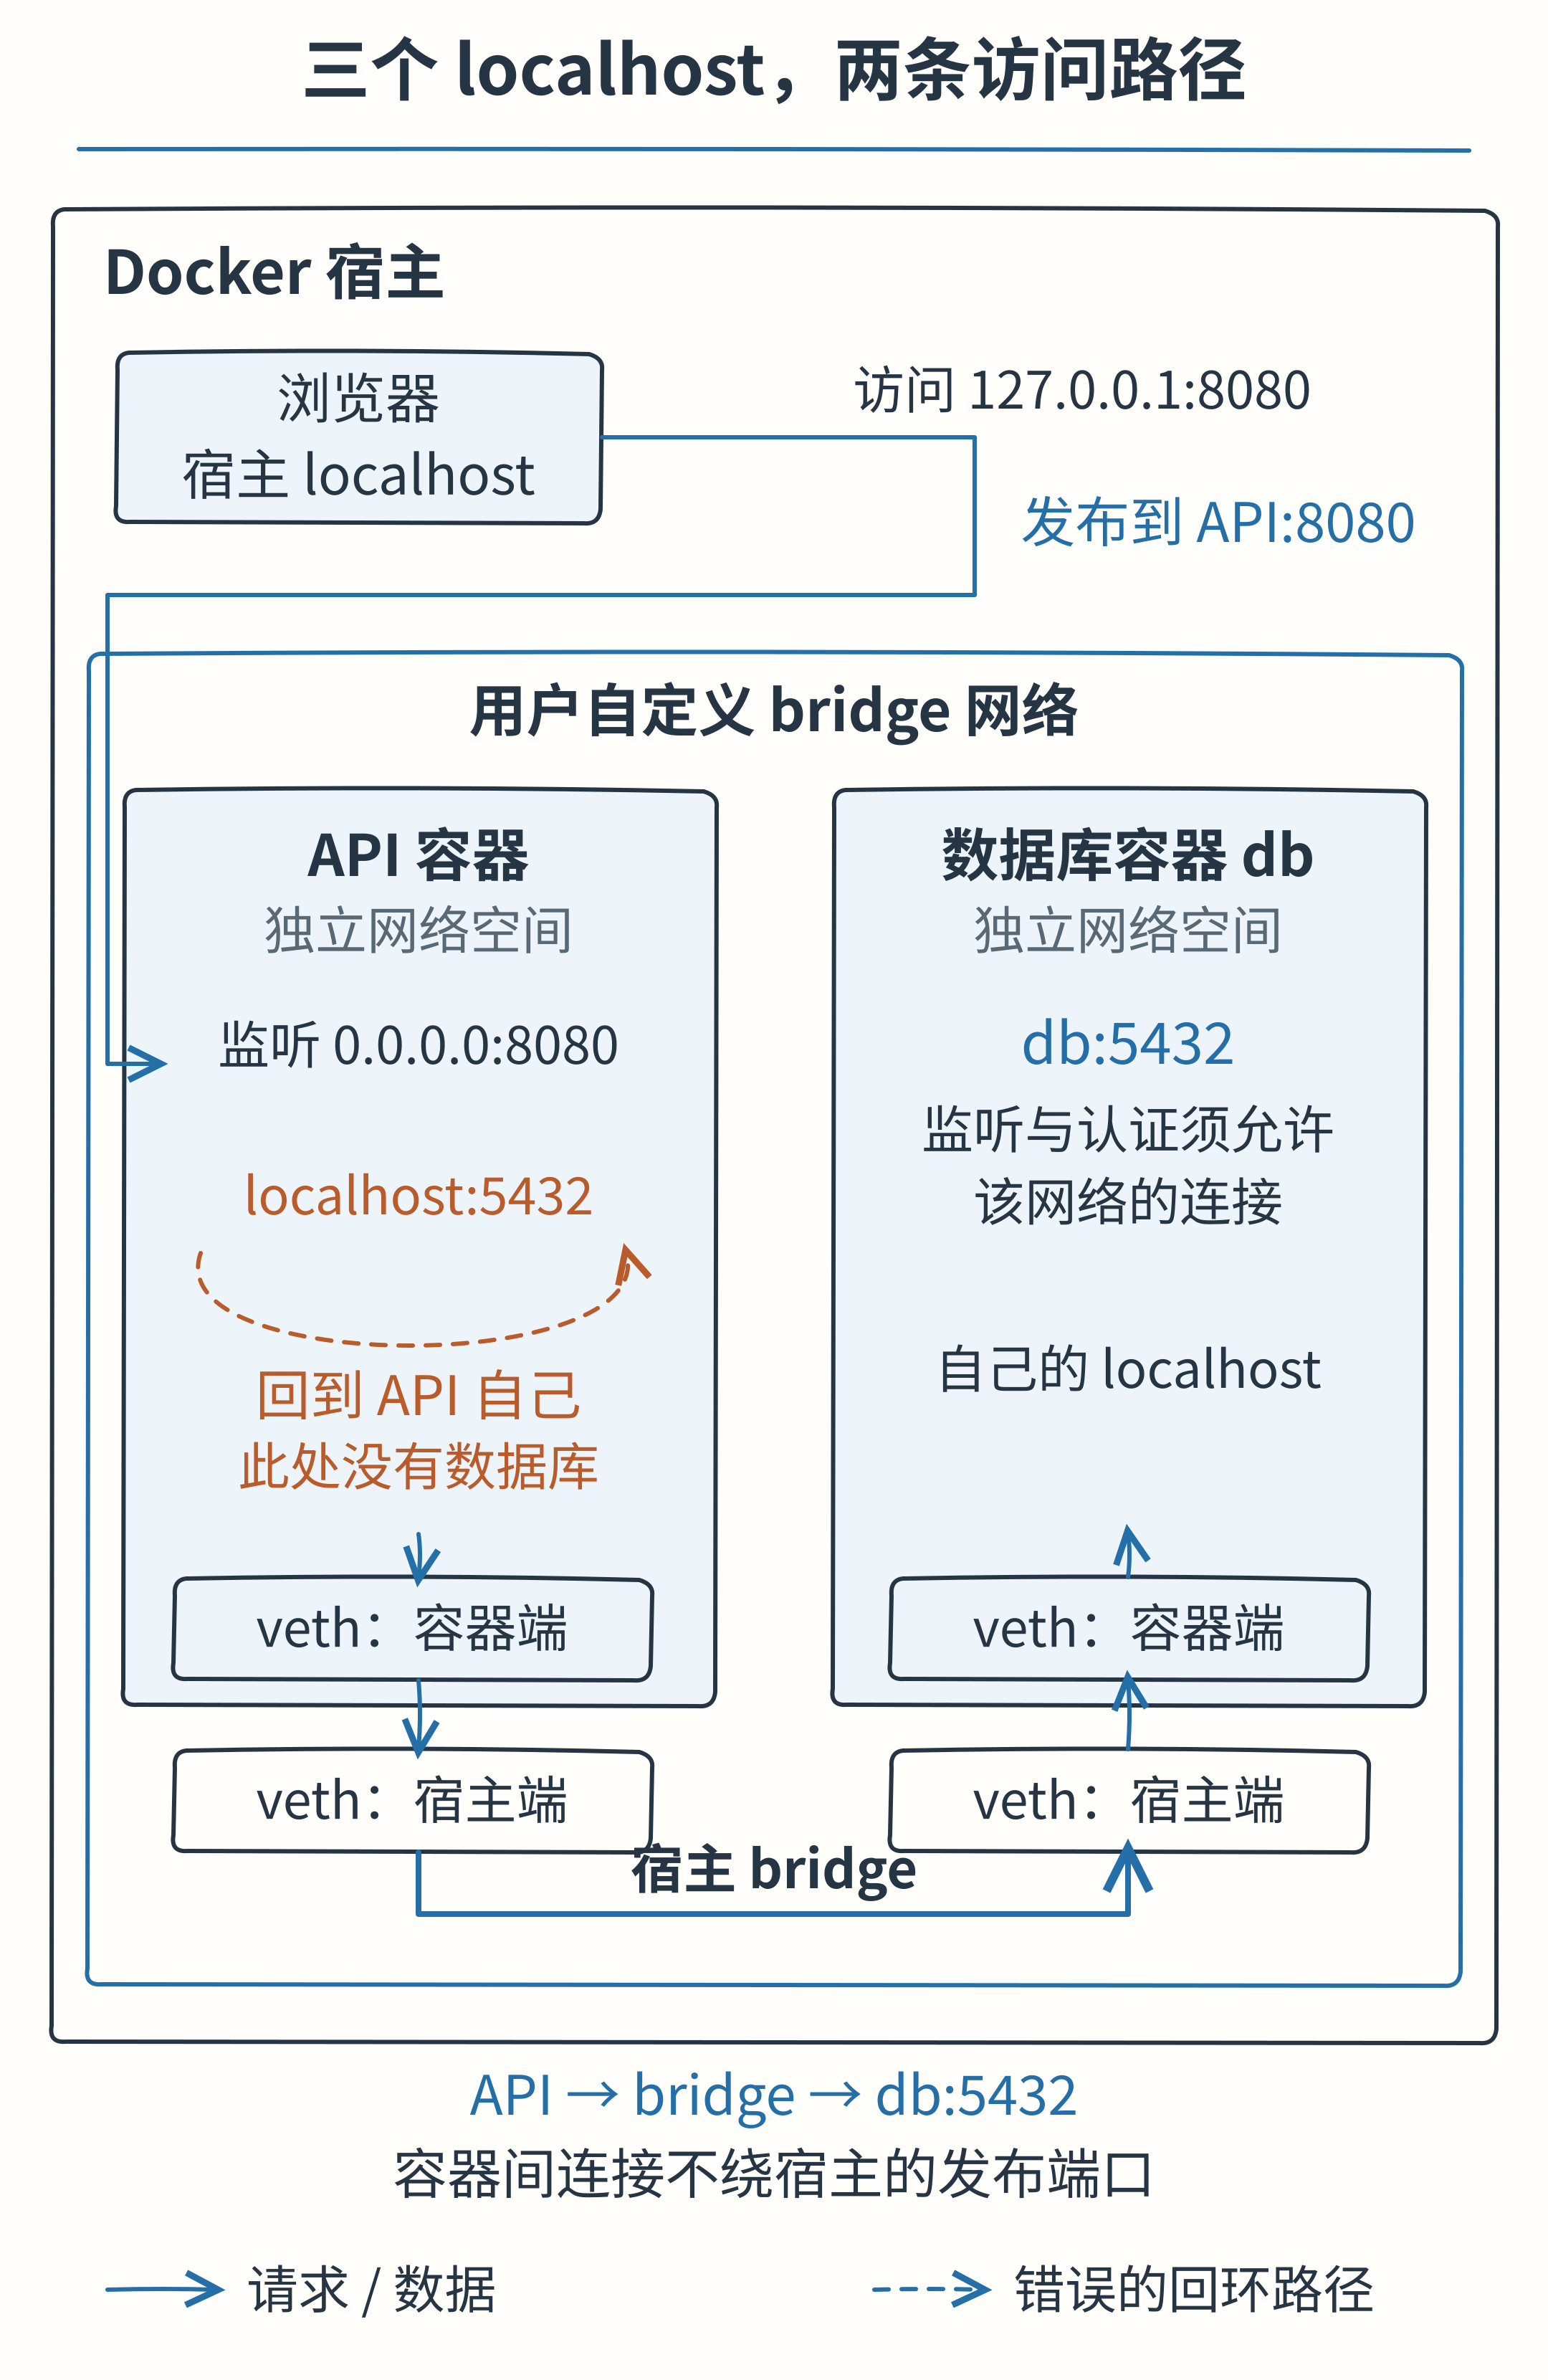
宿主访问 API 经过端口发布,API 访问同一网络中的数据库则使用数据库名称和容器端口。这是普通 bridge 示例,不适用于共享 network namespace 或 host 网络。
容器停止时应用要完成哪些工作
API 上线新版本时,旧实例可能还在写入图片;摘要工作者也可能已经领取任务但尚未提交结果。如果直接强制结束,客户端可能收到半途断开的连接,队列中的任务则可能再次投递。
Docker 停止容器时,通常先向主进程发送 SIGTERM,等待一段时间,未退出再发送 SIGKILL;初始信号和等待时间可以配置。docker stop 行为
主进程在独立 PID namespace 中通常是 PID 1。若启动方式是 shell 包一层应用,信号可能停在 shell,没有传给真正处理请求的进程。Dockerfile 使用 ENTRYPOINT ["/usr/local/bin/notes"] 这样的 exec 形式,可以避免不必要的 shell;必须使用启动脚本时,可在最后用 exec 把脚本进程替换成应用。Dockerfile 的启动形式
PID 1 还涉及子进程回收。应用会产生子进程却不能妥善管理时,可以考虑轻量 init,例如 Docker 的 --init。它帮助管理进程,但不会替应用实现业务收尾。容器中的多进程管理
API 仍需在收到终止信号后停止接受新请求,给在途请求留出有限时间,再关闭连接。摘要工作者应停止领取新任务,并明确未完成任务如何重试。任务重试时避免重复写入结果,要靠幂等设计完成;操作系统信号本身不理解这项业务要求。
把隔离边界写进运行契约
对读书笔记服务而言,镜像路径、监听地址、资源上限、持久化位置和停止行为,都应成为可以审查与验证的运行约定。这样,换机器或替换实例时,团队有条件检查行为是否保持一致。
运行契约也能变成验收条件:上传图片后删除重建 API,确认图片仍能读取;在请求处理中发送停止信号,检查结果和超时;模拟大图片并发,观察内存峰值。测试这些边界,比只检查容器状态显示为运行中更接近用户真正需要的可靠性。
安全还需要额外审视。共享内核、过大的权限、危险的宿主目录挂载,都可能削弱边界。优先使用必要的最小权限,避免为了修复权限报错就打开特权模式,也不要随意把 Docker 管理接口暴露给应用。Docker 安全边界
理解这些机制之后,下一步才是把根文件系统和启动约定做成可靠的镜像。否则,运行环境虽然隔离清楚了,每次构建却仍可能交付不同的依赖和代码。
动手想一想
题目 1
API 和数据库分别运行在两个普通 bridge 容器里。API 的 localhost:5432 连接失败,但宿主机上的数据库客户端能够连接。你会先检查什么?
提示
先确定每个 localhost 所属的网络空间,再区分容器端口与宿主发布端口。
答案
API 的 localhost 通常是它自己。先检查两个容器是否在同一个用户自定义网络,再确认数据库名称解析、监听地址和认证配置。API 应连接数据库的网络名与容器端口,例如 db:5432;宿主客户端连接成功,只能说明宿主侧路径可用。
题目 2
图片写进容器的普通目录。停止后启动同一容器,图片还在;发布时删除旧容器再创建,图片消失。哪个结果符合容器的文件机制?
提示
区分镜像层、原容器的可写层和单独挂载的存储。
答案
两个结果都符合预期。停止不会自动删除原容器可写层,新容器却不会继承旧可写层。应让正式图片使用独立持久存储,并验证删除重建后仍可读取,而不只是验证重启。
题目 3
增加内存上限后,图片处理进程不再退出,但摘要任务延迟仍然很高。为什么还不能断言资源问题已经解决?
提示
考虑 CPU、并发以及多个工作负载共享的资源。
答案
内存上限只处理一个维度。图片处理可能争抢 CPU,摘要任务也可能受到自己的 CPU 配额、数据库或外部服务限制。应结合节流指标、任务排队和请求耗时定位,再调整并发或容量。
参考资料
- OCI Runtime Specification:Linux namespaces
- Docker:What is a container?
- Docker Desktop:Networking
- Docker:Resource constraints
- Linux Kernel:Control Group v2
- Docker:Storage drivers 与分层概念
- Docker:Networking overview
- Docker:Port publishing
- Docker:Stop container
- Dockerfile:ENTRYPOINT
- Docker:Run multiple processes in a container
- Docker:Engine security
- Kubernetes:Pod networking
- Docker:Exec container
- Linux man-pages:setns
- Docker:Runtime metrics
- Linux Kernel:The proc filesystem
- LXC:LXCFS
- Docker:Volumes
- Docker:Bind mounts
- Linux man-pages:veth
- Docker:Bridge network driver
- Linux man-pages:chroot
- Docker:containerd image store