一份中文材料刚好能放进聊天窗口,换成同样字数的产品编号和程序代码,却被提示太长。另一边,模型明明能读出一个英文单词,让它数清里面有几个字母时,反而可能出错。
这两件事都值得沿输入往里查:我们看到的是字、词和句子,语言模型通常先接到一串token编号。切分方式会影响序列长度,也会改变模型直接看到的基本单位。
token常被译成“词元”,但它没有义务遵守语文课的词语边界。一个token可以对应一个词、一个字、词的一部分,甚至一个字符编码中的一部分。理解它,需要把字节、字符和模型的切分单位分开。
1.文字已经有编码,为什么还要切一次
计算机保存文字,需要把文字编码成数值。Unicode给字符分配码点,UTF-8等编码方式再把码点表示成字节。一个字节有8个二进制位,可以表示256种数值;UTF-8使用的字节数随字符而变。Unicode的UTF编码说明
先做一个可以独立核对的比较:“今天下雨了。”、“hello!”、“202610”和“a+=10;”。这四组都由6个普通字符组成,按UTF-8编码,它们分别占18、6、6、6个字节。第一组的5个汉字和中文句号各占3个字节,后三组都是单字节ASCII字符。
这已经证明:相同字符数,不一定有相同字节数。但字节数仍然不能直接当成token数。前者回答怎样存储文字,后者回答模型以什么单位读写文字。表情符号、组合字符等还会让“看起来一个字符”与“一个码点”不再一一对应,本章先避开这些额外情况。
为什么不干脆让每句话都对应一个编号?因为新句子几乎可以无限组合,词表列不完。改成每个完整词一项,会遇到新词、人名、拼写变化和代码标识符。改成细小字符或字节一项,基本单位比较容易覆盖,却会让同一段材料变成较长的序列。
许多分词器选择可复用的片段:常见组合可以整块表示,少见内容可以拆小。神经机器翻译中的子词研究,就是针对罕见词和未见词难以处理的问题发展起来的。子词翻译原论文
2.词表是什么,分词器又做什么
词表可以先理解成一份“单位与编号”的对应表。分词器则包含把输入变成这些单位的规则,以及相关的预处理、特殊标记处理和解码方式。它并非只拿一把剪刀,按照词典把句子剪开。
例如,某个教学词表可以收录a、b、c、ab、abab,并分别给它们编号0、1、2、3、4。输入“abab”时,应该用四个小单位,两个ab,还是一个abab?词表说明哪些单位存在,切分规则才进一步决定选择哪条路径。
有些方法还会先按规则划分空格、字母或数字区域,再在区域内切分。大小写、空格、换行和标点可能改变结果。“相同单词前多一个空格”也可能形成不同的token,不能先把空白当成无关装饰。
尤其要分开两件事:建立分词器时,程序从语料中确定词表与规则;正常使用时,按已经确定的规则编码新输入。今天聊天里出现一个新名字,通常不会让现有分词器立刻为它新增永久词表项。训练分词器与训练语言模型参数,也是两项不同工作。
一些编程语言的处理流程,也会先把源码文字切成token,再交给后续分析。这与语言模型的共同点,是先确定输入单位和边界;切分目的却不同。例如Python的词法分析要识别名称、数字、运算符等类别,本章接下来介绍的BPE子词分词器,则按自己的词表和合并规则组织片段。Python的词法分析说明读者不必先学编程,只要记住:一串token还不是表示运算层级、调用关系等结构的语法树;能把代码切分并送进模型,也没有证明它语法正确或能够执行。Python的语法树说明
3.拿五条字符串,亲手做两轮BPE
先把切分任务的要求放在一起:词表必须有限,遇到新字符串仍应尽量能够表示,常见片段又不宜总占很多位置。这些要求彼此牵制;增加词表项能缩短部分输入,却扩大模型要存储的表示表。BPE是在这种取舍下寻找可复用片段的一种方法,不是直接学习词义。
BPE是常用的一类子词方法。它从小单位出发,反复寻找出现较多的相邻单位对,把选中的组合加入词表。下面使用完全公开、可手算的教学材料,不是真实模型的分词实测。Hugging Face的分词算法说明
材料只有两种字符串:abab出现3次,abac出现2次。初始单位是a、b、c;我们只统计每条字符串内部的相邻关系,不把两条材料的末尾与开头接在一起。
先看abab,每条有两个a+b和一个b+a。重复3次,分别贡献6次和3次。再看abac,每条有a+b、b+a、a+c各一次;重复2次,各贡献2次。合起来,a+b出现8次,b+a出现5次,a+c出现2次。
第一轮选择最多的a+b,把ab加入词表。原来的abab变成[ab,ab],abac变成[ab,a,c]。五条材料原先一共4×3+4×2=20个token;现在是2×3+3×2=12个。
第二轮必须对新的单位重新计数。此时ab+ab出现3次,ab+a出现2次,a+c出现2次。选择ab+ab,把abab加入词表。材料变成[abab]重复3次、[ab,a,c]重复2次,总数为1×3+3×2=9个token。
最后词表有a、b、c、ab、abab,共5项。同样4个字符,abab只需1个token,abac需要3个。词表大小从3增到5,整批材料的token数从20减到9:这是两种不同的“数量”,一增一减并不矛盾。
看图1时,特别留意第一轮之后的重新计数:第二轮的单位已经变成ab,不能继续沿用字母阶段的频次。
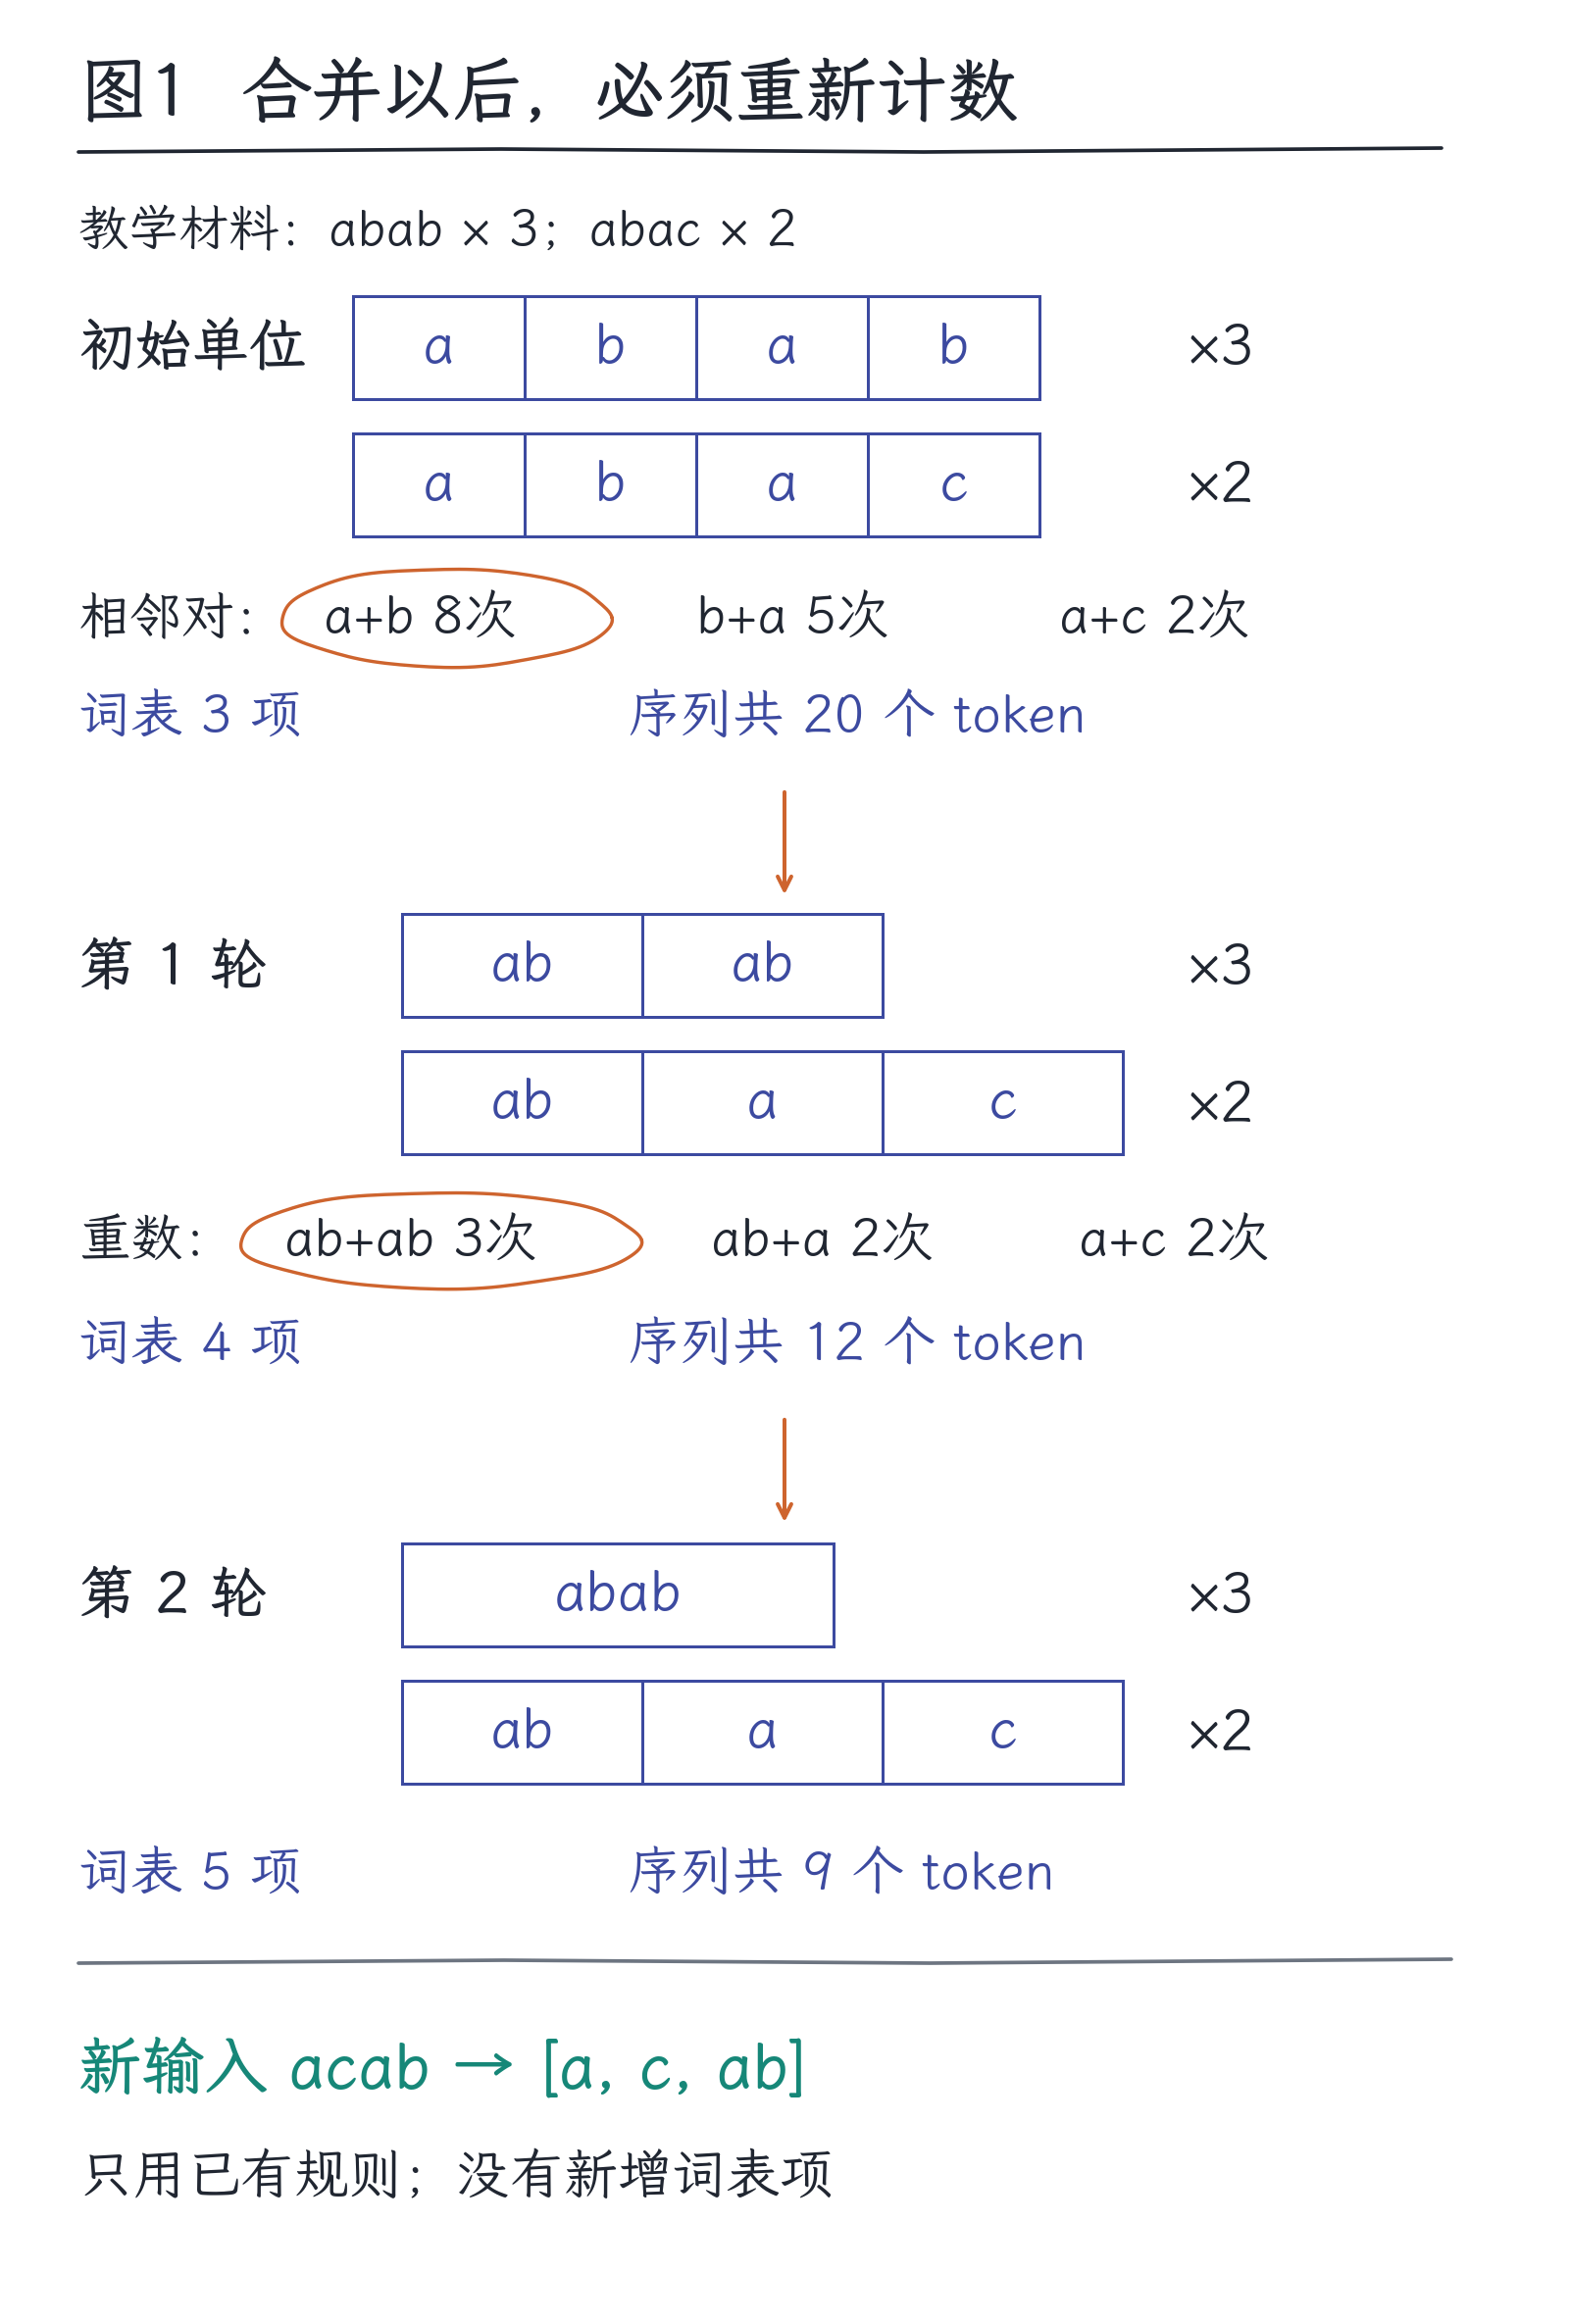
图1|教学构造的两轮BPE,不是真实模型的分词实测。训练材料为abab出现3次、abac出现2次;只合并每条字符串内部的相邻单位。词表从3项增到5项,同一批材料的token总数从20降到12,再降到9。
再输入没有在材料里出现过的acab。先按a、c、a、b拆开,再用已经学到的a+b规则,得到[a,c,ab]。新字符串没有整项出现在词表里,仍然可以被已有片段组合表示。
我们刻意省略了真实实现里的预切分、边界标记和大量合并步骤。实际BPE要遵循已有的合并优先级,也不保证找出的切分就是任何意义上的全局最少token方案。只在纸上挑“看起来最长的词”一路切下去,不能保证复现一个真实分词器。
4.为什么半个汉字也可能成为一个token
刚才的教学例子从字母开始。字节级BPE则以字节为基础,再合并常见字节序列。若基础字节集合完整,原始文本就能在最细处退回字节表示,避免单纯因为某个完整词不在词表中就无法编码。
一个汉字的UTF-8编码可能占多个字节。合并规则可能把这些字节放进一个token,也可能只合并其中一部分。因此,单个token对应的字节片段未必能独立显示成一个完整字符;按正确顺序把整串片段接起来,才可能恢复原来的文字。
拿“中”做一个字节级实物例。它的Unicode码点是U+4E2D,UTF-8字节依次为十六进制E4、B8、AD。人为把它们切成[E4 B8]与[AD]两块,第一块缺少最后一个字节,第二块只是续接字节;单独按严格UTF-8解码,两块都不是完整字符。按原顺序合并为E4 B8 AD,就能还原“中”。
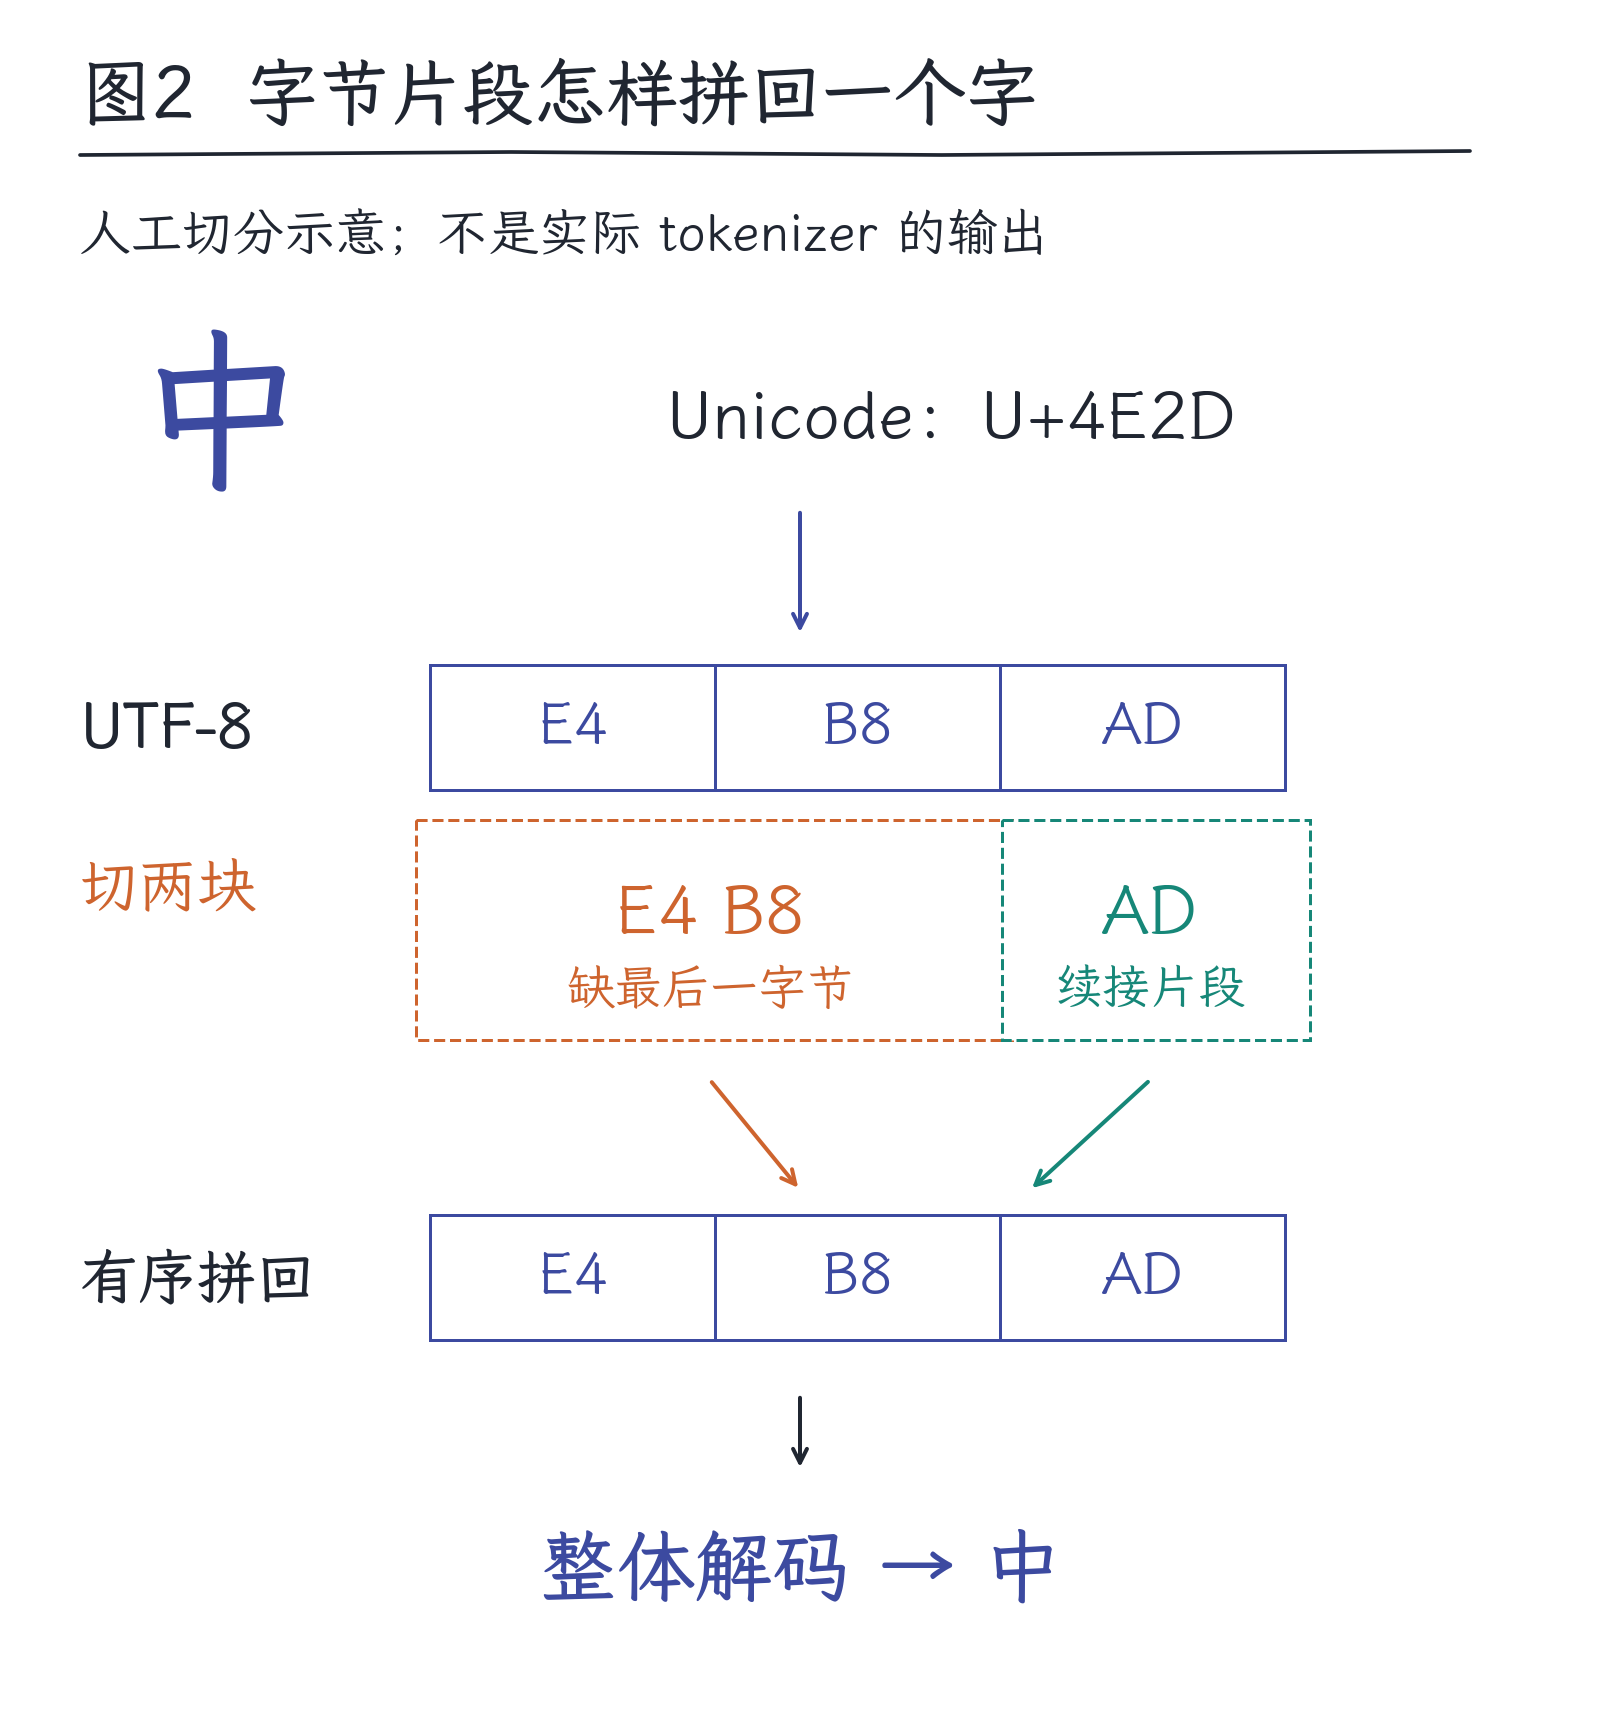
图2|人工切分示意,不代表任何真实tokenizer的输出。“中”的UTF-8编码是三个字节;任意片段未必能独立解码,完整有序字节串才能恢复字符。图中两块没有被分配虚构的真实token编号。
这里的“能编码”与“懂意思”相隔很远。一个新发明的名字能够被分解,不代表模型知道它指谁。切分再高效,也不会自动带来缺失的事实知识。
不同方案在规范化上还有差别。某些处理会统一部分字符形式,或按配置省略特殊标记,所以不能无条件宣布所有分词器都能逐字节还原任意原始输入。判断可逆性,要看完整的编码和解码流程。
回到开头四组6字符材料:中文、英文、数字、代码各占多少token,必须选定具体分词器与版本才能回答。我们已经算出的18、6、6、6是字节数,不能顺手填进token栏。这里保留这个空白,比写一个貌似精确的通用换算更有用。
5.真实对话还藏着角色与边界
模型需要区分哪些文字是用户说的,哪些是助手之前的回答,哪里开始一条消息,哪里结束。对话模板负责把结构化消息整理成模型熟悉的序列,特殊token可以承担其中一些边界标记。Transformers的对话模板说明
看一个固定版本的公开案例:Qwen官方Qwen2.5-0.5B-Instruct仓库中,提交a8b602d的分词配置把消息起始标记<|im_start|>对应到151644,把消息结束标记<|im_end|>对应到151645。配置还给出了对话模板,普通用户消息的基本结构是“起始标记、user、换行、消息正文、结束标记、换行”。Qwen官方配置
请注意,user是角色文字,不必因为它承担角色含义,就把这个单词本身叫作特殊token。特殊标记的可见拼写看起来有许多字符,在匹配的编码流程里却可以对应一个专用编号。正文仍要按该词表切分;本例没有给“你好”编造实测token数。
图3把“专用边界编号”与“仍需普通编码的内容”分开画出。它描述序列结构,不能拿可见标记的字符数估算最终token数。
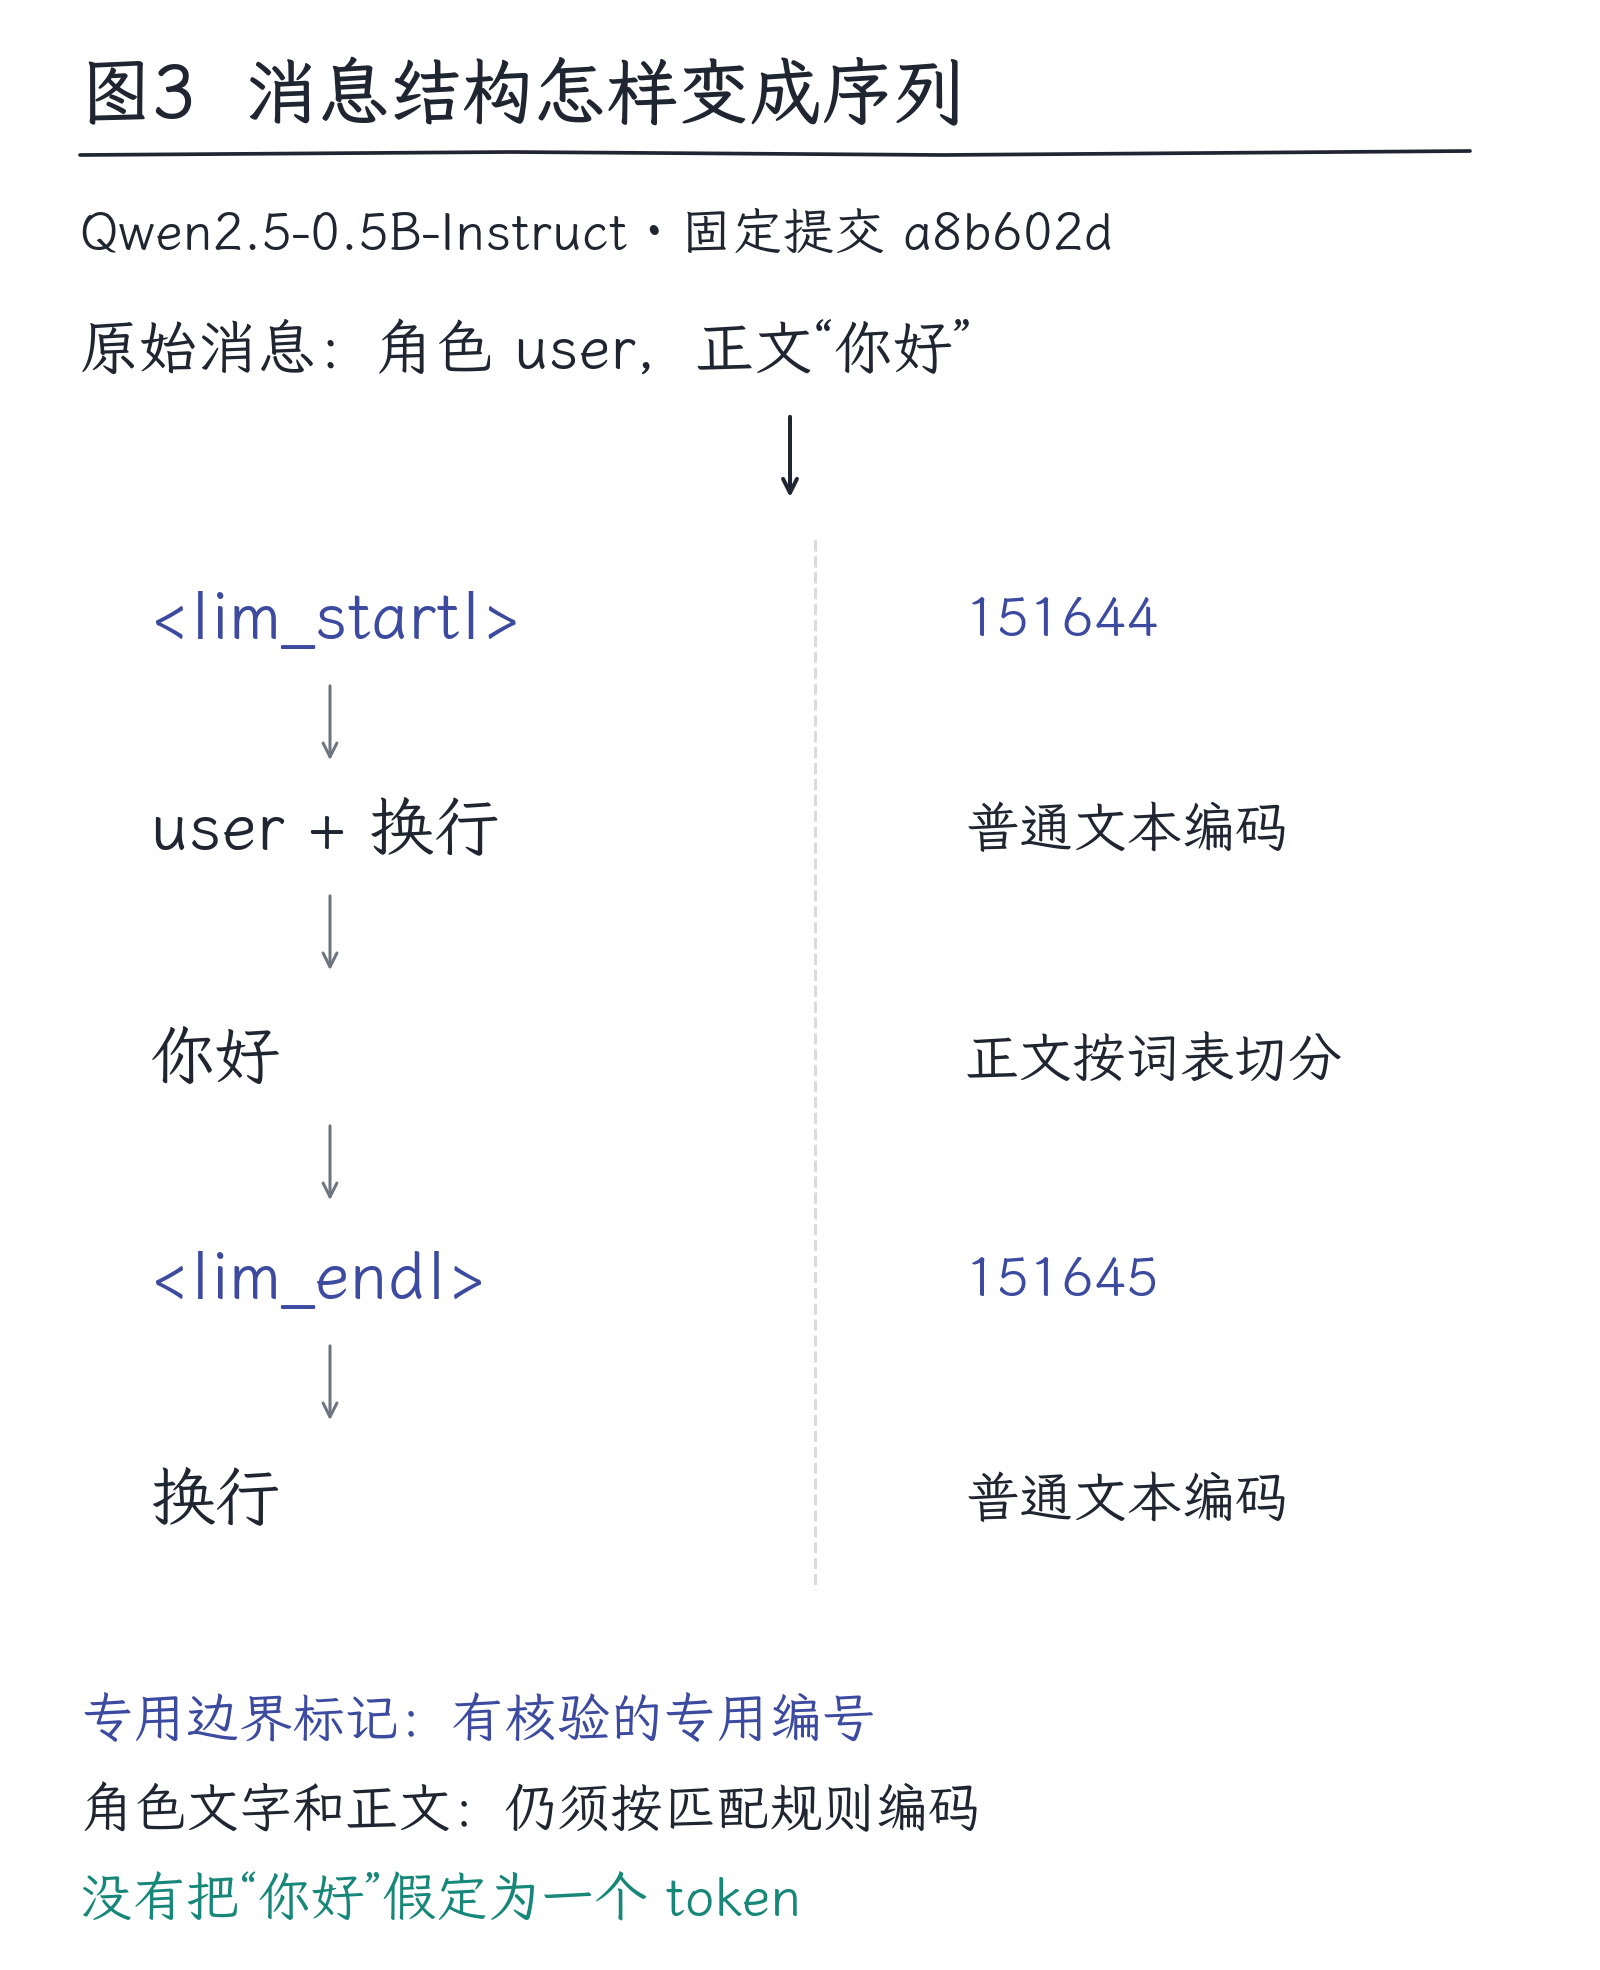
图3|Qwen2.5-0.5B-Instruct固定提交a8b602d的一条普通用户消息结构。起始、结束标记分别对应151644、151645;user、换行和正文按匹配的编码规则处理,图中没有假定它们各占一个token。
这只是完整对话中的一条消息。实际模板还可能放入系统说明、其他历史消息、工具定义和提示助手开始作答的前缀。用户框里看见的字数,不能完整反映最终输入长度。换模型时也不能随意沿用另一家的模板,否则模型接收到的角色和边界可能偏离训练时的格式。
角色标记帮助模型辨认结构,却不是独立的安全锁。外部资料里的文字仍可能诱导模型;系统需要另外控制权限、验证工具请求,不能指望只加一个边界标记就解决所有安全问题。
6.编号为什么不能直接拿来算含义
回看Qwen的两个特殊编号,它们只差1,并不表示两种含义在某条语义尺子上只差一个单位。教学词表里ab编号为3,也不意味着它比编号为0的a“重要三倍”。
编号首先是身份索引。相同编号在另一份词表里可能指向完全不同的片段,所以模型与分词器必须匹配。只替换词表而不处理对应的模型参数,会让已有的编号与所学表示错位。这像读取一种序列化协议:字段位置与编号的意义必须由接收方按同一套约定解释。序列长度相同,仍不足以证明两套编码兼容。
此外,顺序不能丢。[a,c,ab]和[ab,c,a]包含相同的片段,却是不同字符串。模型需要利用有顺序的输入,再经过后续计算得到与上下文相关的表示。
分词器解决了怎样把文本映射到有限单位的问题,但没有直接解决语义怎样表示。编号如何变成能够参与乘加计算的向量,是下一章的主题。
7.token数量的代价,至少有三笔账
第一笔是上下文空间。假设一个教学系统给一次交互分配8192个token的总预算,输入与预留输出都要从中占位置。说明、历史及模板开销用1000,当前问题用200,检索资料用5000,预留回答用1500,合计7700,余量只有492。
再加入1000个token的附件片段,总数变成8700,超过预算508。把资料从5000压到4000,总数则为6700,余量增加到1492。这个算例没有对应某个型号的窗口规格;实际服务还可能分别规定输入上限、输出上限,并对工具、图片或推理相关token采用不同计数规则。
看图4时,所有长度都共用8192的总尺子;空白余量也是预算的一部分。预留输出虽然尚未生成,也必须先占住计划中的位置。
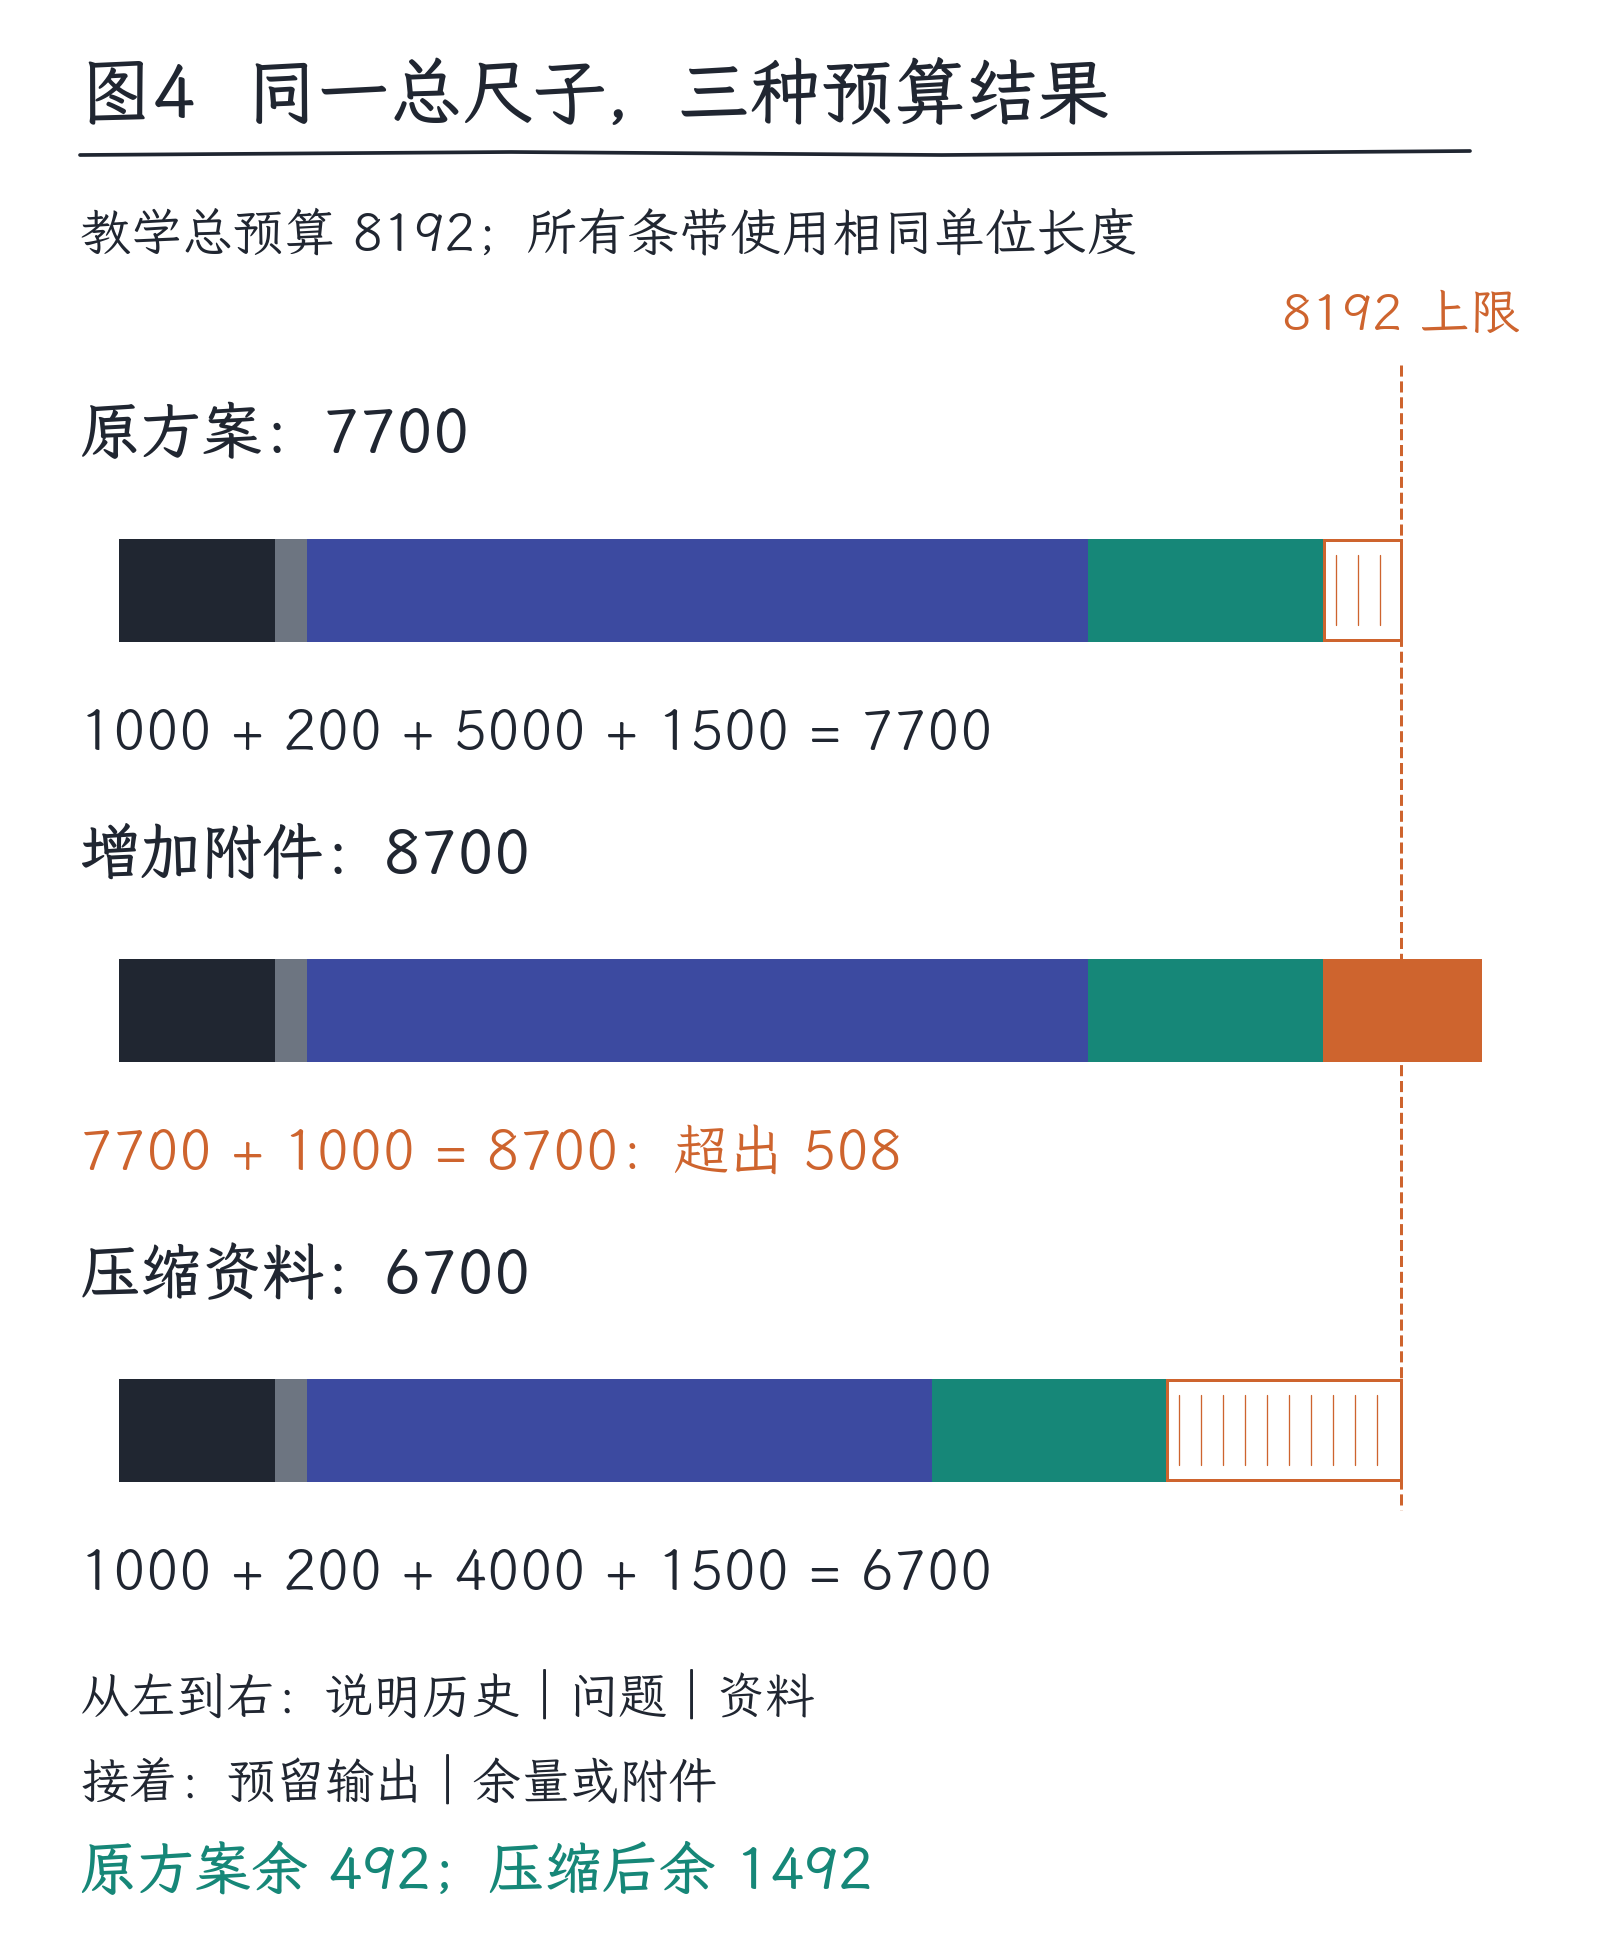
图4|假设的8192-token总预算:说明和历史1000、当前问题200、资料5000、预留输出1500,共7700,剩492。再加1000会超出508;把资料缩短1000后,余量变成1492。各段宽度按实际数量绘制,不对应任何型号的窗口规格。
第二笔是计算与等待。模型要处理输入序列,生成时还要不断追加新token。较长的序列通常带来更多计算和缓存需求;较多的输出token,也意味着更多生成步骤。但不能直接把“两倍token”说成“两倍耗时”,硬件、批处理、缓存和模型结构都会参与决定。
第三笔是使用费用。按token收费的服务可能把输入、输出和缓存分开计价,还可能另收工具费用。看见一个字符数,既不能直接算token数,也不能直接算金额。为资料去重、保留相关片段,往往比盲目扩大输入更值得先做;但删掉关键限定条件,也可能让答案变差。
8.词表越大,是不是就越划算
较大的词表能容纳更多长片段,可能缩短某些文本的序列。不过,每个词表项需要相应的表示资源,输出层也要处理候选单位,词表并非越大越好。
用一个只看表示表的教学数字体会:若每个单位对应16个数,1000项需要16,000个数,2000项需要32,000个数。增加词表项,可能省下序列位置,却要付出另一侧的存储与计算成本。真实模型维度和输出层设计不同,这个比例不能直接当成整机成本比例。
语料分布也会影响哪些片段值得合并。对一种语言或某类代码很省token的词表,换到另一类文本未必仍然高效。评价分词器要结合覆盖性、压缩效率与下游任务表现,不能只拿一句话的token数量排名。
字母计数也是类似边界。如果一个单词被合成较大的token,模型并未在输入层天然得到“每个字母一个位置”的表示。它仍可能学会拆解和计数,但不能把读起来熟悉当作计数准确的保证。要求精确字符统计时,确定性程序通常更容易核对。
本章练习
题目
问题1|执行既有合并规则
使用本章教学分词器:先按字符拆分,再按a+b→ab、ab+ab→abab的既有优先级处理。把acab编码成token序列,并说明是否需要新增词表项。
问题2|分清两种数量
词表有a、b、c、ab、abab共5项。输入6个连续的c,token序列有多长?为什么它可以长于词表项数?
问题3|安排一次输入
8192的教学总预算中,说明和历史1000、问题200、预留输出1500保持不变。把资料从5000减到4000后还剩多少?若再加入1000的附件,是否装得下,最终剩多少?
问题4|恢复一个字符
“中”的字节被人工切成[E4 B8]和[AD]。应怎样恢复文字?为什么分别解码两块可能失败?
思考提示
提示1|对应问题1
先寻找相邻a与b;只有相邻的两个ab才能触发第二条合并。
提示2|对应问题2
列出实际占用的位置,再数不同单位的种类。
提示3|对应问题3
先把固定开销与新资料相加,算余量后再加入附件;预留输出仍计入总数。
提示4|对应问题4
UTF-8判断字符是否完整,依靠整串字节的结构;先保留片段的顺序。
参考答案与解析
答案1|对应问题1
acab先成为[a,c,a,b],第一条规则得到[a,c,ab],第二条不再适用。共3个token,无需新增词表项。它可以被表示,仍不代表模型知道这个字符串的含义。
答案2|对应问题2
序列为[c,c,c,c,c,c],长度6。词表大小统计可用种类,序列长度统计本次用了多少个位置;同一项可以重复。
答案3|对应问题3
压缩后共1000+200+4000+1500=6700,剩1492。加入附件后共7700,仍装得下,剩492。这个结论只适用于本题约定的总预算口径。
答案4|对应问题4
先按顺序拼成E4 B8 AD,再按UTF-8解码得到“中”。第一块尚缺续接字节,第二块缺少起始部分,单独都不是完整字符。这个人工切分不宣称真实分词器也会这样切。
下一章
到这里,一句话已经变成有顺序的编号。但编号的大小没有语义刻度,模型又怎样比较、组合和利用这些单位?下一章从一张小小的查找表开始,看token怎样变成向量,向量又怎样进入矩阵计算。