假设屏幕上只有一句没写完的话:“这杯饮料是……”后面可以接“茶”,也可以接“水”。如果模型只交出一个词,我们知道它选了什么,却不知道它是遥遥看好这个词,还是几个候选几乎打平。
上一章,文字已经变成可以计算的向量。本章再往前走一步:模型怎样把向量变成候选分数,怎样把分数整理成概率,又怎样在看到实际答案后评价这次预测。
先记住一个界限:下一token的概率,说的是模型在这个位置怎样分配候选可能性。它不能直接当作整句话的事实正确率。我们会用同一组小数字,把这两件事分开。
1.输出端先得到分数,还没有得到概率
经过一系列计算,模型会得到表示当前上下文的一组数。具体计算结构留到第06、08、09章。这里先接上上一章的矩阵直觉:用不同的权重组合当前表示,就可以为不同候选分别打分。
某个候选的这个原始分数叫logit,多个分数合称logits。分数可以为负、为0,也可以大于1,不要求相加等于1。它们表达的是在同一次预测中候选之间的相对倾向。
例如某次计算得到[2,1,0]。你不能说第一个候选“有200%的概率”,也不能直接除以总和3就算完成转换:若分数是[2,−1,0],那样会产生负概率。
为什么不直接只留下第一名?因为第一名的信息太少。[2,1,0]与[2,1.99,1.98]都有同样的第一名,但第二组几乎没有拉开差距。保留全部候选的相对分量,才能更细致地评价预测,也给后面的生成方法留下选择空间。
从“为每个候选打分”走到“得到一组概率”,常见的做法叫softmax。
2.softmax把一组分数变成总和为1的分配
softmax可以分成两步:先对每个分数做指数运算,得到正数;再把每个正数除以它们的总和。PyTorch的softmax定义
没学过指数函数也可以继续。把exp看成计算器上的一个转换键即可:分数越大,结果越大,而且结果始终为正。它有两个适合演示的值:exp(0)=1,exp(ln 2)=2。ln是自然对数,ln 2约为0.693,与exp互为相反方向的运算。
下面只模拟输出端,人为规定它的完整教学词表,只有“茶”“水”“汤”三个token。给定“这杯饮料是”这个前缀,安排分数为[ln 2,0,0]:
- 茶:指数后为2,除以总和4,概率为0.50
- 水:指数后为1,除以总和4,概率为0.25
- 汤:指数后为1,除以总和4,概率为0.25
0.50+0.25+0.25=1。注意,这三个候选构成整个教学词表,并非从真实模型的巨大词表里只摘出前三名。真实输出若还有其他候选,只看前三名,它们的概率一般不必加起来等于1。
现在同时给三个分数加1。指数后的结果变成[2e,e,e],e约为2.718;除以总和4e后,概率仍是[0.50,0.25,0.25]。共同提高分数,并没有改变它们的相对关系。实现中也常利用这种性质控制数值范围。
这个性质还给出一项具体的数值实现检查。若分数为[1000+ln 2,1000,1000],直接求指数会得到极大的数,可能超出机器所用数值格式的范围。先从每项减去最大值1000+ln 2,就得到[0,−ln 2,−ln 2];指数变成[1,0.5,0.5],仍算出[0.50,0.25,0.25]。数学上保留同一个分配,程序却避开了不必要的巨大中间数。SciPy的softmax实现就明确使用平移来避免溢出。这是在检查计算是否稳定,不能由此保证模型的预测内容正确。softmax的数值实现说明
还可以直接比较两项的比例。它们共用同一个分母,约掉后得到:pᵢ÷pⱼ=exp(zᵢ-zⱼ)。其中z是原始分数,p是转换后的概率。茶比水高ln 2,所以茶的概率恰好是水的2倍。共同加1没有改变分数差,比例也就不变。
这解释了softmax为什么适合表达相对分数:它给出正的份额,让总和为1,并让分数差控制相对比例。这些性质帮助理解这种设计,但不是在证明满足这些基本要求的变换只能是softmax。
但只提高“水”的分数,就会改变所有候选的份额。它自己的分子变了,大家共用的分母也变了。因此,softmax中的候选彼此竞争;不能把每一项当作一场互不相关的独立投票。
图1把同一个分母4保留在所有候选下面。指数运算保证权重为正,除以共同总和才把它们变成一次分配。
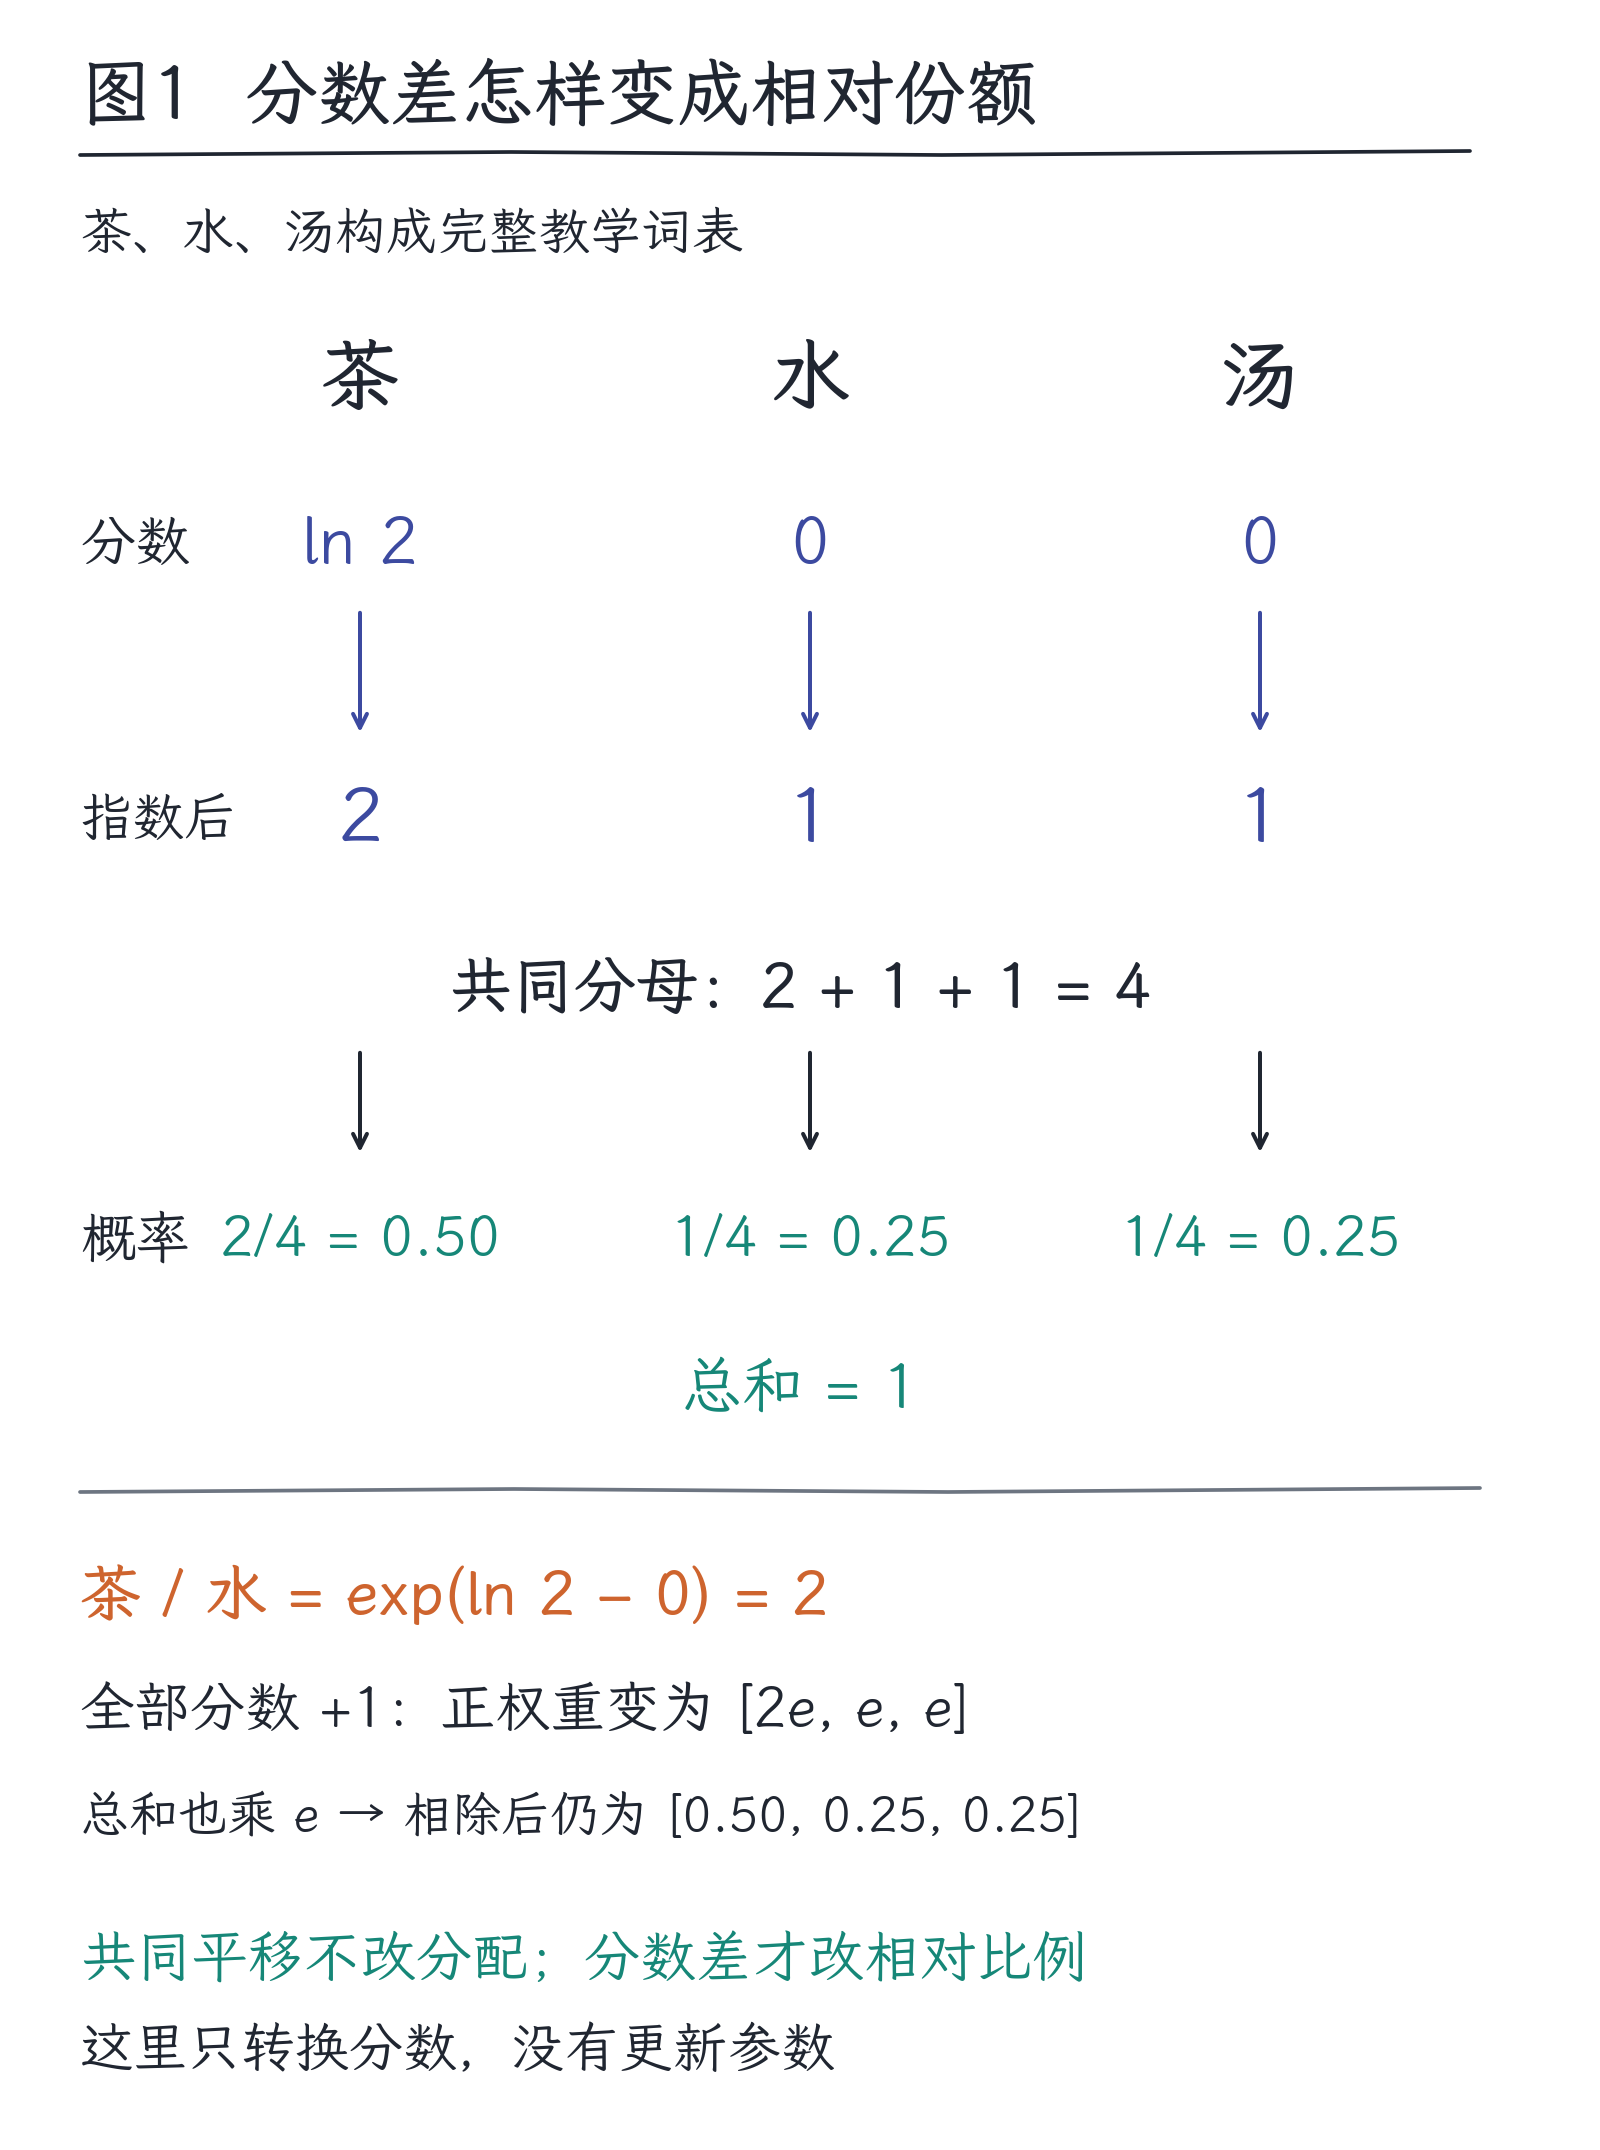
图1|三项构成完整教学词表。分数[ln 2,0,0]先变成正权重[2,1,1],再除以总和4,得到[0.50,0.25,0.25]。茶与水的概率比为2;共同平移全部分数不会改变分配。
3.概率前面,永远有一个“在什么条件下”
刚才的0.25应该完整读成:在给定前缀和当前模型参数的条件下,模型给下一个token“水”分配0.25的概率。
可以写成P(水|这杯饮料是)。P代表概率,竖线右边是已给定的条件,左边是要预测的结果。这里仍然是模型的预测分布,不等于世界已经保证了这种频率。
换成“瓶里装的是纯净”,候选之间的倾向可能不同。输入中增加一条说明、换一种表达、加入前面对话,都可能改变条件,继而改变输出。参数不更新,也可以发生这种变化。
一段文字会把这个过程重复许多次。先预测一个token,再把已经出现的token纳入下一次条件。某条具体续写路径的概率,是沿途各步条件概率相乘。例如一条两步路径,第一步概率0.5,第二步在第一步已发生的条件下概率0.4,路径概率就是0.2。
第二步的0.4只属于那条前缀路径,不能换成另一个前缀的概率来相乘。这里也没有假设两个token互相独立;恰恰相反,条件里保留了前面的信息。
本篇先不决定如何从分布中选词。永远选第一名,或者按概率抽取,属于生成策略。得到分布和作出选择,是相邻但不同的两个步骤。
4.实际目标出现以后,怎样评价预测
回到[茶0.50,水0.25,汤0.25]。假设已有文本在这个位置实际写的是“水”,它就成为这个样本的目标token。
自然语言中,“茶”也可能是合理续写。这个样本记录了“水”,本次评分就以“水”为目标,并没有宣告其他续写永远不合法。许多样本共同提供信息,才有机会反映多种表达的分布。
只看是否命中第一名,会把“水只有0.25”和“水已经升到0.49、仍略低于第一名”都记成错误,丢掉很多变化。我们需要一个更细的评价:模型究竟给实际目标留了多少概率?
先明确目标:希望模型给观察到的目标文本更高概率。一段文本的概率是各步条件概率的乘积,取对数就能把乘积改写成逐位置的和;再加负号,“让概率尽量大”就对应“让这份损失尽量小”。单个位置的常见办法因此写成负对数损失:
损失=−ln(分给实际目标的概率)
“损失”在这里就是一个越小越好的评价数。ln是前面见过的自然对数,前面的负号让0到1之间的概率转换成非负惩罚。这个变换还给低概率目标更重的代价,下面几组计算器结果能显示它的尺度:
- 目标概率0.90,损失约0.105
- 目标概率0.50,损失约0.693
- 目标概率0.25,损失约1.386
- 目标概率0.01,损失约4.605
给目标的概率越低,惩罚越大。尤其当模型几乎排除一个实际发生的目标时,损失会很大。概率趋近0,损失没有固定上限;概率趋近1,损失趋近0。
图2的横轴是分给实际目标的概率,纵轴是损失。看同样大小的横向移动在曲线两侧产生多大的纵向变化,就能看出负对数并不是把错误简单计成一次。
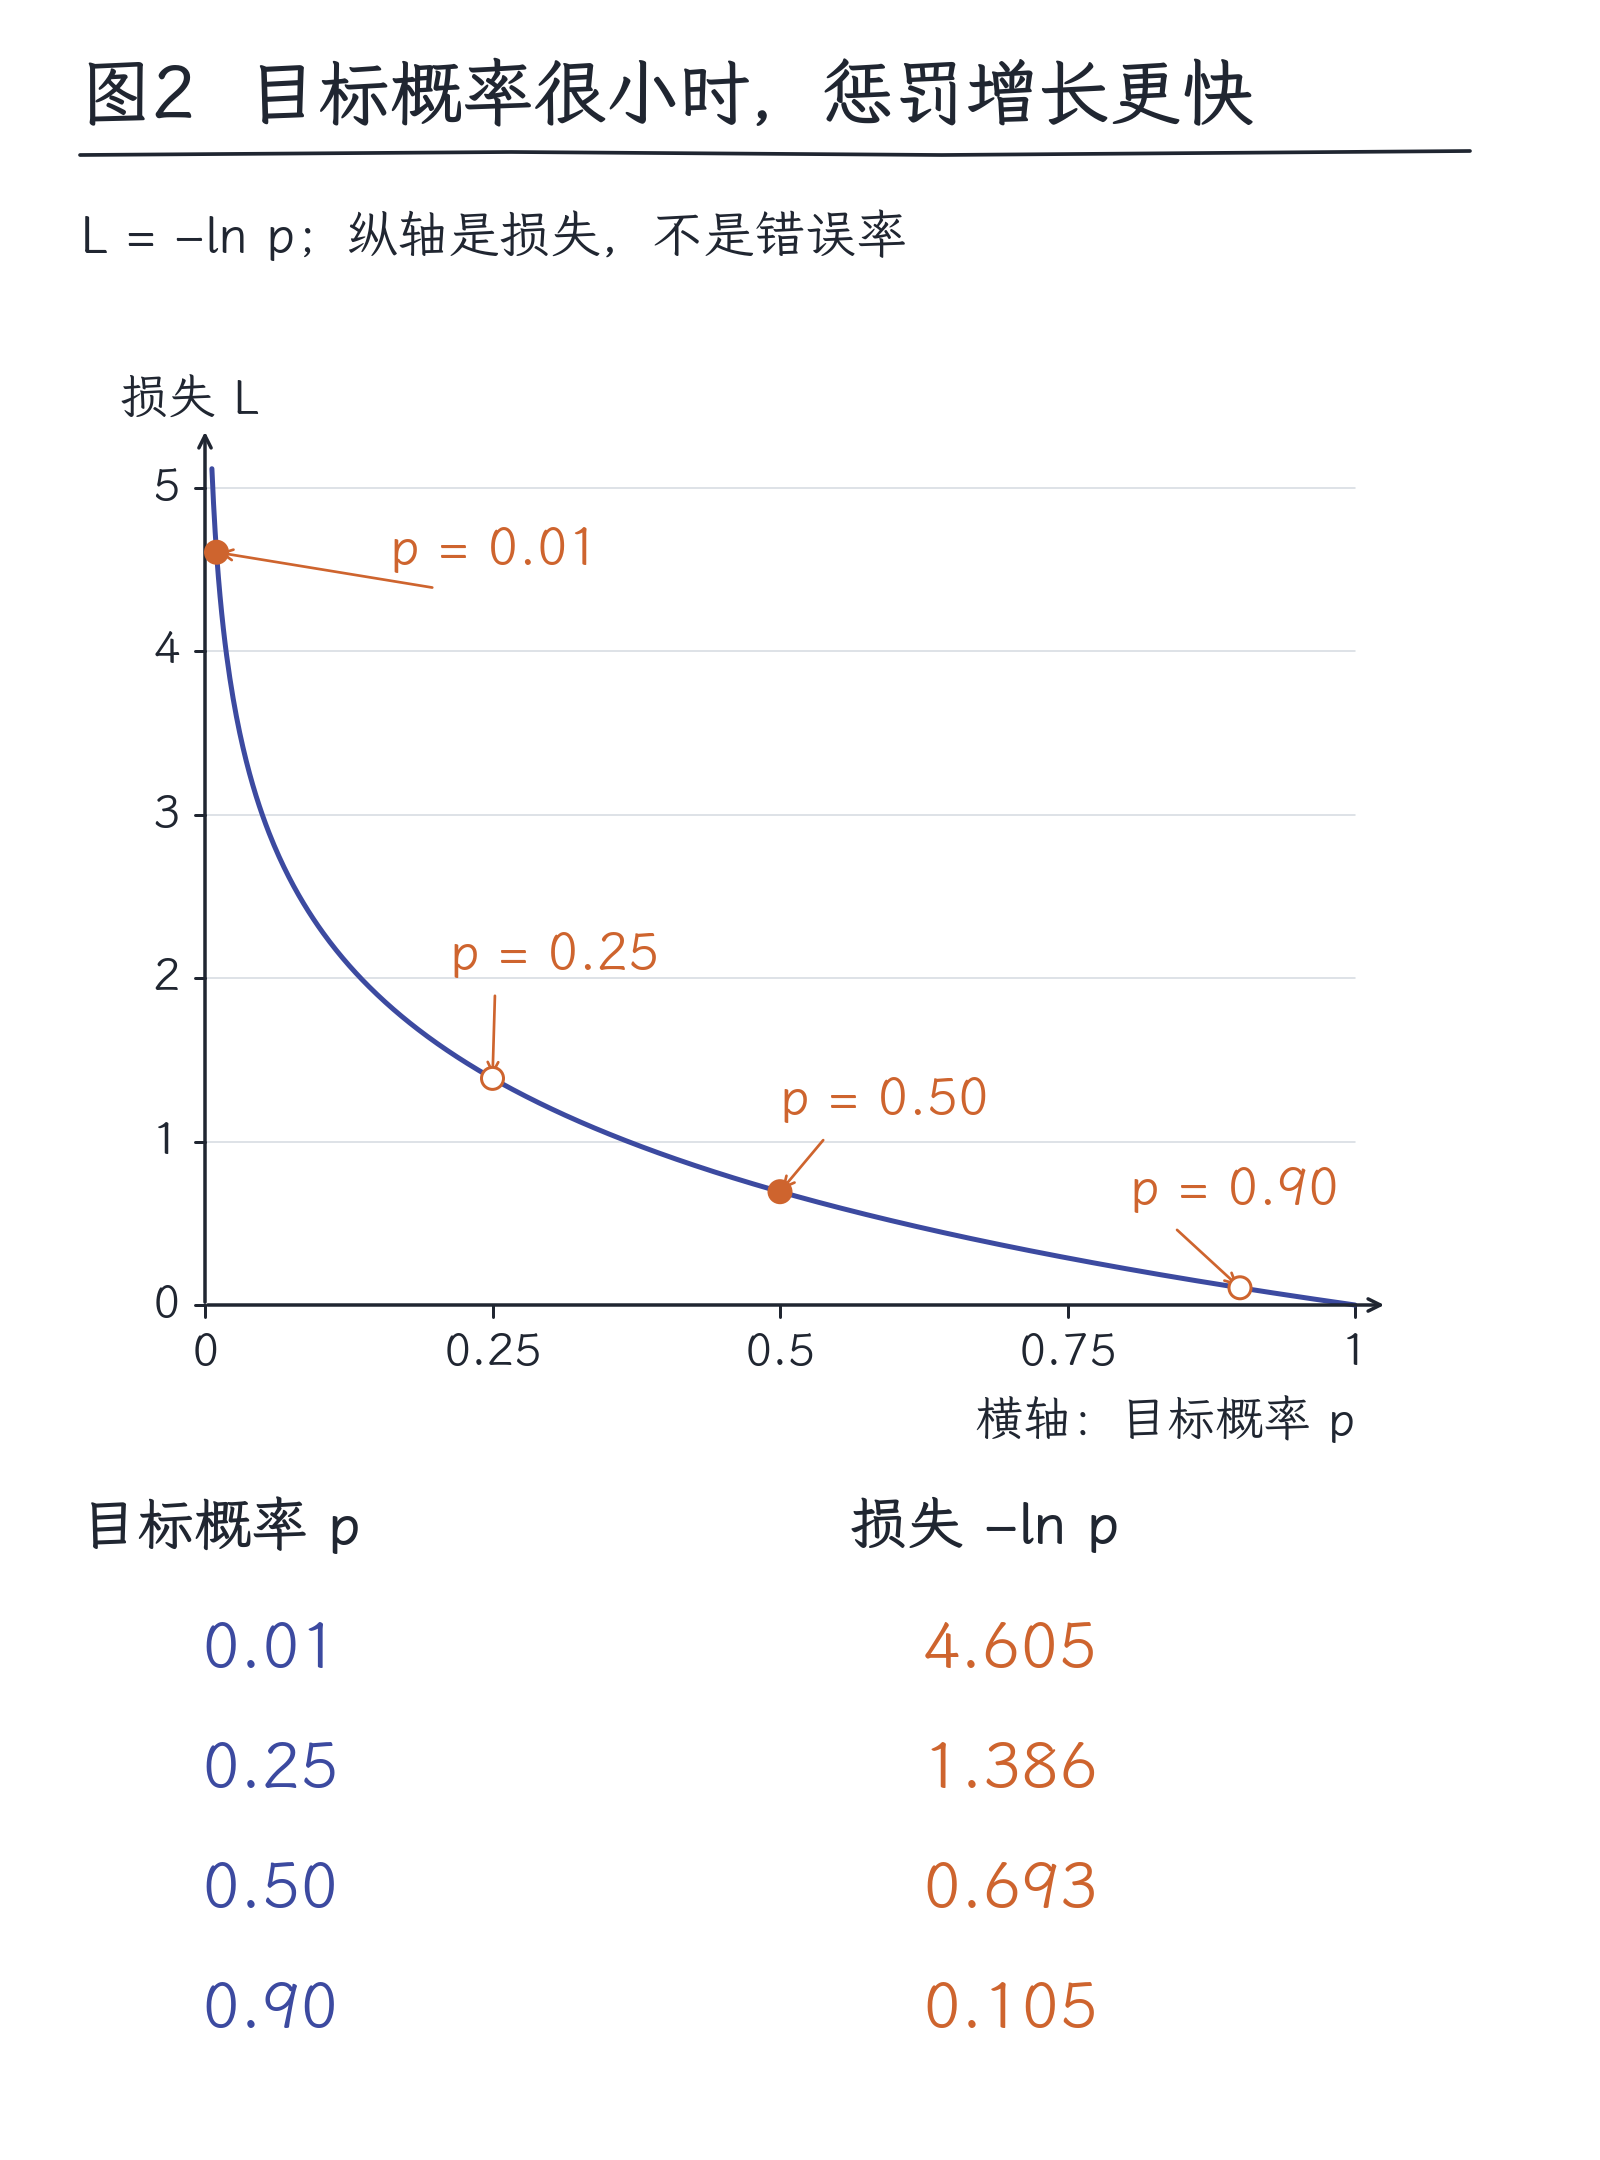
图2|L=−ln p的真实函数曲线,标出p为0.01、0.25、0.50、0.90时的损失。目标概率越接近0,惩罚增长越快;p=0不在有限曲线上,损失趋于无穷大。纵轴不是错误率。
对每个位置只有一个目标token、没有额外权重或标签平滑的常见设置,这就是相应的交叉熵损失。看到“交叉熵”时,现阶段可以先把它落实成“取目标概率,再算负对数”。PyTorch的交叉熵定义
只取目标那一项,是否意味着其他候选完全没影响?并不是,因为目标概率的分母包含其他候选。其他候选分数升高,目标份额可能下降,损失随之变大。
如果第二套预测是[0.25,0.50,0.25],目标仍为“水”,损失从约1.386降到约0.693。这个教学对比只说明第二套预测更看好本样本的实际目标,还不能证明某个模型整体更好。
5.为何用对数,一段文本又怎样汇总
对数还有一个方便的性质:它把概率连乘变成数值相加。刚才两步路径的概率是0.5×0.4=0.2,对应负对数约1.609;两步损失分别约0.693和0.916,相加同样约1.609。
这样,一段文本可以按位置逐个评价,再把损失加起来。不必等模型生成完整答案,也不必每次抽签选中目标,才能知道它给目标分配了多少概率。训练或评估已有文本时,常在各位置提供该文本的真实前缀,再检查下一个真实token。
文本越长,直接相加通常会积累更多项。因此,报告中也常用被计入位置的平均损失。上面两步的平均值约为0.805。它与总损失1.609表达的范围不同,比较前必须先确认分母。
这里还能看出负对数如何处理“很自信地错”。两组教学预测给两个位置各自实际目标的概率,分别为[0.9,0.1]和[0.5,0.5]。两组的目标概率平均数都是0.5,但平均负对数损失分别约1.204和0.693。第一组把其中一个实际目标压得很低,受到更大惩罚。
这不是要求所有预测都变得平均。若两个位置的实际目标各得到0.9,平均损失就只有约0.105。关键是让概率分配与实际出现的目标相符,而不是单纯追求“更敢下结论”。
6.在公开模型里找到同一条计算路径
这条路线可以对应到Qwen3的公开实现。Transformers的Qwen3文档把logits说明为softmax之前、面向词表中各token的预测分数,并把loss说明为下一token预测损失。Qwen3模型接口文档
实现中,当前表示先经过输出映射,得到词表分数;提供目标标签时,再调用损失函数。对应的因果语言模型损失把目标错开一个位置,使“前面的token”用来预测“后一个token”,然后计算交叉熵。输出端实现、下一token损失实现
这也解释了为什么阅读实际代码时,可能看不到“先保存全部概率,再逐项取对数”这几个分开的步骤。成熟实现可以直接从logits算交叉熵,把相关运算合在一起,获得更好的数值稳定性。概念上的路线相同,不要求程序一定用同样数量的中间表。
这些公开材料支持的是计算接口与目标的解释。本章的小数值仍是教学安排,不能读成Qwen3对上述句子的实测输出。损失算出来以后,怎样据此修改参数,是第07章的问题;仅仅计算损失,并不会自动改变模型。
7.熵低,只说明分布更集中
现在看另一组分布:[茶0.90,水0.05,汤0.05]。它明显比各占三分之一更集中。衡量这种分散程度的一个量叫熵。
熵的计算是:每项概率乘上自己的负对数,再把所有项相加。它只看分布本身,不需要知道实际目标。使用自然对数时,刚才的集中分布熵约为0.394;三项均匀分布的熵约为1.099。熵的定义与单位
两个教学样本可能碰巧得到相同的集中分布。在样本甲里,实际目标是“茶”,损失约0.105;在样本乙里,实际目标是“水”,损失约2.996。分布相同,熵就相同,但损失相差很大。
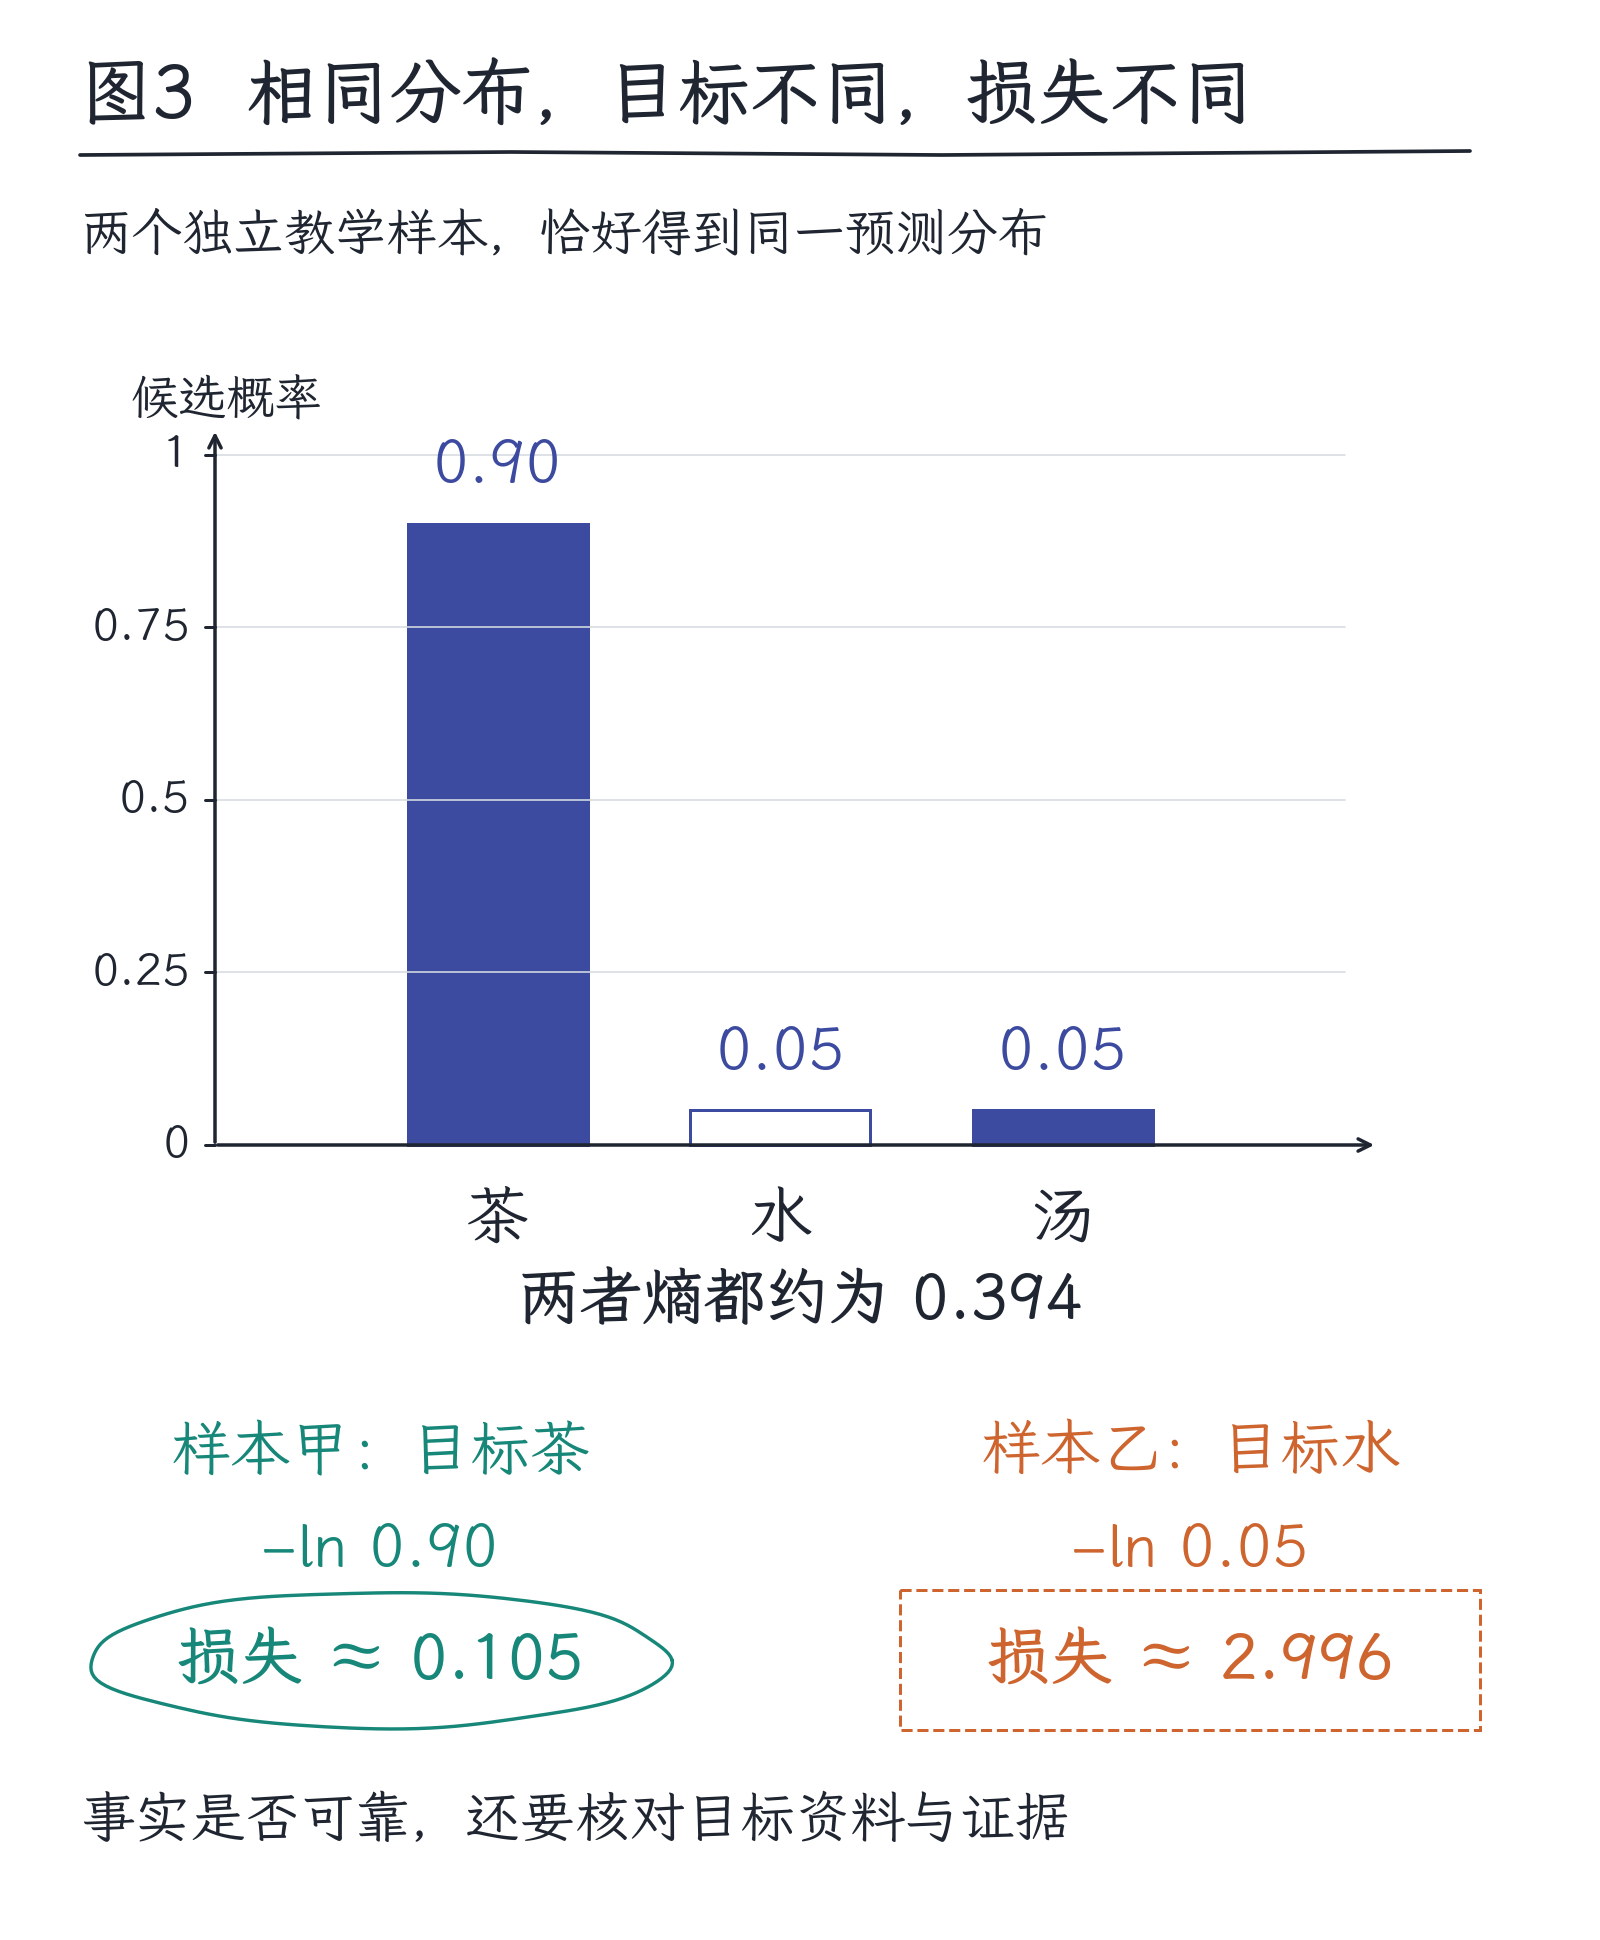
图3|同一个集中分布,在不同教学样本上可以得到小损失或大损失。熵只由预测分布决定,损失还需要实际目标;事实可信度则需要另外的证据。
更重要的是,低损失也只相对于所用目标而言。如果目标文本写错了日期,模型很擅长预测那个错误日期,仍可能得到较低损失。目标来自什么资料、是否可靠,是评价之外必须追问的问题。
反过来,高熵也未必意味着模型无知。一道开放写作题可能允许多种合理措辞;多个同样合适的下一token会分走概率。答案正确性还可能跨越许多token,不能只看某个位置的集中程度。
因此,“模型分布很集中”“模型符合这份参考文本”“答案有可靠事实依据”,需要三种不同的证据。
8.损失很好用,但比较时要先对齐条件
平均损失降低,通常说明模型更会预测这份数据中的token。但如果评估文本就是它反复看过的训练文本,它也可能只是更熟悉这些样本。有没有把这种能力带到新问题上,需要额外检验。
不同分词器把同一句话分成不同数量和种类的token,每token平均损失便不天然可比。是否计入提示词、是否忽略填充位置、是否只评价回答部分,也会改变分母和任务难度。没有这些条件,一个孤立的损失数字很难说明多少事情。
即便条件一致,日常任务也可能重视损失没有单独突出的细节。一份通知摘要只错一个会议日期,对用户已经很严重;大量常见词预测正确,可能使整体平均数仍然漂亮。因此要同时检查日期、金额、证据忠实度等真正关心的结果。具体做法可以是:先规定输出日期必须与通知原文一致,再逐条核对这一字段。平均损失是可计算的训练评分,日期一致则是应用的验收条件;前者改善不能替后者作答。
损失给学习过程提供细致、可计算的目标;应用评价还要回到“这件事究竟做对了没有”。两者相互补充。
本章练习
题目
问题1|从相对分数构造概率
完整教学词表只有茶、水、汤。把分数设为[ln 2,ln 2,0],求softmax分配;再给全部分数加5,分配怎样变化?
问题2|从两步概率算到损失
同一条目标路径第一步概率0.5,第二步在正确前缀下概率0.4。求路径概率、总负对数损失与每位置平均损失。
问题3|把三种证据分开
两个样本的预测分布都为[茶0.90,水0.05,汤0.05];甲的目标是茶,乙的目标是水。比较它们的熵与损失。如果甲的目标文本写错了事实,低损失还能说明什么?
思考提示
提示1|对应问题1
先做指数运算,再算共同分母;共同平移会使各正权重乘上同一个因子。
提示2|对应问题2
先相乘求路径概率;对数把连乘改为相加,平均时按2个位置分。
提示3|对应问题3
熵遍历分布全部候选;损失取实际目标那一项;事实核对要回到目标资料。
参考答案与解析
答案1|对应问题1
正权重为[2,2,1],总和5,概率为[0.4,0.4,0.2]。全部加5后,正权重与总和都乘exp(5),相除后概率不变。
答案2|对应问题2
路径概率为0.5×0.4=0.2;总损失为−ln 0.2≈1.609,也等于−ln 0.5−ln 0.4;平均损失约为1.609÷2=0.805。这使用沿同一目标路径的条件概率,没有假设两个位置互相独立。
答案3|对应问题3
两个分布相同,熵都约0.394。甲的损失为−ln 0.90≈0.105,乙为−ln 0.05≈2.996。甲的低损失说明模型较好地预测了这份目标文本;若文本事实有误,它仍不能证明答案真实。
下一章
现在,预测已经有了一把尺子。但“这份练习做得越来越好”,距离“遇到没见过的问题也会做”,还差一个重要判断。下一章讨论拟合、泛化与数据分布:我们该把哪些题留出来,才能检验模型真的学会了什么?