把一张桌面照片发给模型,问“杯子在电脑哪一侧”,它可能立即回答。但照片不是一句藏起来的中文,也没有天然带着“杯子”“电脑”“左边”的文字标签。图像首先是一大组像素数值,模型需要把它们变成能学习、能交互的表示。
本章沿着像素、图块、视觉表示、图文对齐和语言回答走一遍。我们会在纸上切一张小图,再区分CLIP这类图文匹配模型与能对话的视觉语言模型。先修是向量、注意力和预训练,不需要图像处理或编程基础。
1.一张图进入系统之前,可能已经改变了
普通彩色图像可以理解成一个长方形网格,每个位置记录红、绿、蓝三个通道的数值。宽度W、高度H的图,在这种表示下有W×H×3个通道数;W、H分别是横向和纵向像素数量,不是物体数。
接收图片的系统通常还要解码文件、调整尺寸、裁切、归一化或拆成多个视图。归一化是按指定规则调整数值尺度,便于模型处理。JPEG文件大小、原始像素数、进入模型的视觉token数是三个不同量,不能互相代替。
假如原图有一行极小文字,缩小时几个笔画合成一个模糊点,后面的语言模型再强,也不能保证恢复原信息。补出一个符合语境的字,与从图中辨认出那个字不是同一件事。
所以看视觉错误时,先检查模型实际获得了什么:完整图还是局部裁切,原比例还是被拉伸,分辨率多高。用户眼里的原图清晰,不代表系统送给视觉编码器的输入仍保留了全部细节。
2.patch:把像素网格变成一串局部输入
一种常见路线是将图像切成固定大小的小块,称为patch。每块的像素数被展开、投影成向量,再交给Transformer处理。Vision Transformer原论文系统展示了这种把图块作为输入单元的方法。ViT原论文
切块不等于先识别物体。一个杯子可能跨过四块,一块也可能同时装着杯沿、桌面和阴影。patch是按几何位置分出来的计算单位,不是人工划好的语义器官。
做一个教学实验:在纸上画8×8格灰度图,每格只记一个亮度数,再按2×2格切块。横向8÷2=4块,纵向也四块,总共16块。给块行标A、B、C、D,块列标1、2、3、4。
把像素行与列都从0数到7。在第3、4行和第3、4列组成的四格中画一个小方形。它虽然只有2×2像素,却跨过B2、B3、C2、C3四个patch,因为正好压在切块边界上。不要把四块误认成四个物体。
每个灰度patch有四个输入数。为看清“投影”,暂时手工定义一个二维变换:第一维是四格总和,第二维是上排之和减去下排之和。小块[1,0;0,1]得到[2,0];小块[1,1;0,0]得到[2,2]。
第一维相同,第二维不同,说明向量可以保留某些形状差别。但这个手写变换会丢信息:多个不同小块可能映射为同一个向量。真实模型的投影通过训练学习,维度和计算也复杂得多,不是预先给每一维命名为“猫耳朵”“杯把手”。
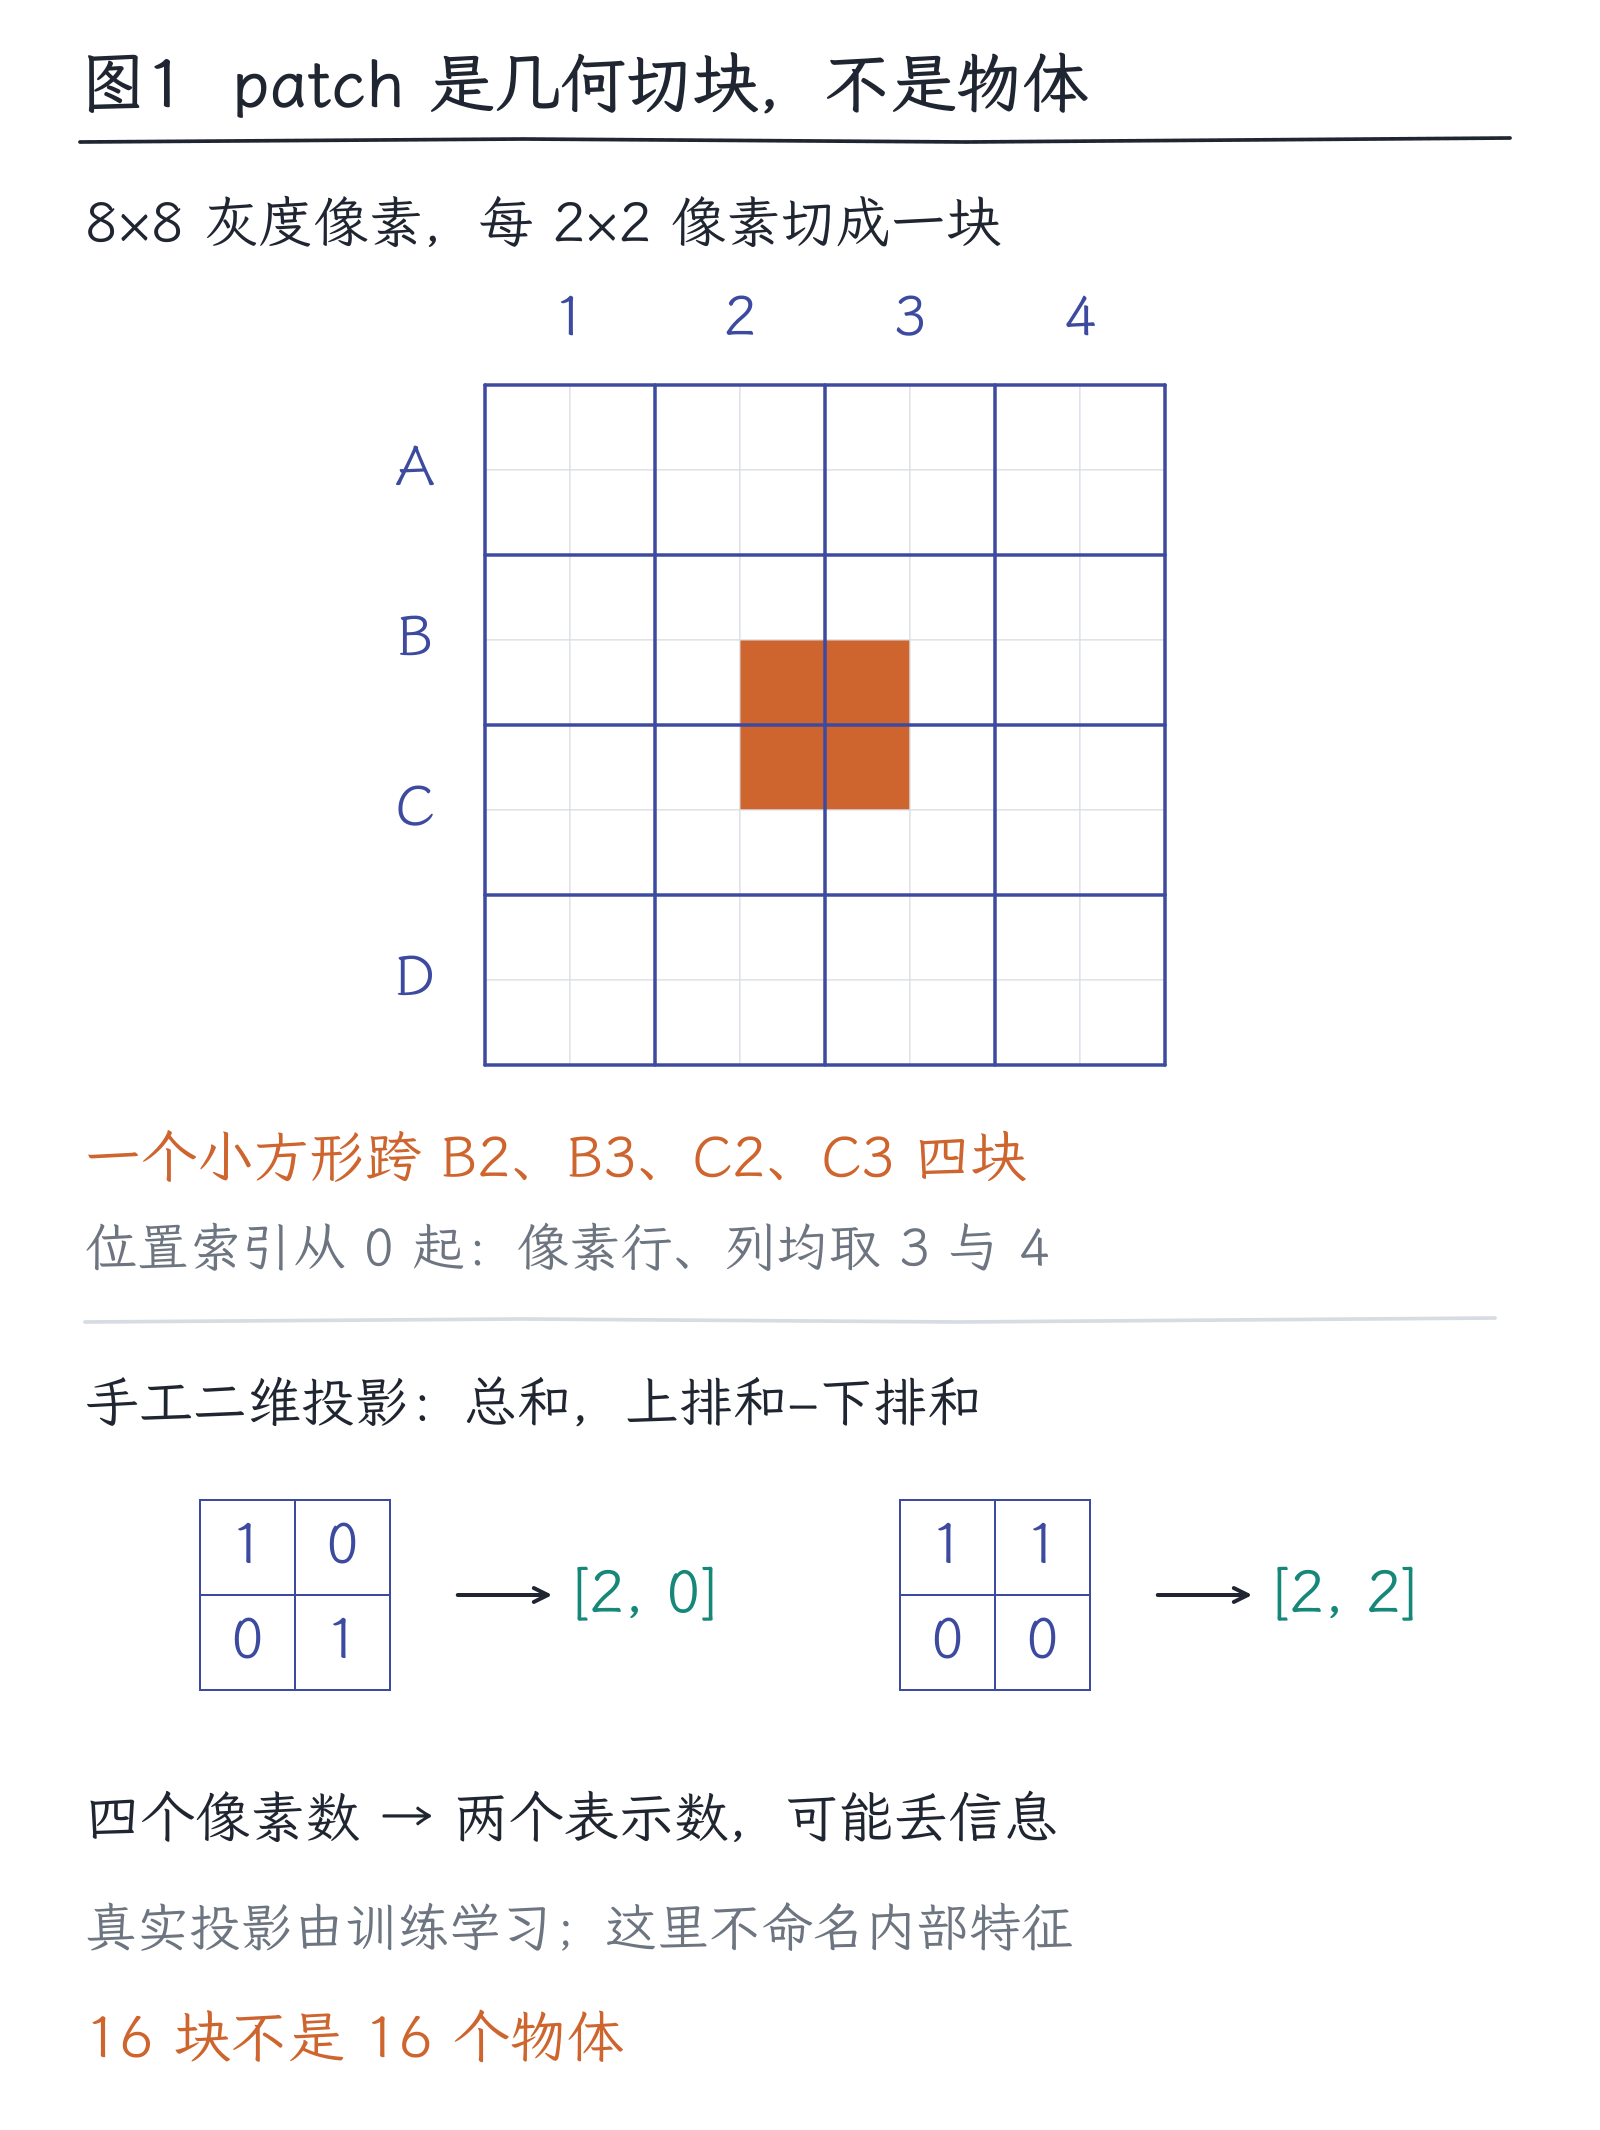
图1|8×8灰度图切成16块,小方形跨过四块;再展开两个2×2小块的投影计算。图上的二维坐标和手写投影都是教学示意,不代表某个真实模型的内部特征。
对彩色2×2图块,原始输入则有2×2×3=12个通道数。图块变向量之后,我们关心的是向量数量与宽度,而不是它在原图里看起来占几厘米。完整视觉编码器还会继续改变这些表示。
3.位置和注意力:局部数值怎样组成整体
若只把16块看成一个没有位置的集合,模型很难区分“杯子在电脑左边”和“电脑在杯子左边”。视觉系统因此需要某种空间位置信息,可能通过位置编码或其他结构提供;具体方法不能从“采用Transformer”这句话唯一推出。
编码器中的注意力让各块读取其他块的信息。一开始某块只包含局部像素,经过多层交互后,它的向量可以携带更广范围的上下文。B2里的半截边缘,可以与B3、C2、C3中的轮廓一起参与识别;切块并不必然让边界永久割裂。
把原图的宽和高各放大两倍,而patch大小仍为2×2,块数就从16增到64。全局注意力若让每块与每块比较,一层的匹配对从16²=256增至64²=4096,是16倍,而非4倍。这只算匹配对,不是整机耗时的精确倍数。
这解释了几种常见取舍:缩小图像能省资源,却可能损失小字;局部窗口让相近块先交流,减少部分全局计算;把多个邻近表示合并,缩短送进语言模型的序列,但也可能压掉细节。它们处理的是不同位置的成本,不能统一称为“图片压缩”后就不再区分。
还要区分编码器输出与语言模型输入。有的系统保留许多空间特征,有的提取一个整图向量,有的先合并再传入。一个“视觉token”通常是一条视觉表示,不必对应文本词表中的某个编号,也不一定对应一个固定大小的原始patch。
4.图文对比学习:怎样知道两种表示应该靠近
设训练数据是一批图文配对:一张狗的照片配“草地上的狗”,一张猫的照片配“窗台上的猫”,一张自行车照片配“停放的自行车”。图像编码器把图变成向量,文本编码器把说明变成另一组向量。
再将两组向量映射到可比较的空间,用相似度计算每张图与每段文字的匹配程度。以归一化向量的点积为例,图像向量[0.8,0.6]与文字向量[1,0]的点积是0.8,与[0,1]则是0.6。这里的坐标是教学数,不能解释成“有80%是狗”。
一批三对样本形成3×3的相似度表。假设三行依次是狗、猫、自行车图片,三列是对应文字,教学分数依次为[0.8,0.2,0.1]、[0.1,0.9,0.2]、[0.2,0.1,0.7]。对角线是原始配对,其他格是这批中的不匹配组合。
对比学习的目标是让原始配对相对其他候选更容易被选出,通常同时训练“图找文”和“文找图”。仅让图和文的向量宽度相同,还没有告诉模型哪个对应关系值得学习;监督来自这批数据中已知的配对标签。
把狗图这一行走完。固定教学温度τ=0.5,τ读作tau,表示将分数变成概率时使用的尺度。把相似度[0.8,0.2,0.1]分别除以0.5,得到logit[1.6,0.4,0.2]。再用第4章的softmax:取指数后约为[4.9530,1.4918,1.2214],用三数之和7.6663作分母,得到[0.6461,0.1946,0.1593],加起来为1。
这三项分别是“在本批三段文字中选择狗、猫、自行车配文”的概率。狗图的原配文是第一项,标签为[1,0,0],所以该行交叉熵损失为−ln(0.6461)≈0.4368。ln表示自然对数;配对项概率越接近1,这个损失越接近0;把错误配文分到太多概率,原配文的概率便会被挤低。
反方向固定狗的文字,看第一列[0.8,0.1,0.2],候选变成三张图。仍除以0.5、再归一化,得到[0.6461,0.1593,0.1946];正样本是狗图,列损失也约0.4368。这次两损失相等,是教学数字恰好重排的结果,并非行列损失永远相等。其余两行与两列同样计算,三个行损失和三个列损失一共六项取平均,得到本批双向损失约0.4399。
这些损失要沿相似度、投影和向量计算反向传播,才能改变图像与文本编码器参数。只看狗图这一行,交叉熵对三个logit的梯度为“预测概率减标签”,约[−0.3539,0.1946,0.1593]:在其他logit独立固定的局部比较下,降低损失会推高原配对分数、压低其他两项。真正优化的是共享网络参数,还会叠加其他行列信号,因此不能保证每次更新后每个分数都独立按理想方向改变。CLIP原论文的双向目标与训练伪代码
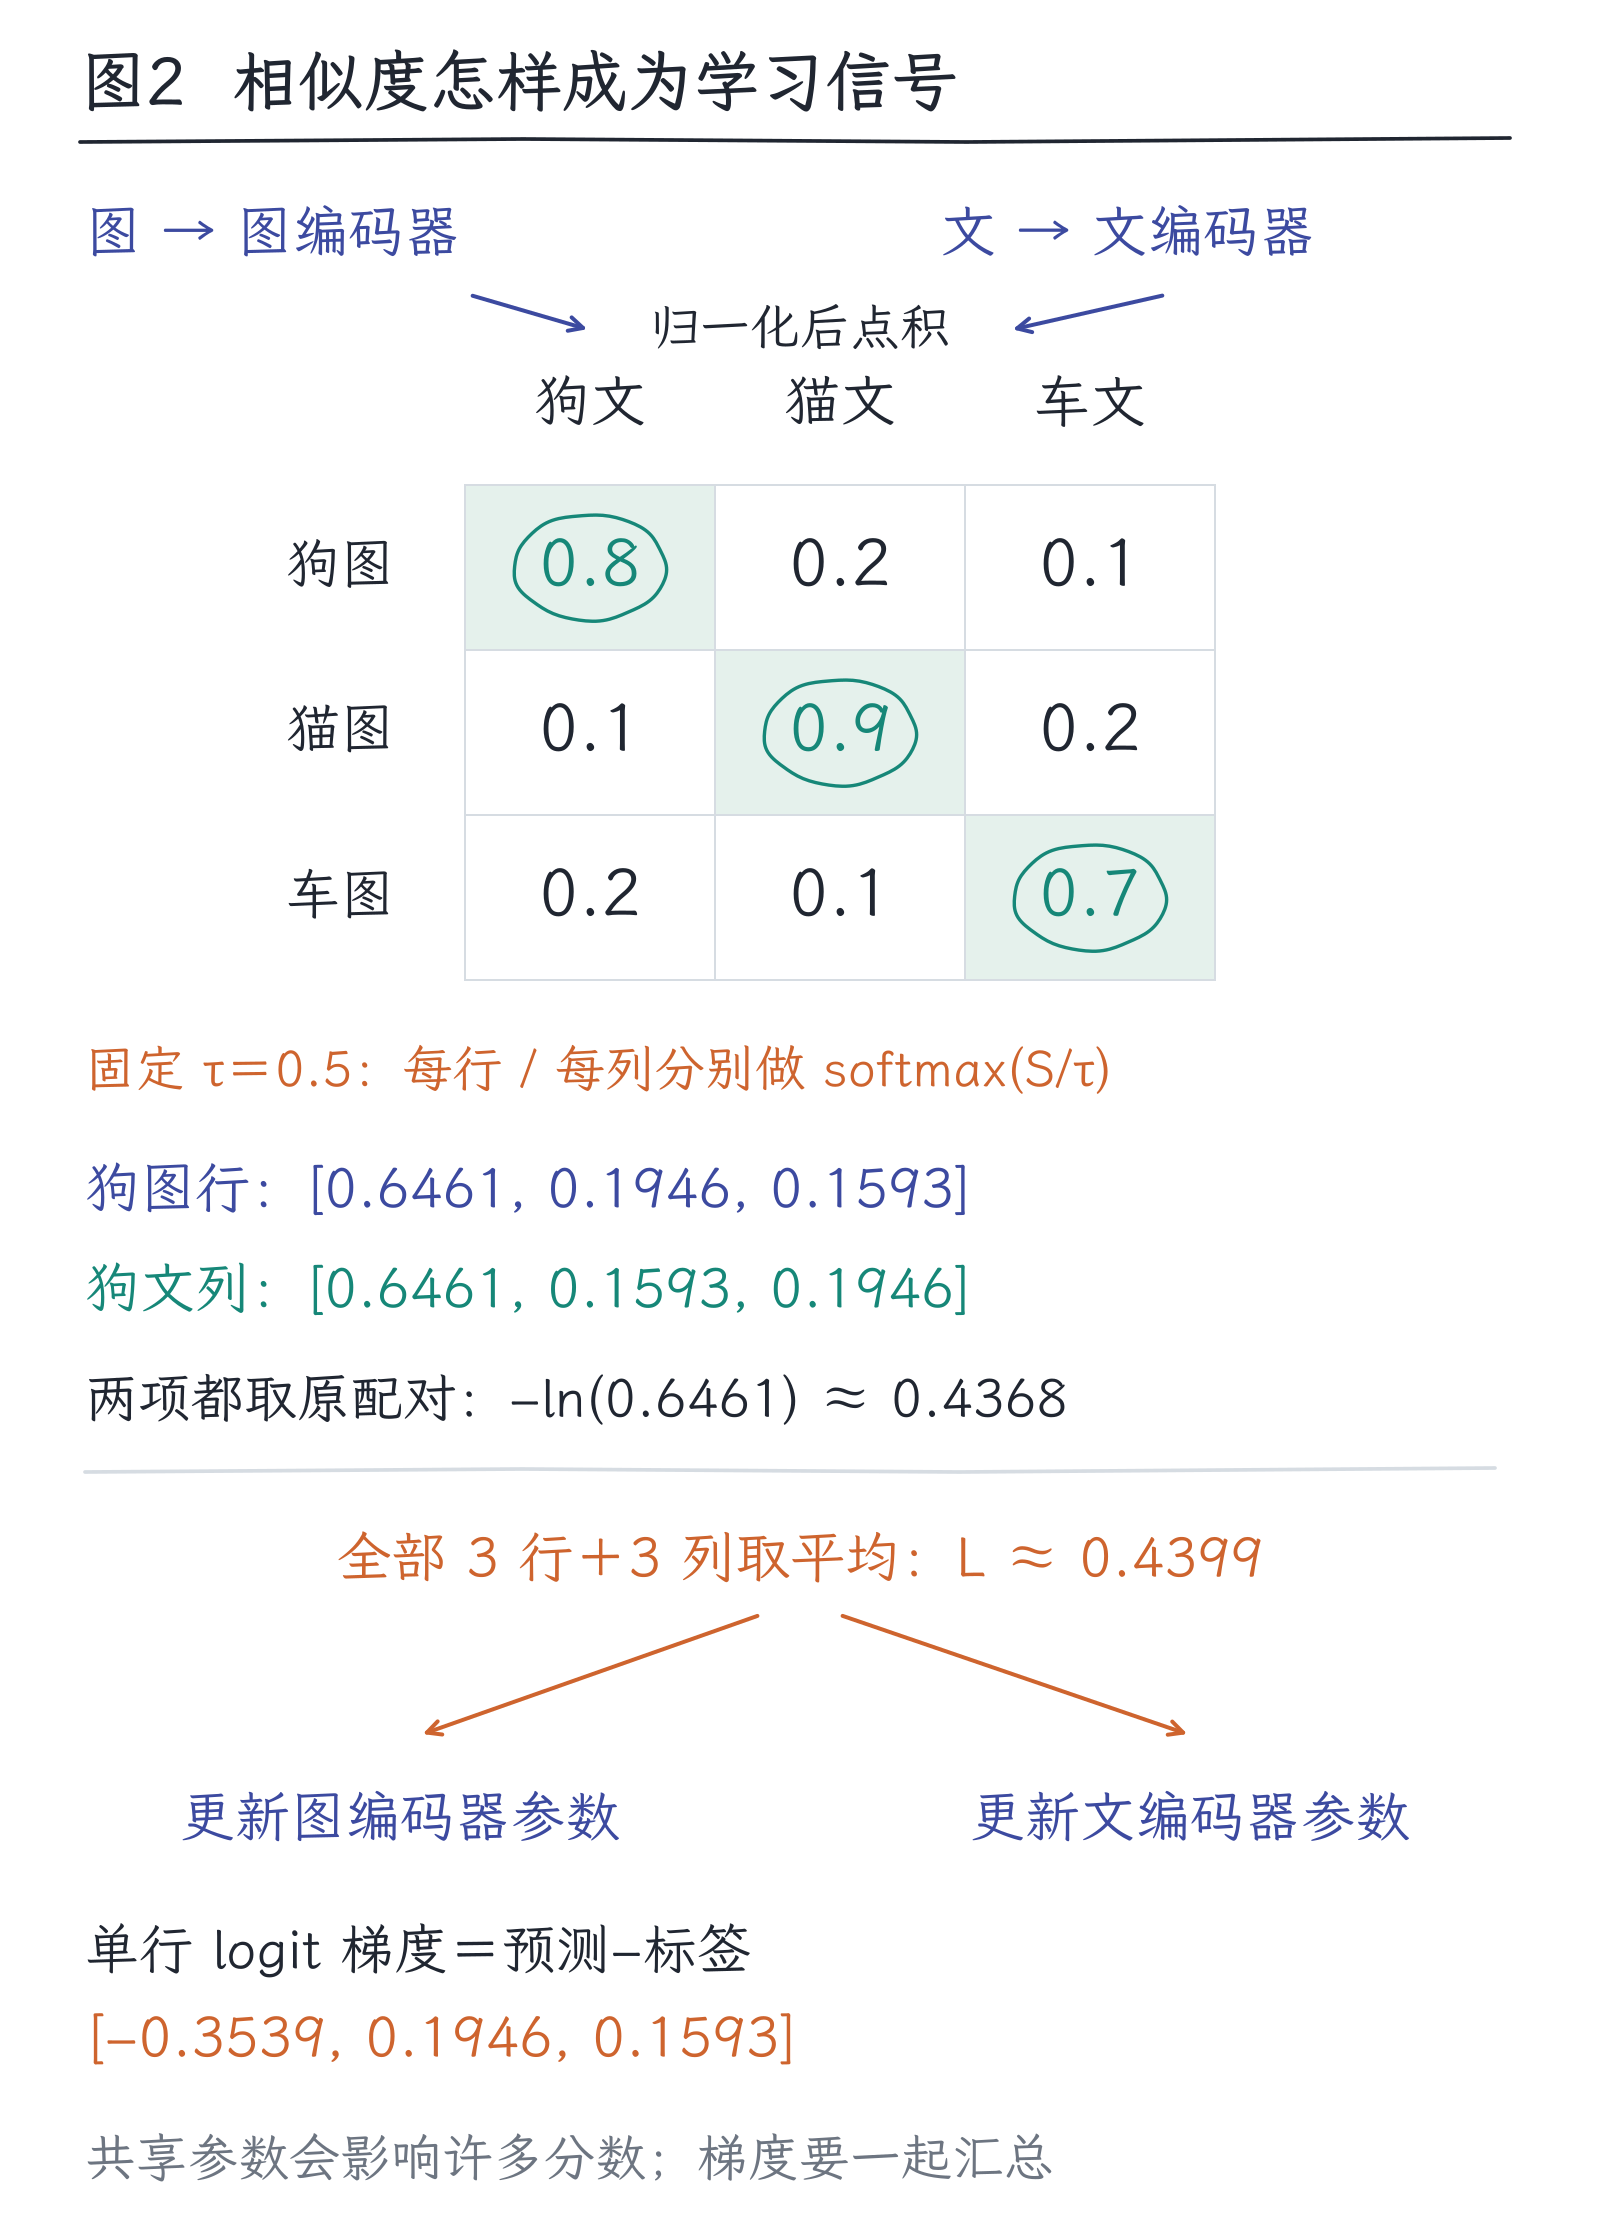
图2|同一3×3教学相似度表,温度固定为0.5。狗图行与狗文列各自归一化,正样本均在对角线;全部三行和三列损失平均后,梯度回到图、文两套编码器参数。图中只展开第一行、第一列,0.4399是全部六项的平均,不是两个0.4368的平均。
选读:把双向损失写成一个式子
设Sᵢⱼ是第i张图与第j段文字的相似度,N是本批配对数,本例N=3。图找文的概率Pᵢⱼ=exp(Sᵢⱼ/τ)÷Σₖexp(Sᵢₖ/τ),分母沿第i行求和;文找图的概率Rᵢⱼ=exp(Sᵢⱼ/τ)÷Σₖexp(Sₖⱼ/τ),分母沿第j列求和。Σ表示把所有候选项加起来。
总损失L=−Σᵢln(Pᵢᵢ)+Σᵢln(Rᵢᵢ)÷(2N)。对角线表示数据中的原配对标签,行列两种方向各占一半。真实CLIP还学习缩放参数;本例把τ固定,只为隔离一次归一化与损失计算,不是在复刻其全部训练设置。
这不是把同一段文字写入图片,也不是强迫两个完整向量逐项完全相等。它学习的是任务所需的跨模态对应关系。温度或缩放会改变相似度转成候选概率时的尖锐程度,而候选概率仍受候选集合影响,不是世界上所有描述的绝对正确率。
CLIP采用这样的双编码器对比训练,其论文报告使用4亿对图文。使用时可以把类别写成自然语言描述,再与图像比较,从而在无需为该分类任务重新训练的情况下选择候选类别。CLIP原论文
这里的“零样本”指特定下游任务没有再用其标签训练,并不意味着模型从未接触过相关概念。候选措辞也会影响结果。“狗”与“一张狗的照片”可能给出不同文本表示,类别列表缺少真实类别时,系统还可能被迫选一个最像的错误选项。
配对数据也有噪声:网页旁边的说明可能讲的是背景故事,没有描述图片;同一批的两张狗照片也可能都符合“草地上的狗”,却被训练目标当成不同配对。因此对比学习得到的是数据与目标共同塑造的对应关系,不能把“不是这条配文的原配图”理解成“语义绝不匹配”。
此外,能区分猫与自行车,不等于能区分两张只在一个数字上不同的发票。整图相似度可能对大范围语义很敏感,却忽略任务关键的小差异。选择图像表示时,要用实际需要的定位、读字或细粒度比较来验证,而不只看一个分类成绩。
5.从图文匹配到能回答问题,还缺哪座桥
原始CLIP擅长比较图文表示,不能因为名字里有语言,就把它当成会逐词写长答案的聊天模型。视觉语言模型需要把视觉信息接到语言生成路径,让问题与图像共同影响回答。
一种常见结构是:图像经过视觉编码器,得到一组特征;连接器把这些特征投影或合并到语言模型可接收的形状;文字问题经过文本嵌入;两类表示连同边界和位置信息,构成语言模型的输入上下文。
连接器不仅是改一下数字表的宽度。它需要通过训练,让输出表示能被语言模型利用。常见方法使用线性层、多层网络或带查询的模块,不同模型的做法并不相同;“有连接器”也不意味着视觉编码器或语言模型一定全部冻结。视觉指令微调研究
训练时可以用图文说明、视觉问答、定位和文档任务,按具体设计分阶段对齐,再进行更广范围训练或指令微调。模型通过损失学会在给定视觉条件下生成目标文本,而不只是学会对整图贴一个类别标签。
从软件接口看,连接器输出宽度与语言模型输入匹配,只证明数组能接上;它是否携带语言模型能使用的视觉信息,要由训练和任务测试证明。这像接口类型正确与语义契约满足的区别:把随机向量改成正确宽度,程序也许能运行,但没有理由期待它正确读图。
同一张照片,问“有哪些物体”与“杯子左边是什么”,文字条件不同,后续读取视觉证据的方式也会不同。有些结构先独立编码图片,再由语言模型结合问题;不能一概说最前面的视觉编码器已经按照问题重新看了一遍图。
而且生成器仍带着语言先验。桌上有盘子,它可能顺着常识补出餐具;图中实际没有叉子,语言常识也不能补成视觉证据。多模态并没有绕过上一章的幻觉、校准与评测问题。
6.一个可核查的完整例子:Qwen2.5-VL
Qwen2.5-VL技术报告公开了视觉编码器、视觉语言合并模块和语言模型的组合。图像按步长14切块;空间相邻四个patch特征先拼接,再经两层MLP投影到与语言嵌入匹配的维度。MLP是多层前馈网络,不是把四块的文字说明拼在一起。Qwen2.5-VL技术报告,结构
只做静态空间计数,假设处理后的图像恰为56×56像素,那么14×14切块得到4×4=16个patch;四块一组合并后得到4个视觉表示。这个数不包含边界等特殊标记,也不代表用户上传任意56像素小图就一定如此计费;实际预处理仍以具体实现为准。
报告还说明,大多数视觉层使用窗口注意力,四层保留全局注意力;支持动态分辨率,使不同大小的图像可以产生不同长度的视觉序列。这是该模型公开版本的具体选择,不能画成所有视觉语言模型的统一结构。Qwen官方发布说明
动态分辨率有助于保留不同尺度的信息,但资源限制依然存在。页面中展示的定位或文档解析案例说明官方演示了哪些能力,不保证所有复杂表格、小字体与遮挡场景都可靠。真实使用仍要在自己的图像类型上测试。
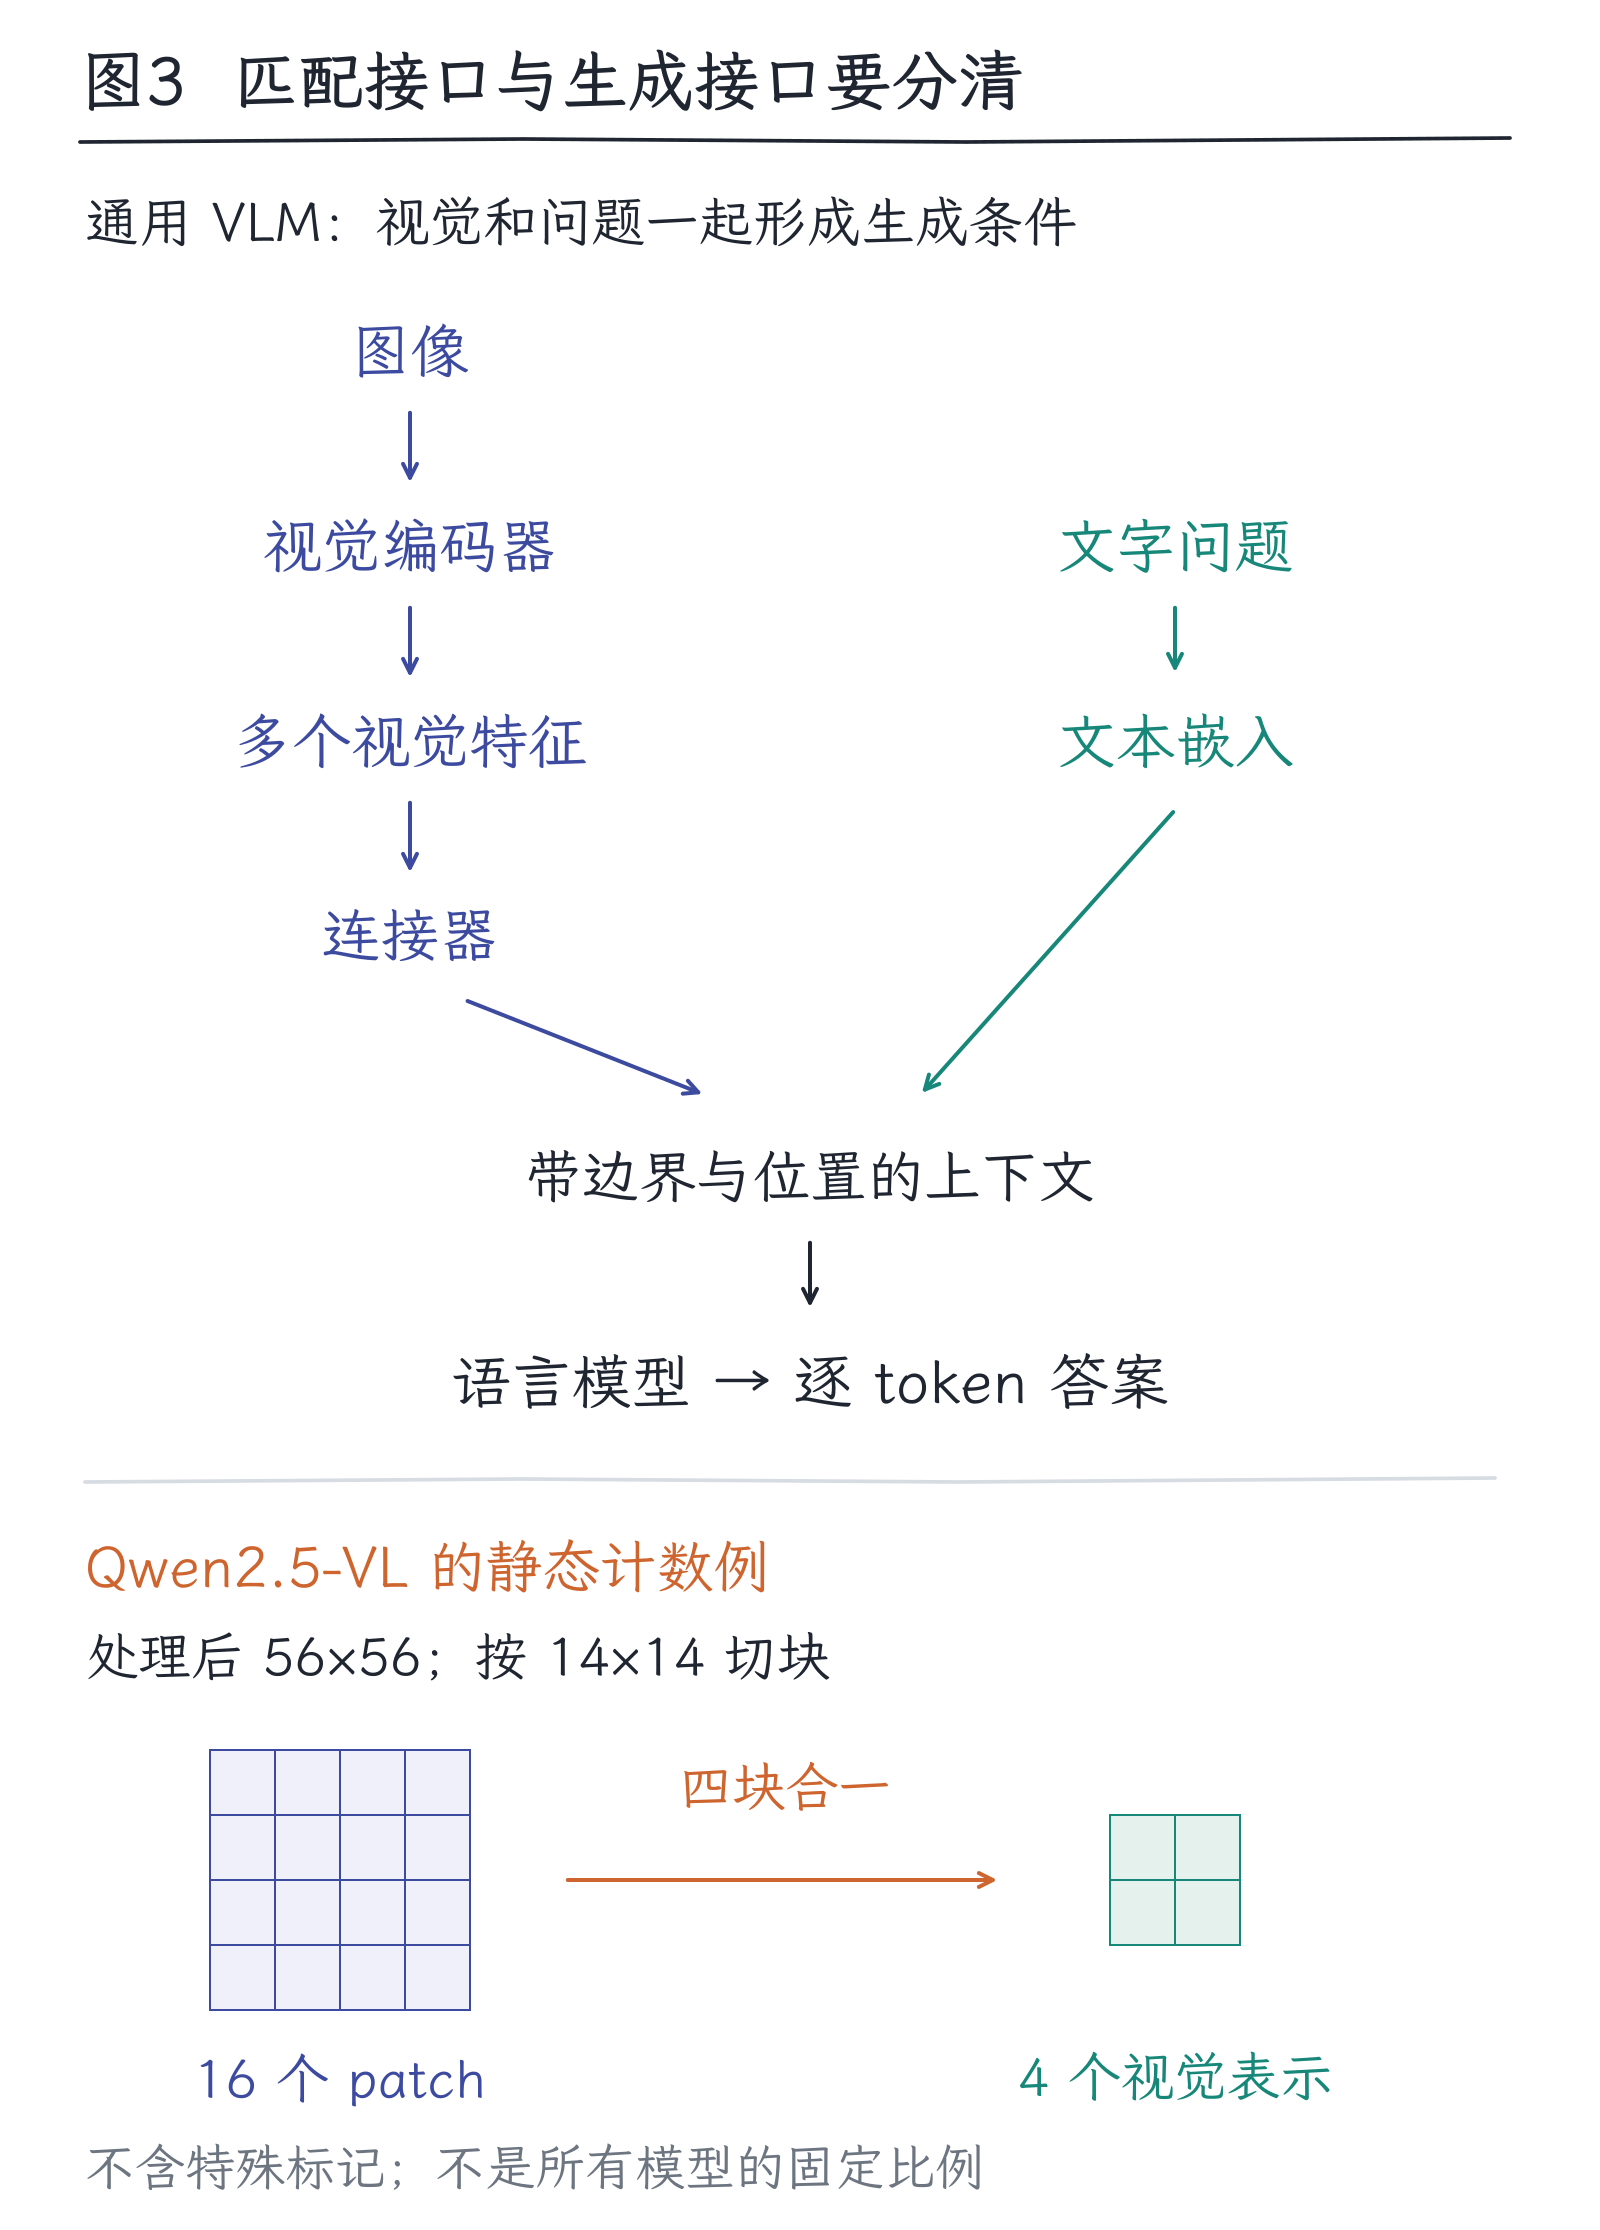
图3|通用VLM路线中,视觉特征经连接器与文字问题一起构成语言模型上下文,再逐token生成答案。下方单独标出Qwen2.5-VL公开结构的静态教学计数:处理后56×56图像、14×14切块、16个patch经四块合并得到4个视觉表示;不含特殊标记,不是所有VLM的固定规则。
7.看见、定位和推断,应分别检查
“图里有杯子”是识别,“杯子在左下区域”是定位,“杯子属于拍照的人”则可能只是推断。答案写在同一段里,不表示证据强度相同。尤其是遮挡、反光、细小文字和精确计数,容易让语言猜测补上视觉缺口。
可以用同一场景做一组不需要编程的检查:原图、略缩小版、裁出目标版,以及不含目标的反例图。固定问题,检查答案是否跟着关键证据变化;再把问题中的物体名换掉,观察模型是否轻易迎合不存在的前提。
裁切有时帮助读清文字,却可能丢掉表头、坐标或相邻关系。提高分辨率可能增加信息,也增加视觉序列与计算。合适的输入不是永远最大,而是能够保留任务所需证据,并让成本与延迟可接受。
本章练习
题目
问题1|正向计算一次投影
仍用“四格总和、上排和减下排和”的二维教学变换。小块[0,1;1,0]映射成什么?它与[1,0;0,1]是否不同?由此说明这次投影保留和丢掉了什么。
问题2|把图找文的损失算出来
狗图对应的三项概率为[0.6461,0.1946,0.1593],原配文为第一项。写出标签与该行损失;若某次更新后正配对概率变为0.8,该行损失约为多少?为什么还不能仅凭这一个数评价整个批次?
问题3|两种输出接口
CLIP给出三个候选描述的相似度,与VLM生成“杯子在电脑左边”,分别经过什么主要路径?按本章Qwen2.5-VL静态假设,处理后56×56图像会形成多少patch、多少送入语言模型的视觉表示?
思考提示
提示1|对应问题1
分别求总和与上下两排差;比较两个原小块是否其实相同。
提示2|对应问题2
损失只取原配对项的负对数;本批另有其他图找文和文找图任务。
提示3|对应问题3
找出哪条路径止于匹配分数,哪条还进入语言生成器。空间计数先切块,再按四块合并。
参考答案与解析
答案1|对应问题1
总和为2,上排与下排各为1,差为0,故得到[2,0],与另一小块相同。变换保留总亮度及上下排差,却分不清这两种对角线排列。表示宽度和规则决定哪些差别还能被后续利用;真实学习投影也不自动无损。
答案2|对应问题2
标签为[1,0,0],损失为−ln(0.6461)≈0.4368;改为0.8时,−ln(0.8)≈0.2231,该行改善。全批还包含另两行与三列,共六项;共享参数可能同时改变其他配对,因此只看狗图行不能代表双向平均损失,更不能代表下游任务表现。
答案3|对应问题3
CLIP分别编码图与候选文字,再比较向量;VLM把视觉编码器输出经连接器适配后,与问题一起交给语言模型生成。56÷14=4,每边4块,共16个patch,四块合并得到4个视觉表示。这里未计特殊标记,并固定了处理后尺寸与公开模型的合并规则,不能用来推定其他模型或任意上传图片的token数量。
下一章
图像理解把像素转为可供判断与语言生成的条件。下一章转向相反方向:文字提出要求以后,系统怎样从噪声逐步生成一张图,为什么这条路径并不只是把下一词预测的词换成像素?