一个大模型能写出不错的解题示范,但每次都让它处理请求,可能超出部署预算。能否先请它教一个小模型,以后主要由小模型回答?
这就是蒸馏的一种常见动机。教师提供行为或分布方面的训练信号,学生更新自己的参数,学习在相关输入上作出类似判断。它不是把教师文件剪短,也不保证学生拥有教师的全部能力。本章要分清两种常见信号:已经生成的文本,以及尚未抽成一个token的候选分布。
1.迁移的是行为关系,不是逐块搬运权重
假设教师会解释一道应用题,学生从另一个已预训练基座出发。我们可以把同一道题送给教师,收集它的回答,再训练学生。这时学生学到的东西通过数据和训练目标进入参数,而不是从教师某一层取出一块矩阵直接贴过去。
因此,教师和学生可以具有不同参数规模、不同层数,甚至采用不同架构。蒸馏的关键是两者之间有没有可用的监督接口。经典蒸馏研究把模型学到的输入到输出关系作为迁移对象,而不把“知识”限定成某一份权重的具体数值。蒸馏原始论文
这也意味着小模型不是一张白纸。已有基座会影响它理解示范的能力、可表达的复杂程度和原有语言知识。同一批教师答案交给两个不同基座,不能预期它们得到同样的学生。
“教师”“学生”描述训练中的角色,并不强制教师一定参数更多。实践里常希望教师在目标任务上更可靠,或者能使用更多计算,再把这种优势迁移到便宜的学生。本章采用大模型教小模型的情景,但不把它当成定义的唯一形式。
2.第一条路径:把教师文本当成示范
输出序列蒸馏最直观。给教师一个问题,让它生成完整回答;筛选后,把问题与回答组成学生的训练样本。学生看到问题和示范前缀,逐位置提高下一个示范token的概率,训练形式可以就是SFT。序列级知识蒸馏研究
如果示范包含拆题、计算和核对,学生就有机会学到这些表达与解题模式。如果只保留最终答案,传递的监督会更简短,但很多中间线索也随之消失。保留更多文字增加了可学习内容,也增加了数据长度、训练成本和错误混入的机会。
注意,教师生成一个token时原本有整张候选概率表;收集成纯文本后,通常只留下被选中的那一个。学生并不知道第二名是什么,更不知道第一名是险胜还是压倒性领先。重复采样可以带来多种示范,但有限样本不等于完整分布。
这种方式不要求两者使用相同分词器。教师输出的文字,可以按学生的词表重新切分,再作为示范使用。不同模型的token编号没有天然对应关系,不能因为编号相同就认定它们代表同一段文字。
3.第二条路径:连没被选中的候选也一起学
软分布蒸馏保留更多信号。在同一个输入条件下,教师不只说“选猫”,还给出“猫、狗、汽车各占多少概率”。学生也产生一组概率,训练目标让两组分布接近。
语言模型里,这个比较可以发生在每个下一token位置:教师和学生面对相同题目与前缀,对对应候选给分。logits是转换成概率之前的分数;softmax把它们变成总和为1的分布。读取教师logits,便能构造比单个选中token更丰富的目标。
不过,直接逐项比较要求候选含义和位置能够对齐。若两者词表或切分方式不同,不能拿“第八号token的分数”硬比;需要额外的对齐方法,或者选择文本示范这条接口更简单的路线。
还有一个容易漏掉的问题:共同前缀由谁写出来?若一直使用教师的示范前缀,学生学习的是在这些条件下接着说;真正生成时,学生可能先选了另一个token,随后走进没练过的条件。让学生先生成,再请教师评价这些前缀下的候选,便是在改变训练看到的输入分布,而不是给教师换了一个名字。
把前缀简写为P。教师示范选了A,下一张概率表是p(·|P,A);学生若先选了D,接下来真正需要的是p(·|P,D)。两张表的条件不同,不能把A后面的概率原封不动贴到D后面。让教师在学生实际写出的P,D上重新打分,才是在教它处理自己走到的状态。
教师在这种常见设置中保持冻结,学生接受损失和更新。训练完成后,学生通常可以独立回答,不需要每次再问教师。推理时额外调用大模型复核则是另一套系统设计,不能从“蒸馏过”三个字推断出来。
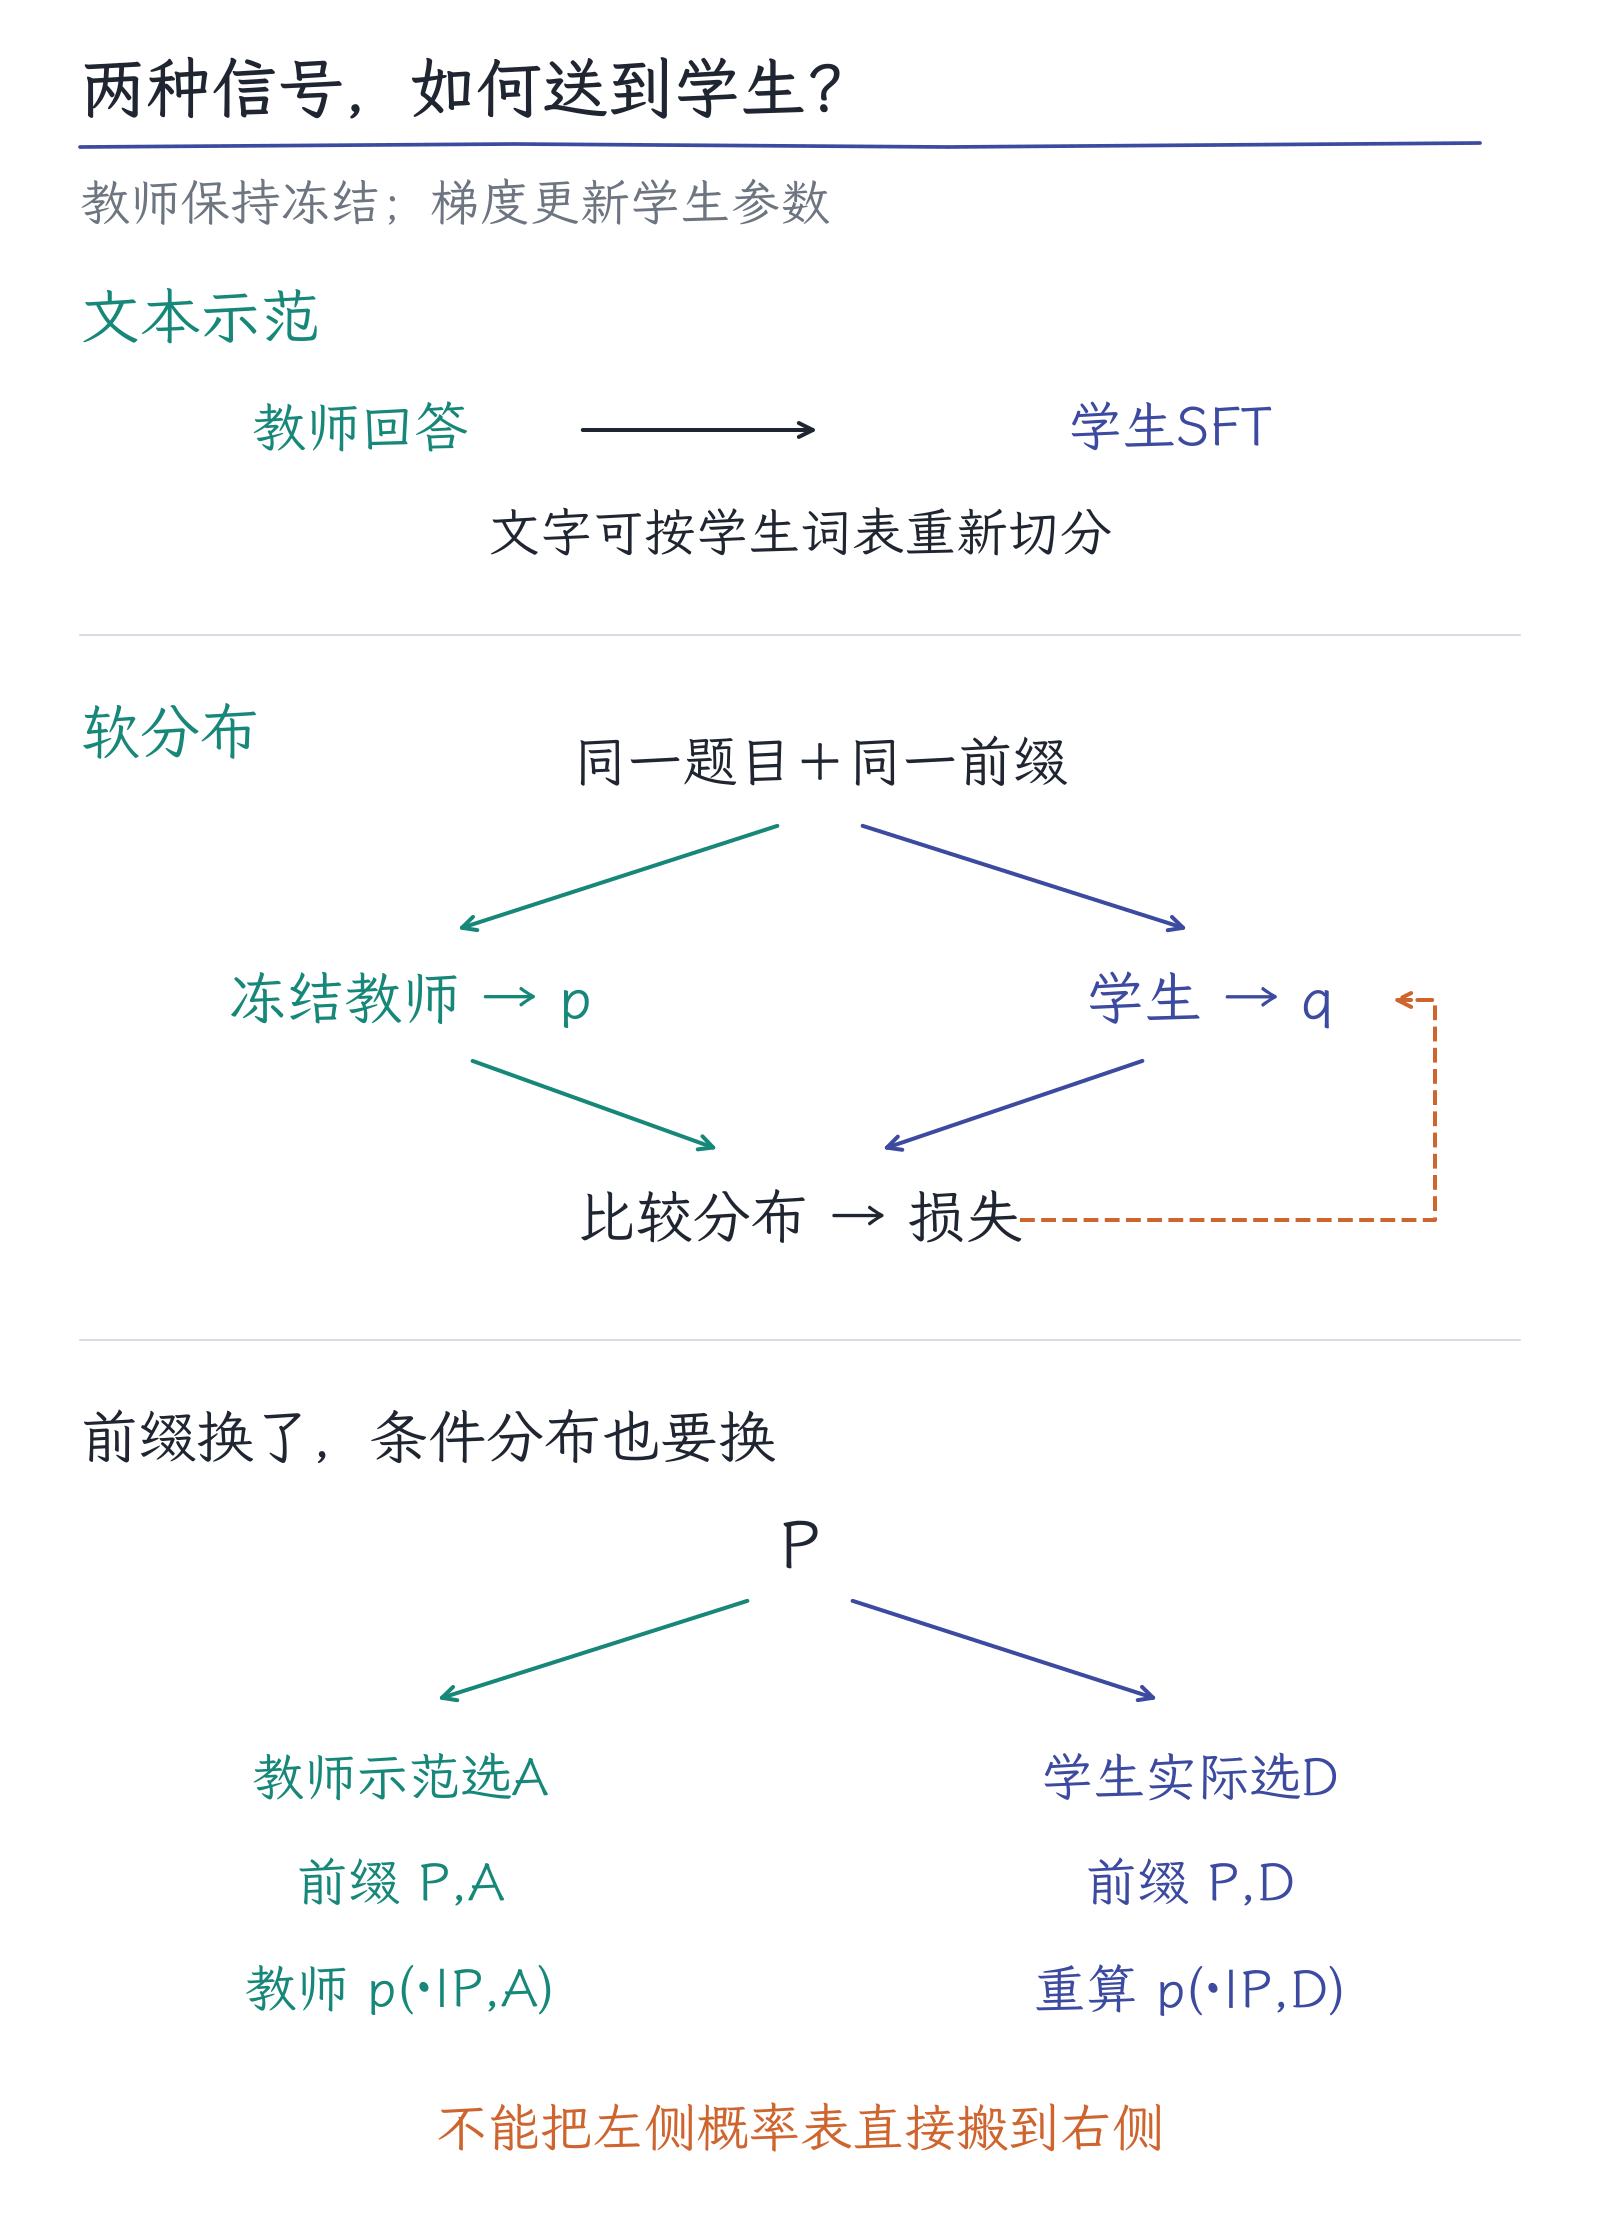
图1|文本蒸馏把教师回答转成学生示范;分布蒸馏把同一前缀并联送给教师与学生,再比较候选概率。下方前缀分叉强调:学生选了D以后,教师也要在P,D这个条件下评价,不能搬用P,A的分布。
4.纸笔实验:同样选对,损失为何不同
为避免庞大词表,暂时用一个三类分类任务。输入是一张模糊动物图片,候选依次为猫、狗、汽车。以下概率完全为教学构造,不是真实模型测量,也不表示真实世界中的正确率。
教师给出[0.64,0.25,0.11]。学生甲恰好相同,学生乙给出[0.64,0.01,0.35]。两名学生都把猫排第一,而且给猫的概率完全相同。
如果硬标签只告诉我们正确类是猫,损失就是−ln(学生给猫的概率)。不用手算对数,查给定数值即可:−ln(0.64)约为0.4463。因此,甲乙在这条样本上的硬标签损失一样,无法区分剩下的概率主要分给了狗还是汽车。
软目标则把教师的每一份判断都纳入。可以先理解为:分别算“学生有多不看好这个候选”,再按教师对这个候选的份额加权。教师给狗0.25的份额,学生却只给0.01,这种差异就会进入损失。
具体计算用到的负对数值为:0.64对应0.4463,0.25对应1.3863,0.11对应2.2073;0.01对应4.6052,0.35对应1.0498。
甲的软交叉熵约为0.64×0.4463+0.25×1.3863+0.11×2.2073=0.8750。乙约为0.64×0.4463+0.25×4.6052+0.11×1.0498=1.5524。软目标由此区分了硬标签没有区分的两种行为。
甲完全匹配教师,损失为什么还不是0?因为这里计算的是交叉熵,其中包含教师分布自身的不确定性。减去两人共同的0.8750基线,就得到这一方向的KL差异:甲为0,乙约0.6774。记住“衡量分布差异”即可,不需要推导公式。
这一差异还会形成明确的更新信号。用p表示固定的教师概率,q表示学生概率,T表示温度。在T=1时,软交叉熵对学生每个logit的梯度等于“学生概率-教师概率”,即q-p。学生乙对应[0,-0.24,+0.24]:把logits当成三个可独立调整的数,梯度下降会推高狗的分数、压低汽车的分数;猫的直接梯度为0。
这个方向可以独立检查:固定教师和学生乙其余两个logit,只把“狗”的logit分别增加、减少0.001,每次重新softmax、再计算软交叉熵。损失分别约为1.552156731和1.552636731,所以局部斜率约为(1.552156731−1.552636731)÷0.002=−0.24。抬高狗的分数使损失下降,和q−p给出的方向一致;0.001是核验用的小扰动,不是训练学习率。
选读:重新归一化后核对q−p,而不是只改一项概率
保持p=[0.64,0.25,0.11]、学生乙q=[0.64,0.01,0.35]。可以取学生原始logits为z=[ln0.64,ln0.01,ln0.35],因为exp(ln qᵢ)=qᵢ,且三项和为1,softmax(z)恰好还原q。zᵢ表示第i个候选的logit,pᵢ、qᵢ表示相应概率。
把狗的logit增加0.001以后,三个未归一权重为[0.64,0.01×exp(0.001),0.35]。三项都除以新的总和,得到约[0.639993597,0.010009905,0.349996498],再代入L=−Σᵢpᵢlnqᵢ,得到1.552156730826。减少0.001时,新分布约为[0.640006397,0.009990105,0.350003498],损失为1.552636730822。用两侧损失差除以0.002,得到−0.239999998,接近解析梯度−0.24;显示的小数经过舍入,计算时保留完整精度。
这也可以用短推导解释。T=1时,lnqᵢ=zᵢ−lnΣⱼexp(zⱼ),所以L=−Σᵢpᵢzᵢ+lnΣⱼexp(zⱼ),这里用到了Σᵢpᵢ=1。对某个zₖ求导:第一项给−pₖ,第二项给exp(zₖ)/Σⱼexp(zⱼ)=qₖ,合起来就是qₖ−pₖ。Σ是对所有候选求和;k只指定这一次检查的那个候选。经典蒸馏论文第2.1节公式2
对猫和汽车分别做同样的±0.001核验,可得约0和+0.24。它们都是针对logit的变化率;若直接把狗的概率加0.001、其余概率固定,概率和就不再是1,检验的也不是这里的softmax梯度。
这里说的是对logit的局部梯度。softmax会把所有候选重新归一化,真实网络还共享参数,不能据此保证一次有限更新后每个概率都只按这三根箭头独立变化。与硬标签相比,软目标的价值就在于目标分布给“剩下的概率放哪儿”也提供了方向。
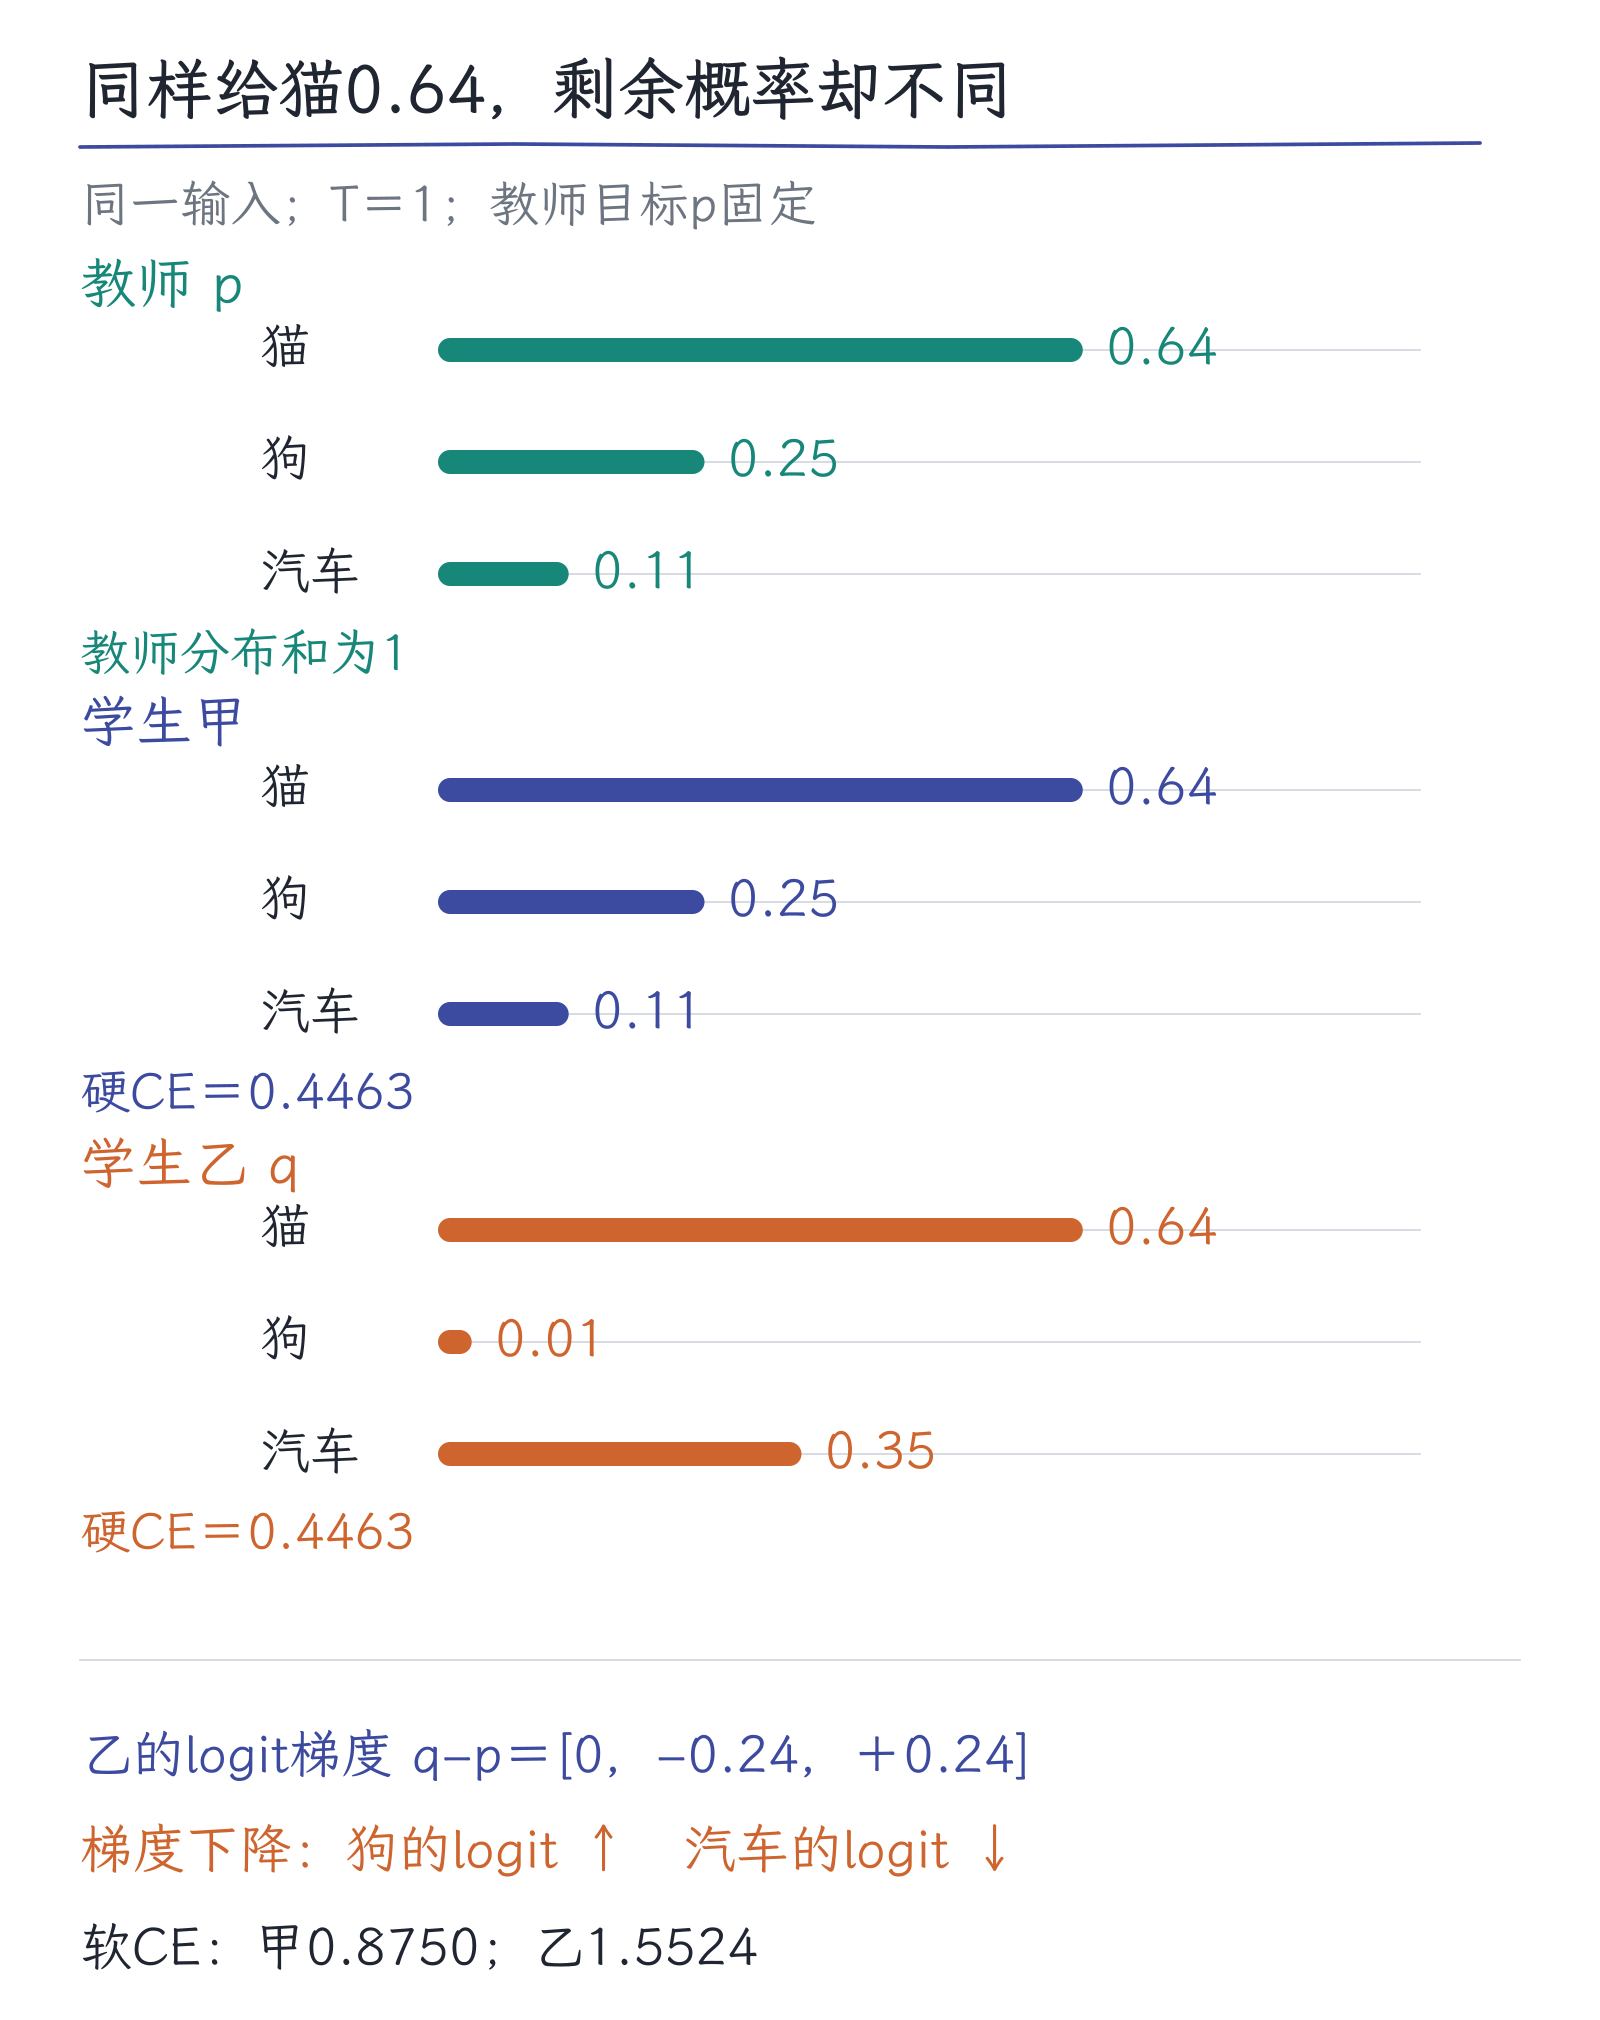
图2|猫、狗、汽车共用0到1的概率尺度。两个学生给猫同样的0.64,硬标签损失相同;学生乙把狗的0.24份额移给汽车,软目标会分辨。橙色箭头表示独立logit上的梯度下降方向,不冒充实际训练后的概率。
5.小概率为什么也有信息
在这个例子里,教师给狗的概率约是给汽车的2.27倍。即使最后选择猫,这组关系仍然透露:教师更容易把当前输入与另一种动物混淆,而不是与汽车混淆。
真实分类中,这类次要候选的相对关系可能帮助学生学习输入之间的结构。经典蒸馏研究强调,第一名以外的概率也能传递泛化方式;只保留硬标签会丢失这些信息。软目标与相似关系
但要把这句话读完整:它传递的是教师判断出的关系,不是经过独立证明的客观相似度。如果训练照片里汽车总出现在猫旁边,教师可能学到错误关联;软目标也可能把这种关联教得更完整。
因此,“软”描述监督信号的形式,不等于更真实或更安全。教师偏差不会因为写成小数而消失。教师若对一段错误事实非常自信,学生匹配得越好,可能就把错误复现得越稳定。
6.温度让哪些信息更显眼
如果教师把几乎所有概率都压在第一名,其他候选对损失的影响可能太弱。蒸馏常用温度T调节分布:先把logits除以T,再做softmax。T大于1时,分布通常更平;匹配时教师和学生使用同样的温度。蒸馏论文第2节
对刚才的教师分布,固定原logits并设T=2,有一种方便手算的等价操作:各概率先开平方,再归一化。0.64、0.25、0.11分别变成0.8、0.5、约0.3317,总和约1.6317。分别除以总和,得到约[0.4903,0.3064,0.2033]。
猫仍然第一,但狗和汽车相对更显眼。这里不是把概率直接除以2;那样三项之和只剩0.5,根本不是规范化后的分布。
温度不能改变教师掌握的事实,也不一定越高越好。若分布几乎被摊平,各候选又变得难以区分,还可能放大不可靠的尾部信息。它调节学习信号,不能替代数据质量判断。
蒸馏温度与使用时采样温度也不是同一项承诺。前者用于构造训练目标,后者影响当前回答怎么抽取token;模型用温度2进行过蒸馏,不表示以后生成答案必须用温度2。
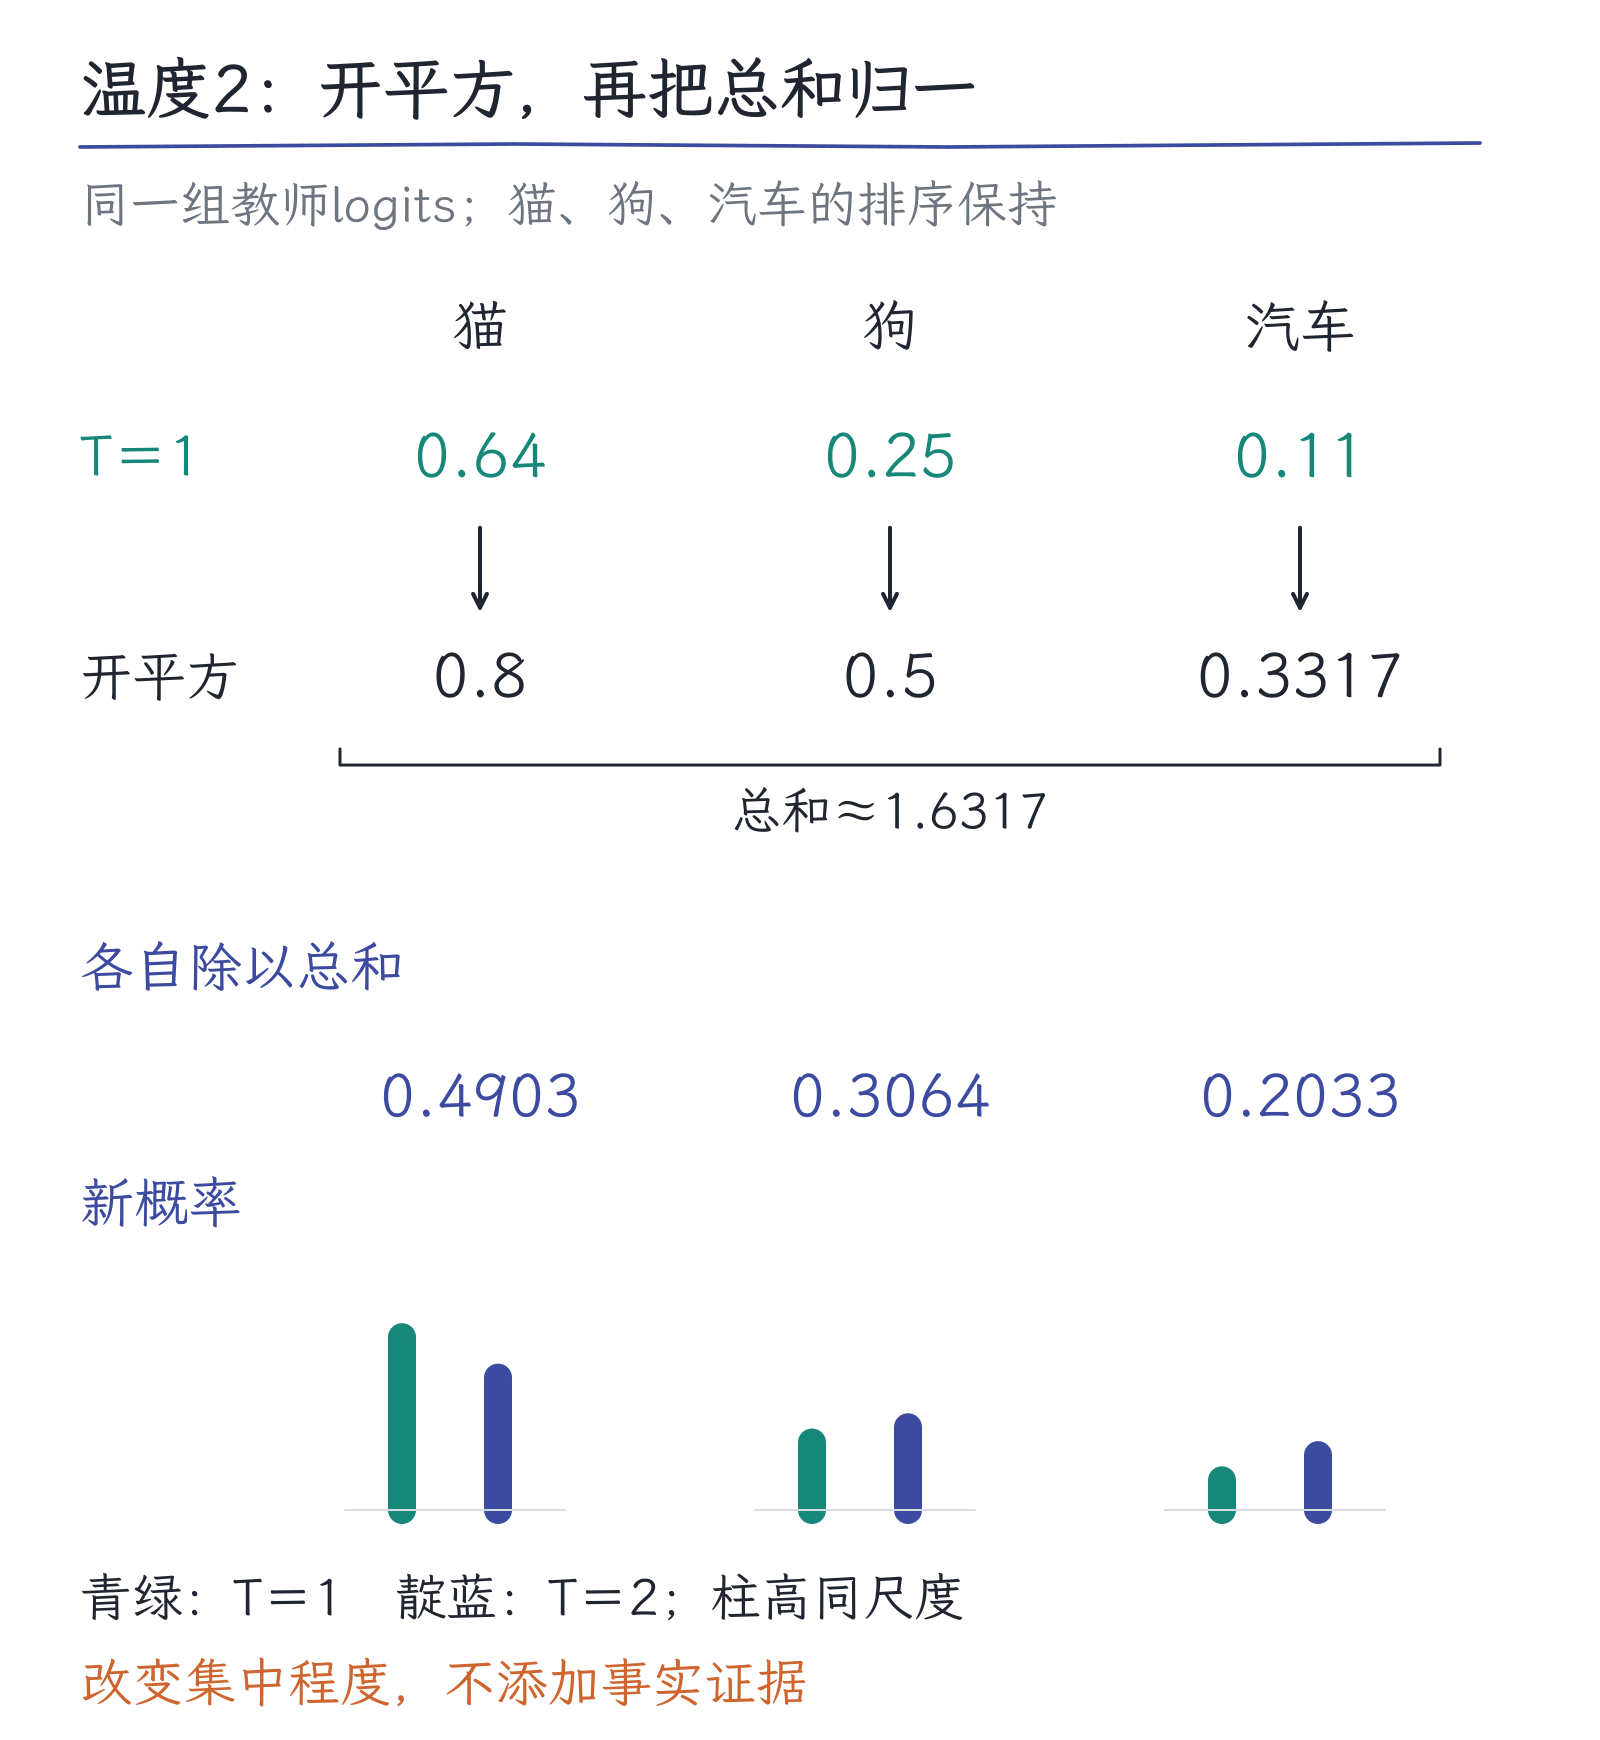
图3|固定同一组教师logits,T=2等价于对原概率开平方后重新归一化。三项之和仍为1,排序未变;这只改变训练信号的集中程度,不会核验图片类别。
选读:温度还会影响梯度尺度
教师与学生都使用温度T时,软交叉熵对学生原始logit的梯度为(q_T-p_T)/T。经典蒸馏还将软目标损失乘T²,以大致抵消高温下的梯度缩小,尤其在与T=1的硬标签损失混合时便于控制相对权重。这个缩放是经典目标的设计选择,不是所有蒸馏必须遵守的定义。经典蒸馏论文第2节
7.在公开模型里看见两条路径
DeepSeek-R1-Distill-Qwen-32B的官方模型卡明确列出,其基座是Qwen2.5-32B,训练使用由DeepSeek-R1生成的样本。教师R1采用MoE,而这个学生是稠密模型。它展示的是通过样本跨模型迁移行为,不是把R1删去一批专家后变成32B。R1-Distill-Qwen官方模型卡
R1技术报告还说明,文中发布的这批蒸馏学生使用SFT,没有再加入RL阶段。这能帮助我们读懂名字:教师的能力可能来自强化学习,学生却可以通过学习教师整理出的示范获得收益。不能由学生名字里的R1反推它经历了与教师相同的训练。R1技术报告第2.4节
另一个明确案例是DeepSeek-R1-0528-Qwen3-8B。其官方模型卡说明,用R1-0528的推理轨迹对Qwen3-8B-Base进行后训练。这里教师版本与学生基座都已变化,不能把前一批学生的全部训练细节自动套过来;模型卡没有披露的步骤应保留为未知。0528-Qwen3-8B官方模型卡
Qwen3报告则明确描述两阶段蒸馏:先学习教师产生的回答,再让学生自己生成序列,在这些条件下对齐教师logits,最小化KL差异。后一阶段称为on-policy蒸馏,重点是训练接触学生自己会走到的前缀。Qwen3技术报告第4.5节
这几个例子支持的结论是蒸馏接口可以不同。不能把所有“Distill”都解释成拿到了完整教师概率,更不能从某个学生的名字猜测闭源教师内部采用了哪些层或训练方法。
8.能学多少,取决于数据、学生和评测
教师只回答过数学题,学生就缺少从这些数据学习其他任务的机会;示范都采用一种句式,学生也可能只学到表面模板。要判断能力是否迁移,需要未见题目、不同表达和合理的难度变化,而不是让学生复述教师原答案。
教师很强,学生也可能无法容纳或利用全部信号。过长解释会增加学习负担,某些步骤对学生而言可能缺少前置知识。另一方面,经过任务筛选的学生也可能在特定题集上表现突出。这些可能性都不构成“任意任务追平教师”的保证。
可以先做一次不用电脑的筛选练习:准备五道同类题,为每题写一份教师示范,再故意把其中一份的单位或条件改错。只检查最终数字的人可能放过它;逐项核对题意的人才会发现,照着学会把这个错误带到相似题目里。这个练习不能衡量蒸馏效果,却能检查数据验收规则是否抓住了目标。
筛选教师数据时,只看最终答案仍会漏掉本章之前讨论的错误推导。应该把答案正确、过程可用、表达一致分别检查,保留可靠的原始标签或其他独立证据。若所有审核都交给同一个有偏差的教师,错误可能形成自我确认。
评测也不能只问学生是否更像教师。应同时比较原学生基座、蒸馏学生和教师,使用相同题集、提示、生成预算与评分规则,检查任务质量、原有能力退步和实际延迟。相似度更高只证明模仿更接近,未必证明目标任务更好。
这里能借用软件工程中的分层检查:有限差分核对“损失与梯度算得对不对”,独立题集核对“学生是否更符合实际需求”。前一项通过,不会替后一项作答。即使梯度完全正确,也可能在准确模仿教师的错误。
资源账同样要分阶段。教师生成大量长示范或提供逐位置分布,本身要花计算;学生训练也有成本。部署时节省多少,则还受学生架构、输出长度、硬件和批量影响。不能把参数减少比例直接写成速度提升比例。
本章练习
题目
问题1|剩余概率也在学习
教师为[0.64,0.25,0.11],学生乙为[0.64,0.01,0.35]。硬标签为猫时,为什么它与完全匹配教师的学生甲损失相同?T=1的软目标对学生乙三个logit的梯度是什么?只把狗的logit做±0.001扰动,重新softmax后损失分别为1.552156731、1.552636731,算出的局部斜率与梯度一致吗?
问题2|信号接口与前缀
教师和学生词表不同,还能用教师文本蒸馏吗?若学生从P先选了D,能直接拿教师在P,A之后的概率表监督下一步吗?
问题3|温度后的完整分布
同一教师分布在T=2时先得到0.8、0.5、约0.3317。应怎样得到新概率?排序改变了吗?这能证明学生会答对新题吗?
思考提示
提示1|对应问题1
硬标签只读取哪一项?软梯度逐项计算q-p;有限差分用“正扰动损失−负扰动损失”除以两侧logit间距。
提示2|对应问题2
文本可重新切分;概率表需要候选与条件同时对应。
提示3|对应问题3
先求总和,再逐项除以总和;把分布变换与任务评价分开。
参考答案与解析
答案1|对应问题1
两者给猫同样的0.64,硬标签损失均为-ln0.64≈0.4463。软目标的logit梯度为[0,-0.24,+0.24]。狗的有限差分为(1.552156731−1.552636731)/0.002≈−0.24,与解析梯度一致。若logits可独立调整,梯度下降推高狗、压低汽车;真实参数共享与归一化使实际概率变化还要重新计算,这次局部核验没有证明学生在新题上的表现。
答案2|对应问题2
可以把教师文本按学生词表重新切分,用作SFT示范。直接逐token分布匹配则需要候选和位置对齐。学生已到P,D时,不能搬用P,A后的概率表;应让教师在P,D条件下重新评价,或采用明确处理条件差异的方法。
答案3|对应问题3
三项和约1.6317,归一化为[0.4903,0.3064,0.2033]。猫、狗、汽车的排序没变,分布更平。这个变换没有加入真值证据,也未说明学生已经学会,应在独立新题上与原学生、教师比较任务质量及成本。
下一章
蒸馏让学生通过教师信号重新学习,并不要求改变教师权重的存储形式。下一章保留模型结构,把数值改用更少位数表示:量化省下什么,舍入误差怎样影响计算,又为什么能与蒸馏组合?