上一章的小网络接收[2,1],算出隐藏表示[1,0],最后输出3。现在给它一个目标:应该输出5。结果差了2,该修改哪个参数?每个权重都加2,能把问题解决吗?
先不记“梯度下降”这个名字。我们需要的学习办法,至少得回答三个问题:什么算更好,哪些数允许修改,以及改完以后怎样检查。沿着这三个问题走,梯度、反向传播和优化器就不再是突然出现的一串术语。
1.先说明目标,再讨论怎样学习
模型输出3、目标是5,这次预测误差是-2。为了把不同预测放在同一把尺子上比较,本例选择平方损失:预测减目标,再平方。于是损失是4;预测4时损失是1;预测5时损失是0。
平方不是唯一选择。它让高估、低估都受到惩罚,并更重地惩罚大偏差。换一把尺子,“哪组参数更好”的排序可能改变。语言模型通常使用第04章介绍的负对数损失,本篇选择平方损失,是为了让每一步都能手算。
接着划清可以改变什么。整个网络有9个参数,这一轮先固定其中8个,只允许输出层第一个权重v变化。隐藏表示仍是[1,0],另一个输出权重是1,输出偏置是1,因此预测为:
预测y=v×1+1×0+1=v+1。
要让预测接近5,损失便是L=(v+1-5)²=(v-4)²。L只是损失的简写。当前v=2,预测3,损失4;若能把v调到4,预测就恰好为5。
这就是从目标和基本关系出发拆问题,也可叫作第一性原理式的思考:先明确目标、可控量和假设,再推可行办法。它是一种推理习惯,不是另一种AI训练算法。这里直接看出了答案;真实网络无法这样一眼解出,所以还需要一种能逐步改进的通用方法。
2.损失告诉你多差,斜率告诉你附近怎样变
只知道损失等于4,还不能决定v该增加还是减少。把v稍微改动,观察损失:v=1.99时,L=4.0401;v=2.01时,L=3.9601。附近向右挪,损失确实在下降。
把损失的变化除以参数的变化,得到这小段的平均斜率:
(3.9601-4.0401)÷(2.01-1.99)=-4。
对这条平方曲线,在v=2处的局部斜率也恰好是-4。单个参数时,它就是本例要用的梯度;多个参数时,梯度是一组数,分别说明每个参数单独微调时,损失在当前位置怎样变化。这里的-4不是预测误差-2,也不是损失4。
为什么要沿“减去梯度”的方向走?在足够小的范围里,可以先把曲线看成一条斜线:损失变化大约等于梯度乘参数改变量。现在梯度是负数,让参数增加一点,乘积就是负数,意味着损失下降。梯度为正时,反过来减小参数。这一步用的是附近的变化规律,尚未保证远处也一样。梯度下降的基本机制
令学习率为0.25。学习率决定沿这个方向走多远,更新规则是:
新v=旧v-学习率×梯度=2-0.25×(-4)=3。
重新前向计算,预测变成4,损失变成1。看图1时,先找横轴上的参数2,再找纵轴上的损失4;橙色切线表示当前位置的斜率,蓝色落点表示更新后重新计算出的损失。箭头本身不会替代这次复算。
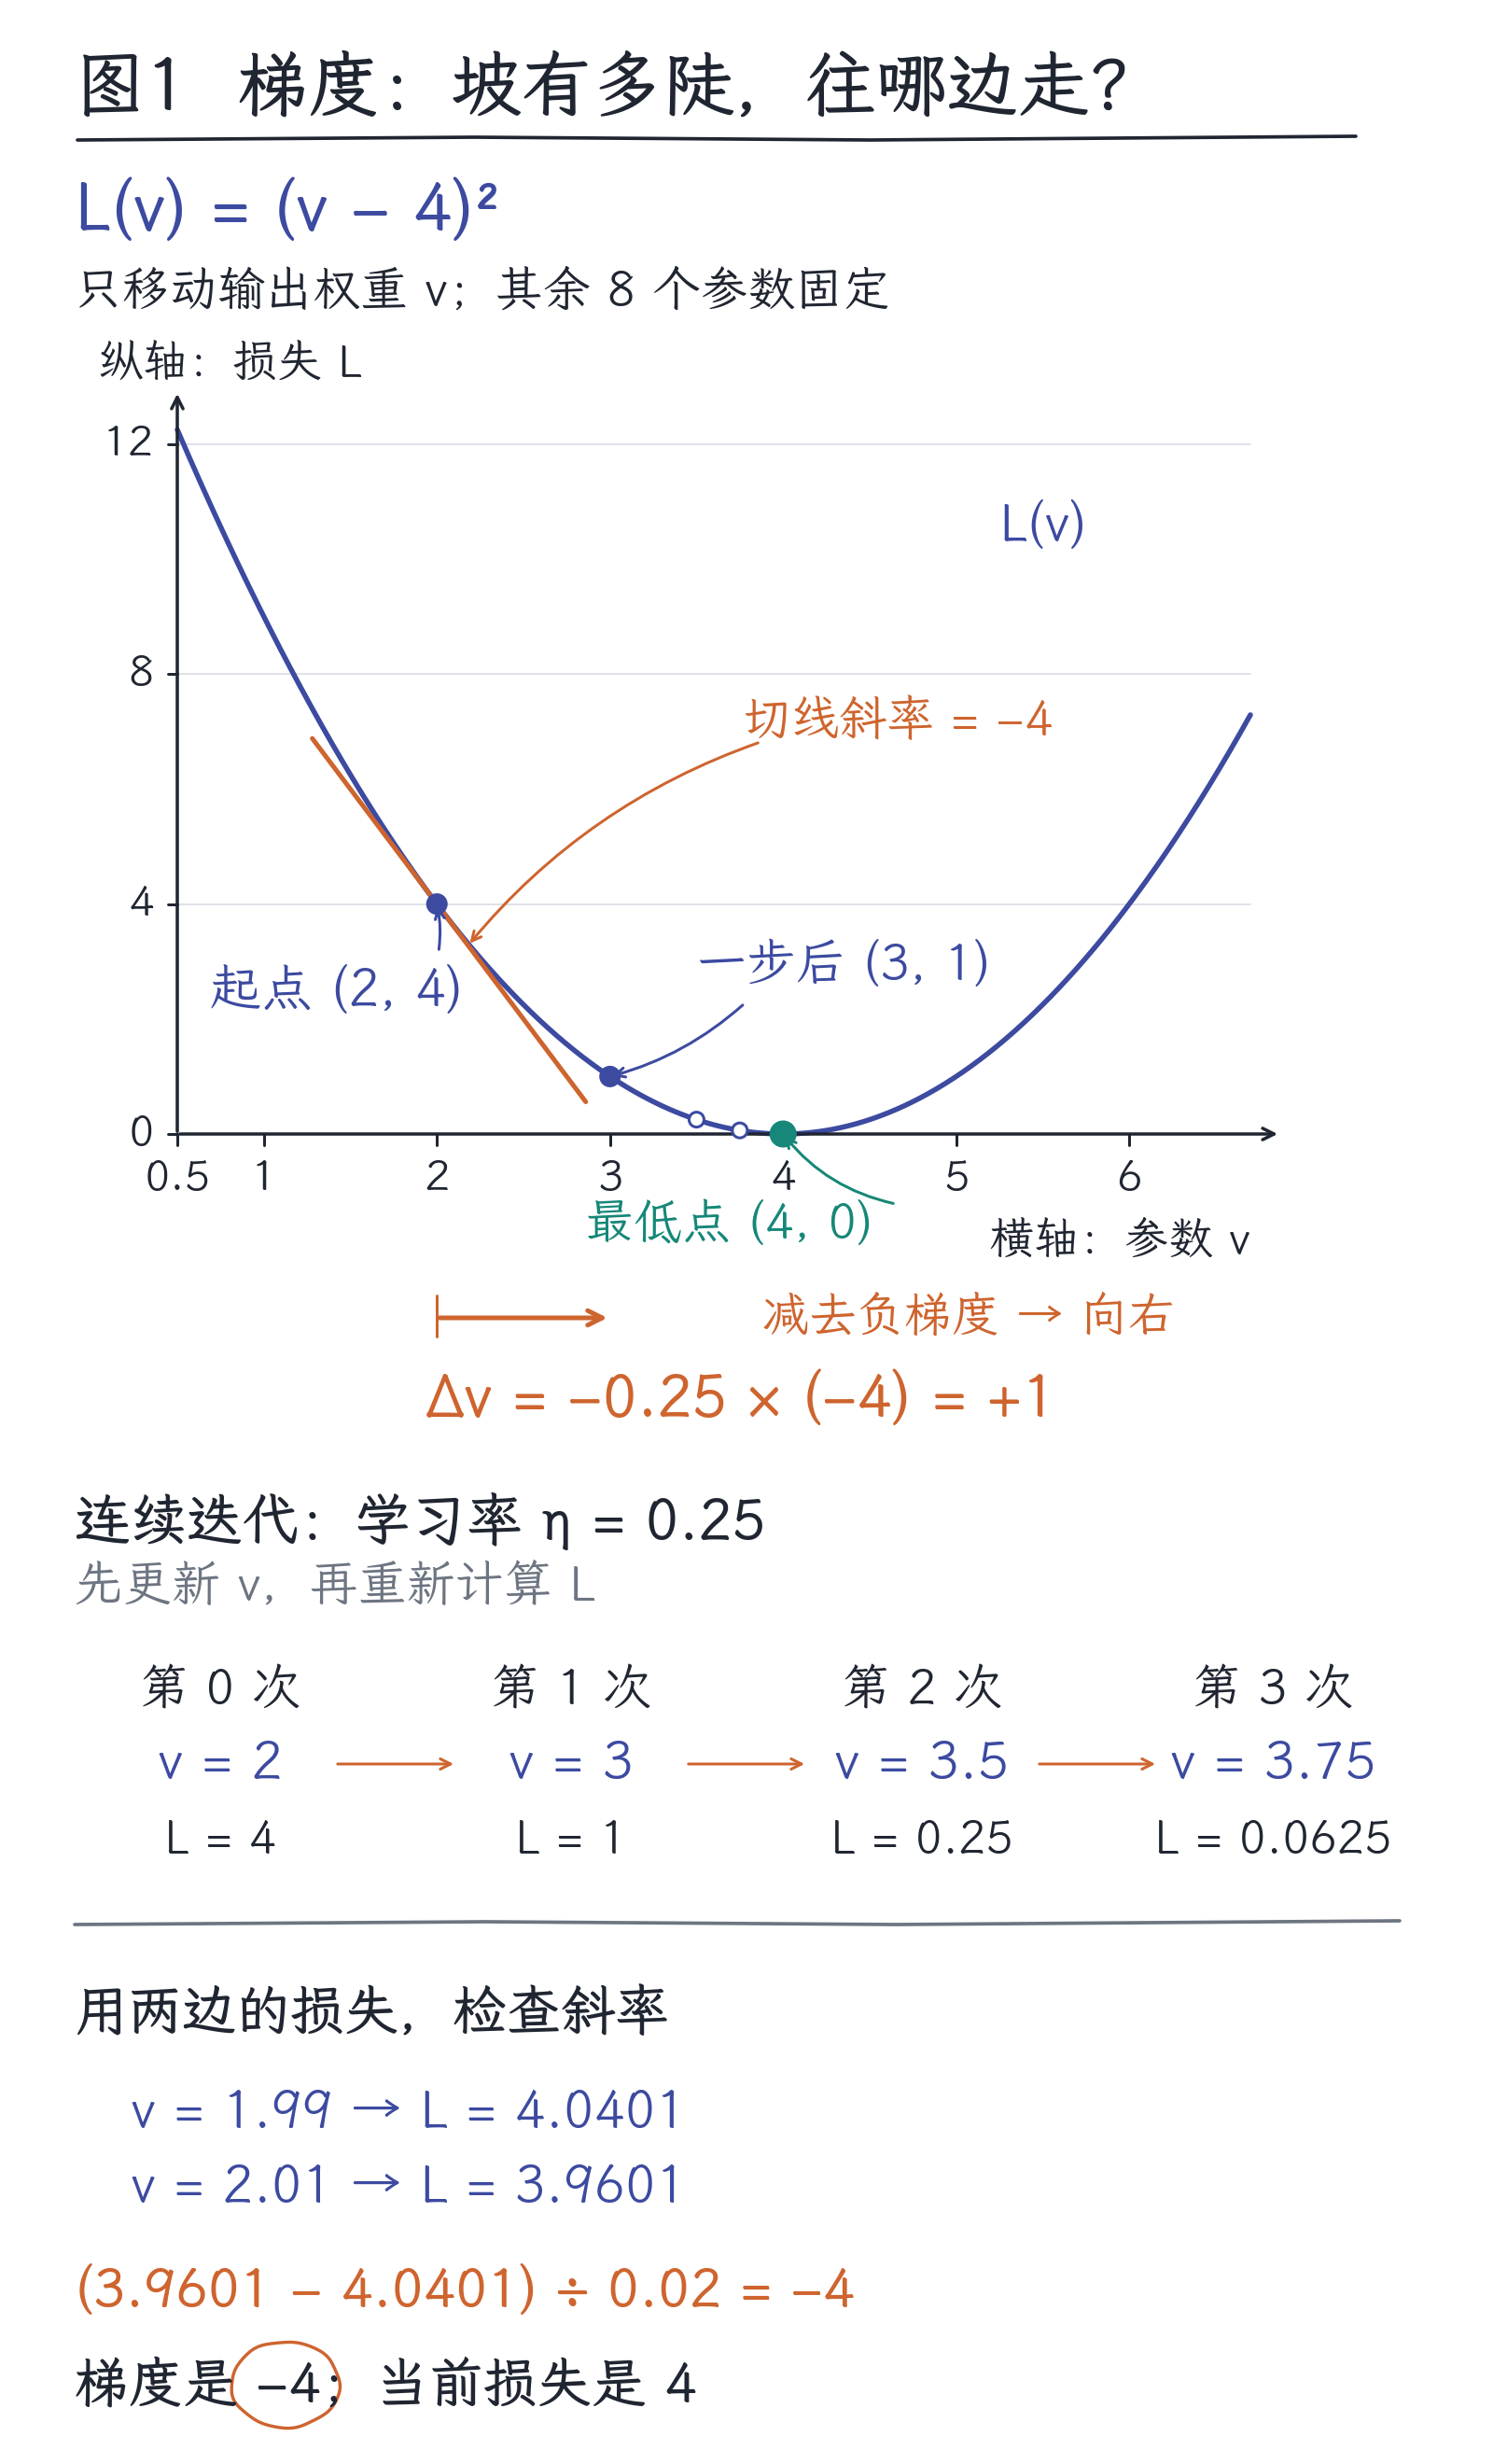
图1|横轴是参数v,纵轴是损失L。曲线由L=(v-4)²实际计算;从(2,4)出发,以学习率0.25更新到(3,1)。后续迭代都要在新位置重新求梯度,不能一直使用第一次的-4。
3.同一条下坡方向,步长不同会发生什么
从v=3接着训练,当前位置的梯度已经变为-2。仍用学习率0.25,下一步得到3.5,损失0.25;再算一次,梯度为-1,得到3.75,损失0.0625。参数逐渐接近4,每次改变量也在变小。
这与“从v=2出发试三种步长”是两种实验。若重新回到相同起点,学习率0.05只走到2.2,损失3.24;学习率0.25走到3,损失1;学习率1.25却跨到7,损失9。第三种走法起初指向下降一侧,最后却落在更差的位置。
再看学习率为1的连续更新。第一步从2跳到6,梯度从-4变成4;第二步又从6跳回2。两个位置的损失都是4。它每一步都使用了当前的正确梯度,却在最低点两边来回跳,始终没有改善。
图2把时间展开了。它的横轴是更新次数,纵轴是参数v,与图1的“参数—损失曲线”不同。曲线趋近目标线,说明这组参数序列正在靠近4;不能把图上的折线斜率误认成损失的梯度。
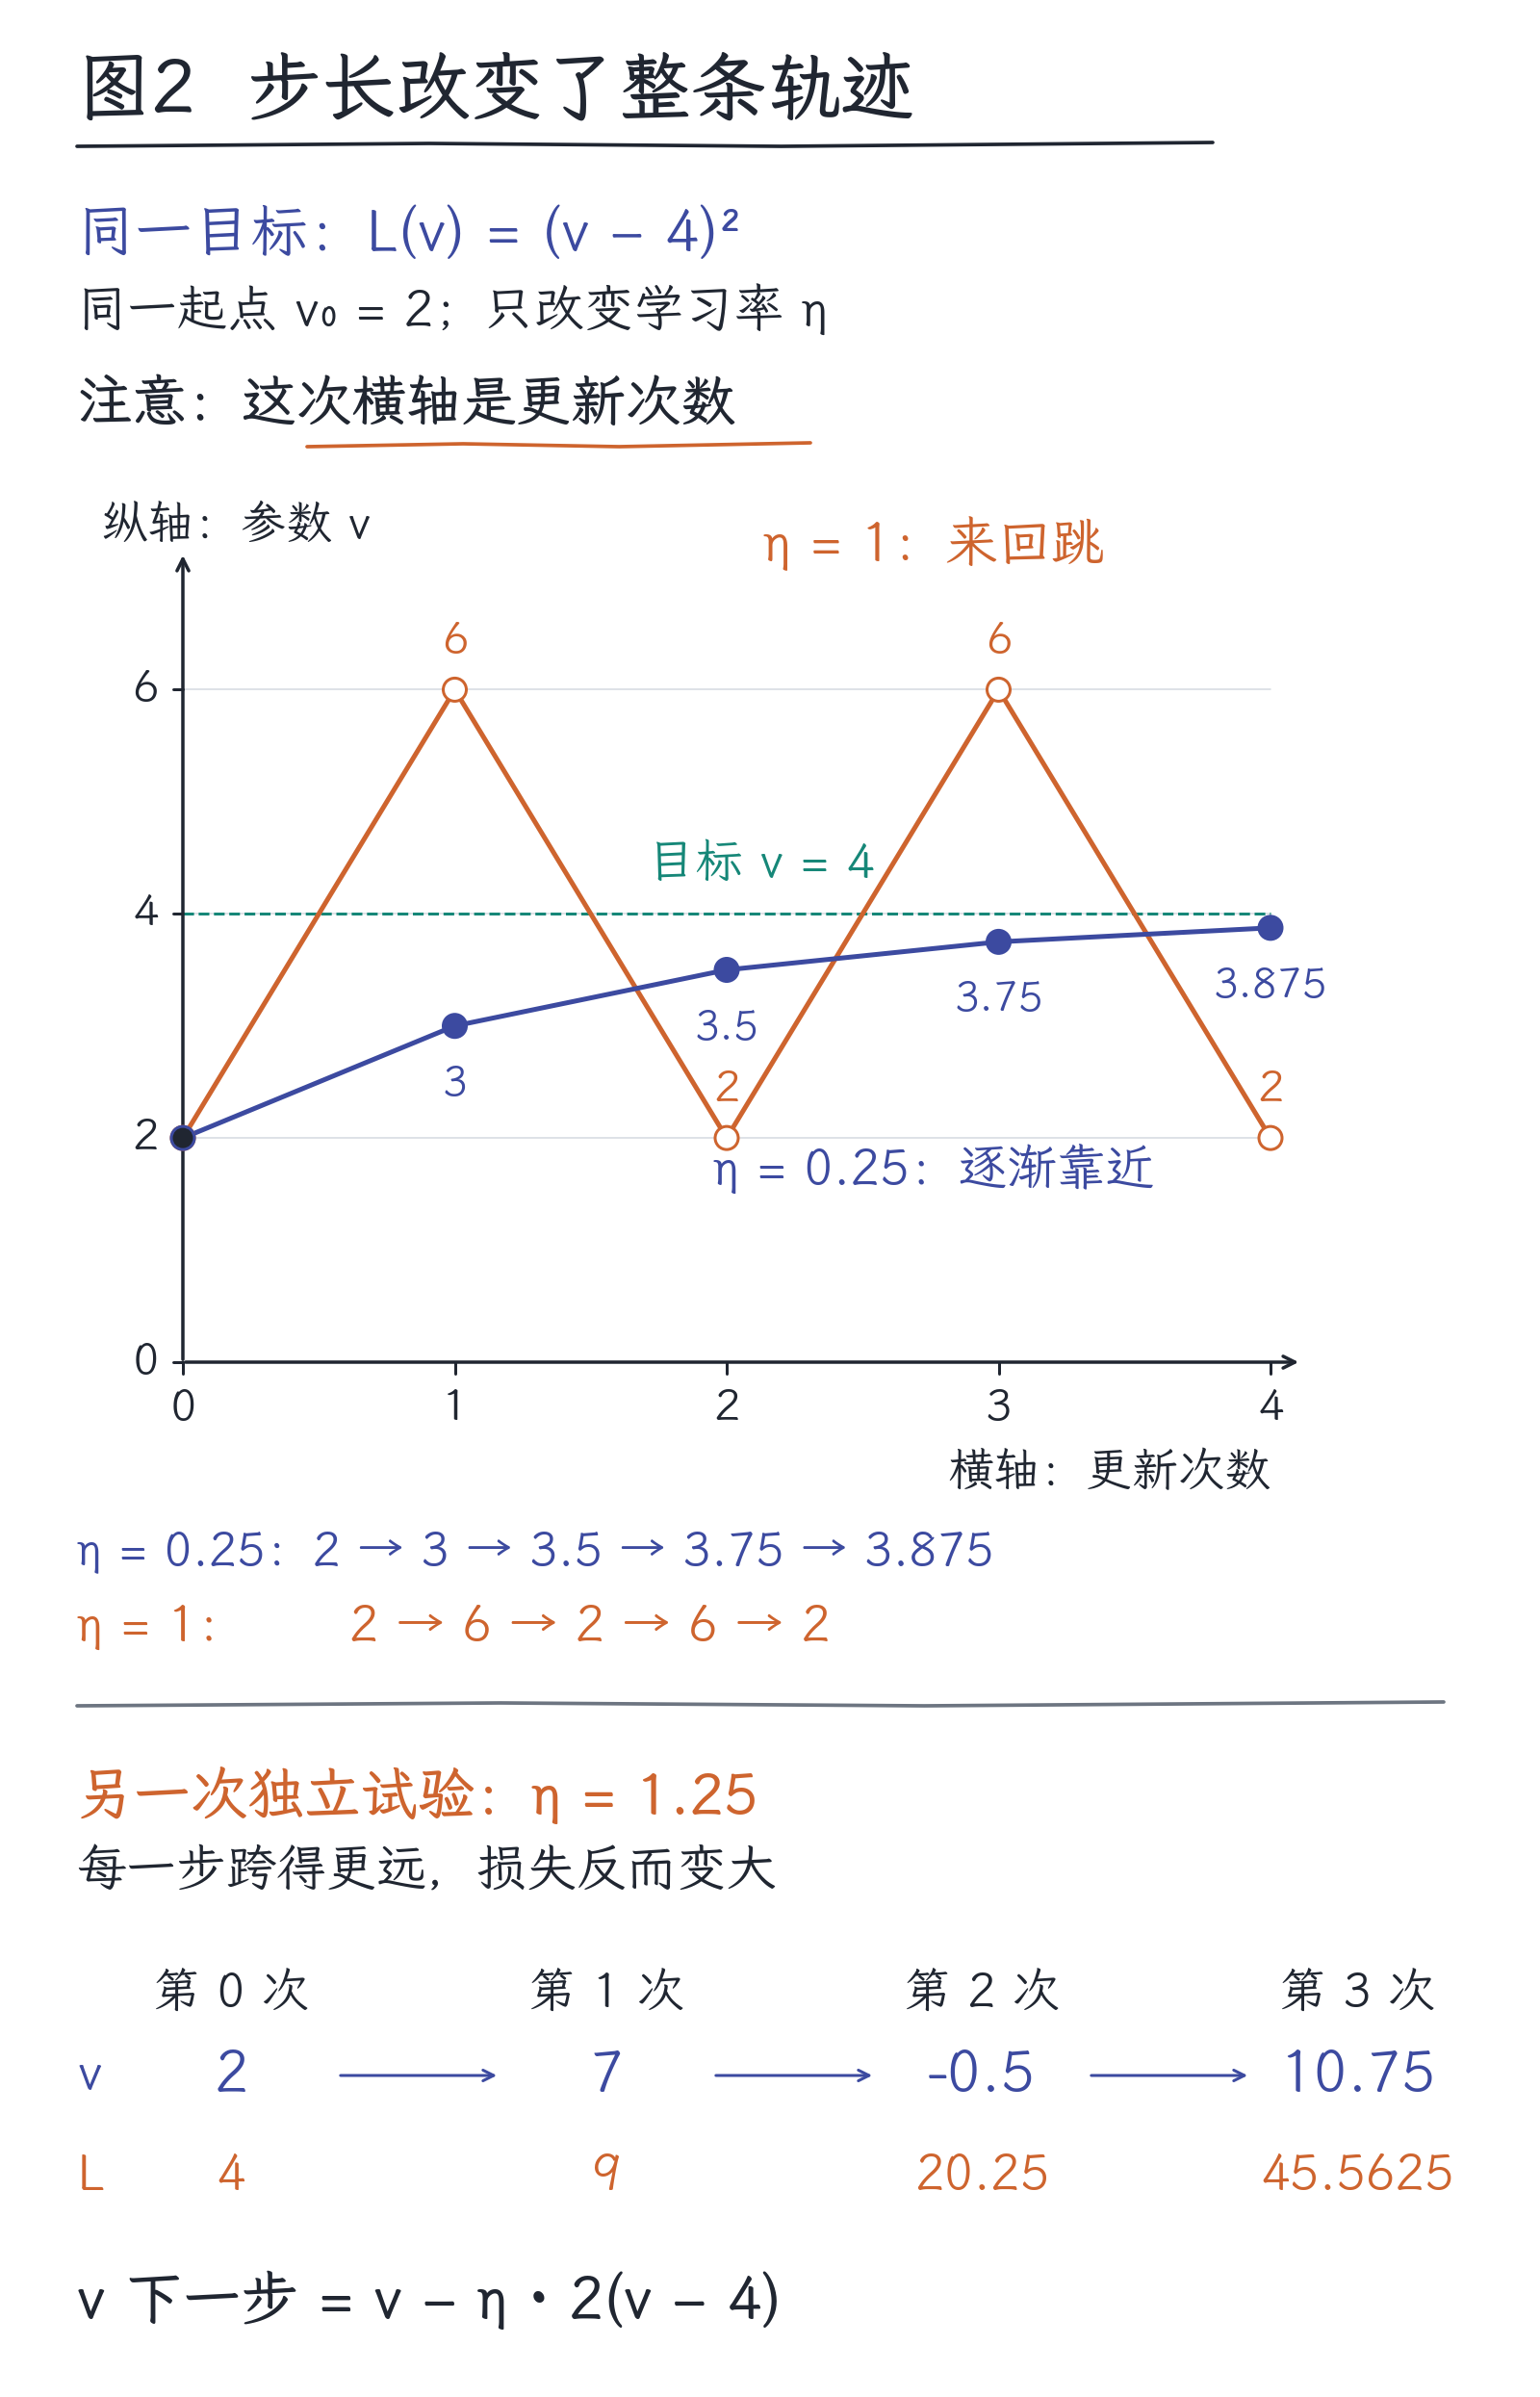
图2|三次独立试验都从v=2开始。学习率0.25逐步接近4;学习率1在2和6之间振荡;学习率1.25的偏离逐步扩大。数字只适用于本章的平方损失,不是训练真实模型时可照抄的学习率范围。
选读:这个例子为什么能算出稳定的步长范围
本例梯度为g=2(v-4)。将它代入更新式,新v-4=(1-2η)×(旧v-4),η表示学习率。离最优点的距离,每次乘上同一个系数。
当0<η<1时,系数的绝对值小于1,距离会缩小;η=0.5时一步到达4;η=1时系数为-1,只换方向、不缩小距离;η>1时距离会扩大。η介于0.5和1之间,也会越过最低点,但越过的幅度逐渐变小。
这个结论依赖当前的平方函数、精确梯度和固定学习率。不能据此宣称所有神经网络只要学习率小于1就会稳定。
真实训练的损失地形通常更复杂。梯度很小可能是接近一个局部平坦位置,也可能经过鞍点附近;它不自动证明任务已学好。小批次的梯度还有抽样波动,因此训练损失不必每一步都下降。
4.反向传播怎样把局部影响传到前面的权重
刚才改两次参数、重新计算损失,叫有限差分。用它解释斜率很直观,但若为几十亿个参数分别运行整张网络,代价会很高。反向传播利用计算图中的局部关系,把已经算过的中间结果复用起来,从最终损失往回求梯度。PyTorch自动微分说明
回到第06章的原始参数,暂时还没有更新任何权重。A单元先算2×1+1×(-1)+0=1,经过ReLU仍是1;B单元先得到-1,经过ReLU变成0。输出层算1×2+0×1+1=3,目标5,损失4。
沿A的第一条权重看影响怎样传递。这条权重增加一小点,先被输入2放大成两倍的A加权结果变化;A当前为正,ReLU局部保持原值;隐藏输出再被输出层权重2放大;最后,在预测3这个位置,损失随预测变化的斜率为-4。
把这条路径的四个局部变化率相乘,得到:
A的第一条权重的梯度=2×1×2×(-4)=-16。
这是链式法则的直觉:前一步多变一点,会让后一步多变多少,一路接起来。计算时也可以从损失一侧往回乘,所以图3按-4、2、1、2的次序标注,结果相同。图中的∂L/∂y可读作“损失对输出的局部斜率”,表示其余独立量固定时,微调输出y会怎样影响损失L;其他类似记号也按同样方式读。
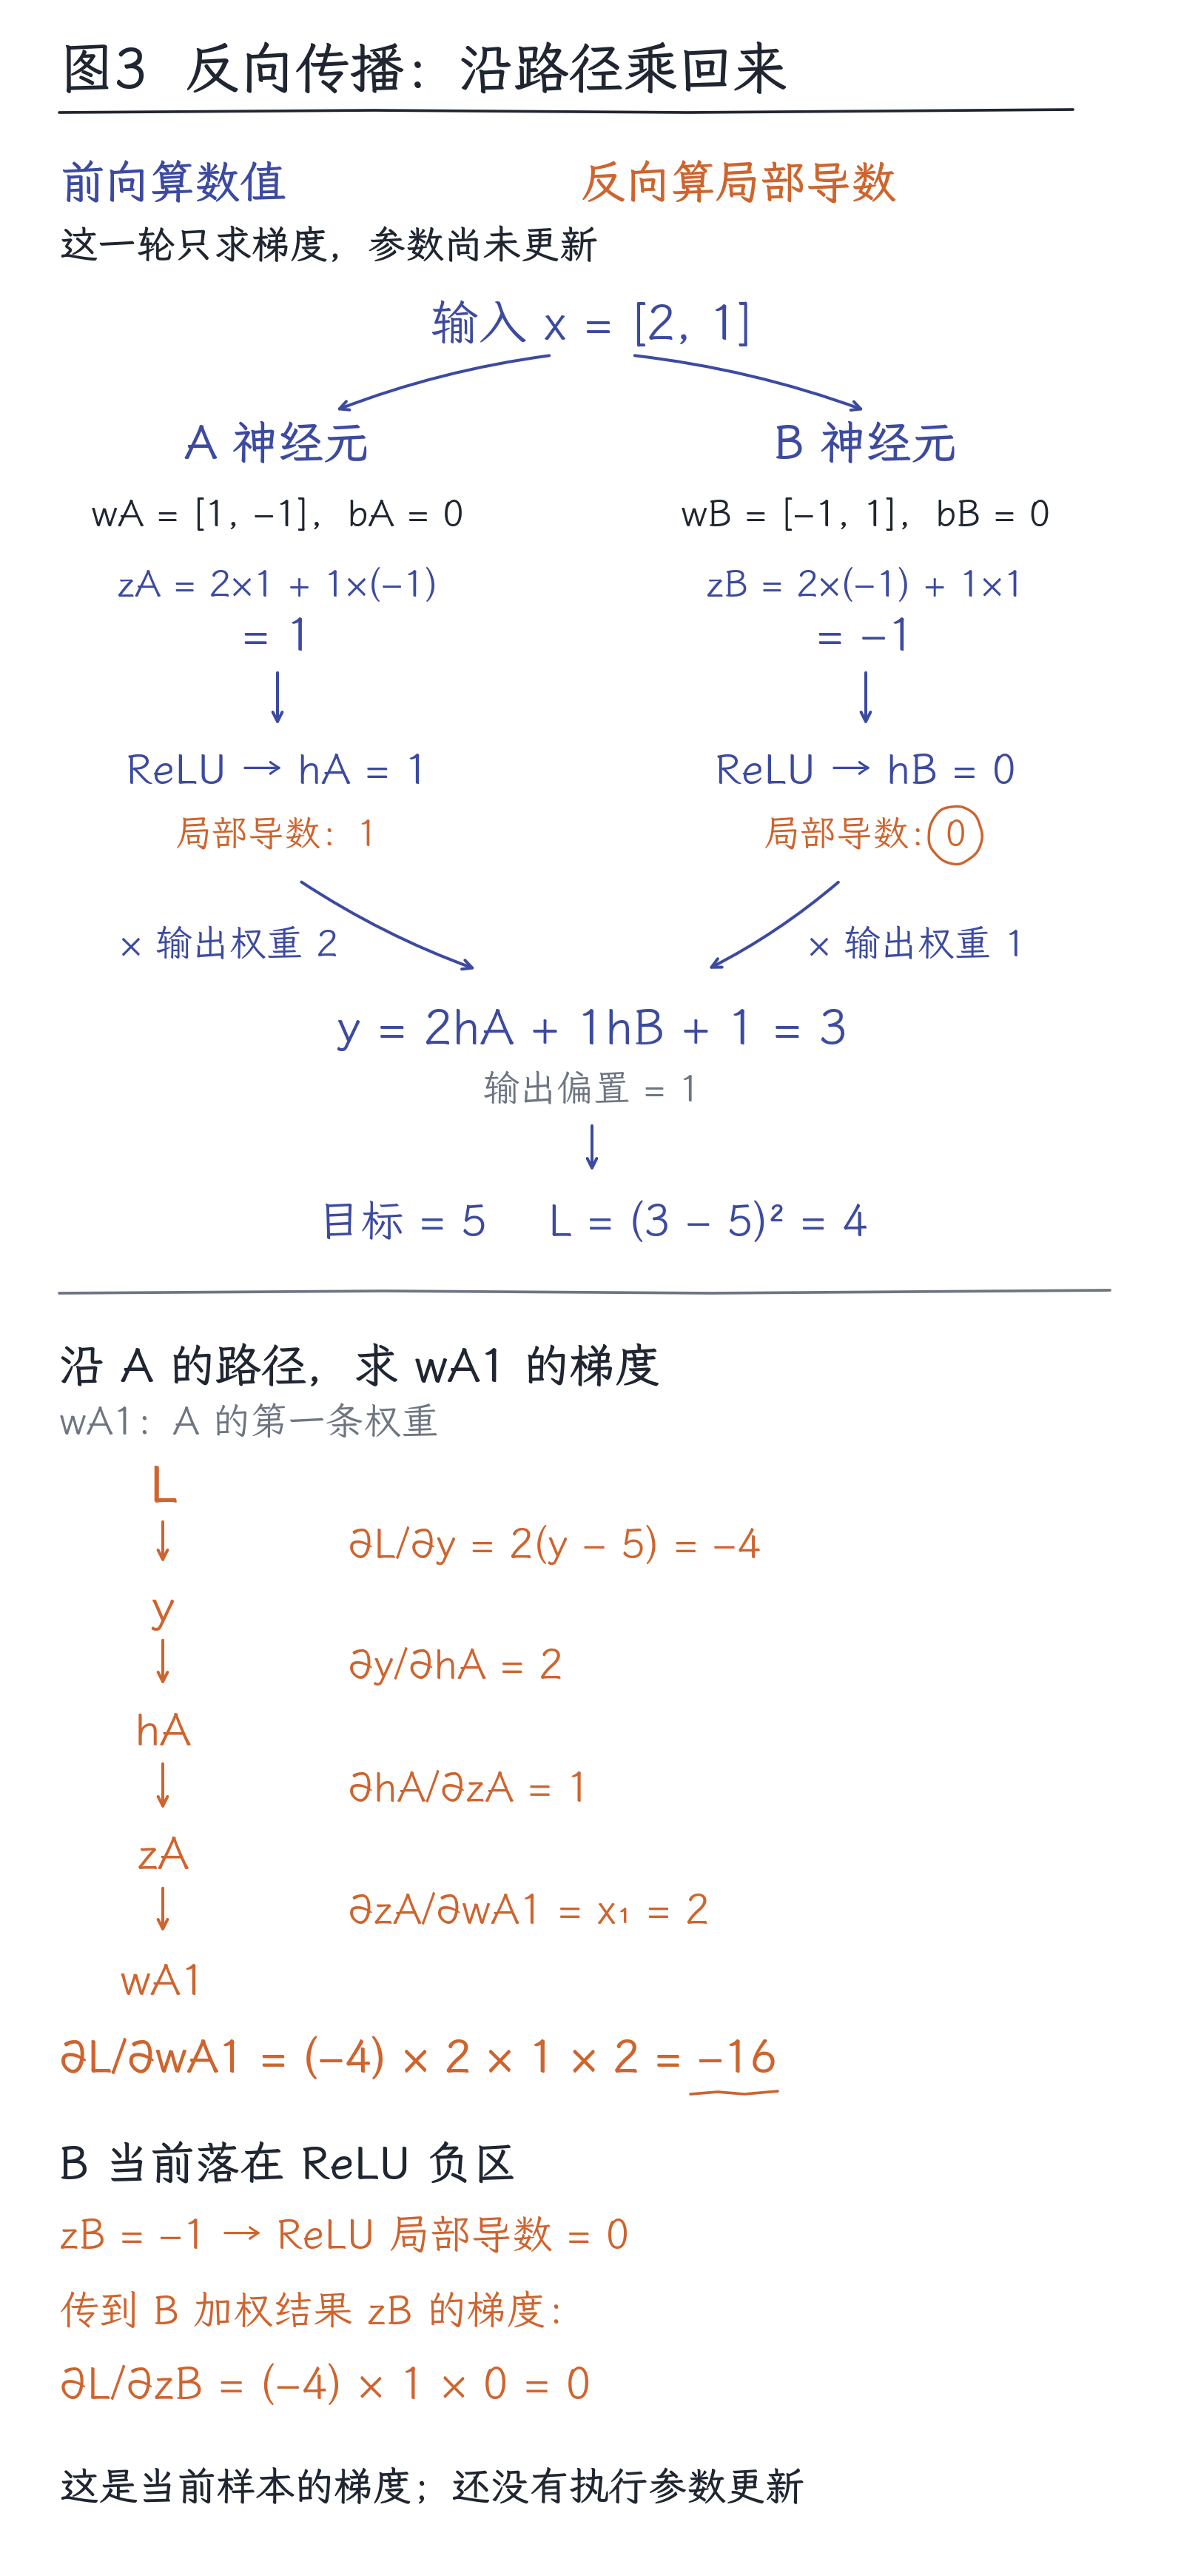
图3|前向数值回答“这次算出了什么”,反向局部导数回答“前一个数微调时,后一个数怎样变”。A路径得到-16;B当前处在ReLU的负值区域,局部导数为0,所以这条样本沿B向更早参数反向传回的梯度为0。本图只计算梯度,尚未同时更新这些参数。
一个变量如果影响多个后续分支,各条路径的影响还要相加。反向传播因此既不是把误差平均分给所有权重,也不是从目标答案反推出唯一正确的网络。
这里还要区分两份数:输出层权重v的梯度是-4,A第一条权重的梯度是-16。它们对应不同参数。若把更多参数同时更新,隐藏表示也会变化,必须重新算完整网络,不能再套用“隐藏表示固定时y=v+1”的简化式。反向传播负责求梯度,随后优化器才据此修改参数。
5.把梯度当作可以检查的计算结果
这一步与软件工程里的测试有自然联系。若有人实现了反向传播,我们可以先给它一个足够小、答案能独立算出的例子,检查返回的梯度,而不是只看训练程序是否顺利运行。
例如,把A的第一条权重从1分别改为1.001和0.999,其余参数固定。两次预测分别为3.004、2.996,损失分别为3.984016、4.016016。有限差分给出:
(3.984016-4.016016)÷0.002=-16。
它与计算图求出的结果吻合。这类似用另一条计算路径建立测试依据,可以发现符号写反、漏乘一层或错误连接等问题。PyTorch也提供把解析梯度与小扰动得到的数值梯度比较的检查工具。梯度检查的官方说明
要让这个检查成立,两次计算必须使用同一输入、目标和损失定义,而且都从原始参数出发,只扰动正在检查的那个数。若第二次换了样本,或先执行了一次参数更新,损失差就混入了其他原因。实际计算若还包含随机环节,也要控制这些变化,才能把差值归因于参数扰动;固定随机种子本身并不保证跨设备、跨版本逐位一致。这里的小网络没有随机步骤,正适合作为先独立核对的测试例。PyTorch对可复现条件的说明
检查仍有条件:扰动过大,不再代表附近;过小,可能被有限精度误差影响;落在ReLU的转折点附近,两种检查也可能表现不同。因此,“梯度检查通过”支持的是这段求导实现,在这些测试条件下基本一致。它不能替代数据质量检查,更不能证明模型会正确回答新问题。
6.多条样本的意见,怎样形成一次更新
只照顾当前一条样本,可能让另一条变差。小批次训练把一部分样本一起纳入目标。若同一参数在两条样本上的梯度分别为-4和2,目标取两条损失的平均,那么平均梯度就是-1。第一条希望参数增加,第二条希望它减少,合起来仍倾向增加,但幅度较小。
这里汇总的是带有大小的数,不是“一票赞成、一票反对”。若把损失从平均改成求和,梯度变为-2;即使学习率不变,更新幅度也改变了。训练的目标定义与实现方式需要一致。
序列长短不同还会带来一个容易忽略的细节。某个微批次只有1个有效token,平均损失2;另一个有3个有效token,平均损失4。若目标是对全部有效token取平均,合并后应为(1×2+3×4)÷4=3.5,不能简单把两个平均数再平均成3。对应梯度也需要按目标采用相同的权重口径。梯度累积与有效token归一化
显存装不下较大批次时,可以逐个处理微批次,在参数不变的情况下汇总梯度,然后只更新一次,这叫梯度累积。若每处理一个微批次就更新,后面的计算已经用上新参数,不再是同一件事。完成这一轮后,还要按计划清空梯度,避免把不该混入的上一轮信号继续累加。
批次更大可以减少部分抽样波动,但不会纠正一致的坏标注。方向很稳定与方向有价值,仍然是两种判断。
7.为什么训练需要保存更多东西
最直接的优化器使用当前梯度更新参数。动量方法还会保留过去方向的平滑记录;Adam跟踪梯度及其平方的两组统计,调整各参数的更新尺度。AdamW将权重衰减与梯度统计分开处理。真实更新因此未必等于“所有参数套用同一个固定步长”。AdamW的算法说明
这些历史统计称为优化器状态。若希望中断后继续训练,通常还要保存它们、训练步数和相关调度状态;只拿回模型权重,未必能延续原来的数值轨迹。这与工程中恢复一个长任务类似:输出文件、当前进度和恢复所需的运行状态,不是同一份东西。保存和恢复训练检查点
显存中也要分清四类对象:参数决定怎么算;激活是当前输入经过各层的中间结果;梯度记录当前目标的局部影响;优化器状态保存更新所需的历史。参数量不变,输入变长,激活占用仍可能明显增加。
做一笔简化账:100万个可训练参数,假设参数、梯度和Adam两组统计的每个数都用4字节,那么它们分别占4 MB、4 MB和8 MB,合计16 MB。这里1 MB按100万字节计算,尚未包括激活、临时对象和运行开销,不能拿它当真实训练显存预测。训练内存中存放的对象
激活检查点会少保存部分中间结果,在反向时重新计算,用计算换存储。它与“保存训练进度”的检查点用途不同。后面的LoRA则主要减少需要更新的参数及相关状态,不能由此推断所有激活占用也按相同比例减少。激活检查点的官方说明
8.在真实训练配置里辨认这些机制
Qwen官方文档提供Qwen3-32B的Axolotl训练入口。现在先把它当作可检查的真实配置,不需要提前学会第14章的QLoRA,也不需要运行训练。Qwen官方训练说明
固定在Axolotl v0.9.2的示例中,学习率为0.0002,微批次大小为1,梯度累积步数为2,序列长度为2048,还设有余弦学习率调度及10个预热步骤。它们分别控制更新尺度、每次处理多少序列、何时更新和一次容纳多长的输入。固定版本配置
在单卡条件下,累积2次可以理解为处理两个微批次后更新一次。但配置启用了样本打包,一个序列可能装有多条原始样本,不能直接说每次更新恰好看了两条对话。学习率也不能与本篇的0.25直接比较优劣,因为目标尺度、参数、数据与优化器都不同。
这份配置的验证集比例为0。它给出了训练设置,却没有因此证明泛化已经改善。阅读真实项目时,“程序能训练”和“模型值得采用”之间,还缺一组独立的结果。
9.训练误差下降以后,什么才算通过检查
设五次检查的训练损失为1.2、0.9、0.7、0.5、0.4,验证损失为1.3、1.0、0.9、1.0、1.2。这些是人工教学数字。训练越来越贴合已有样本,但第三次检查以后,验证表现反而退步。
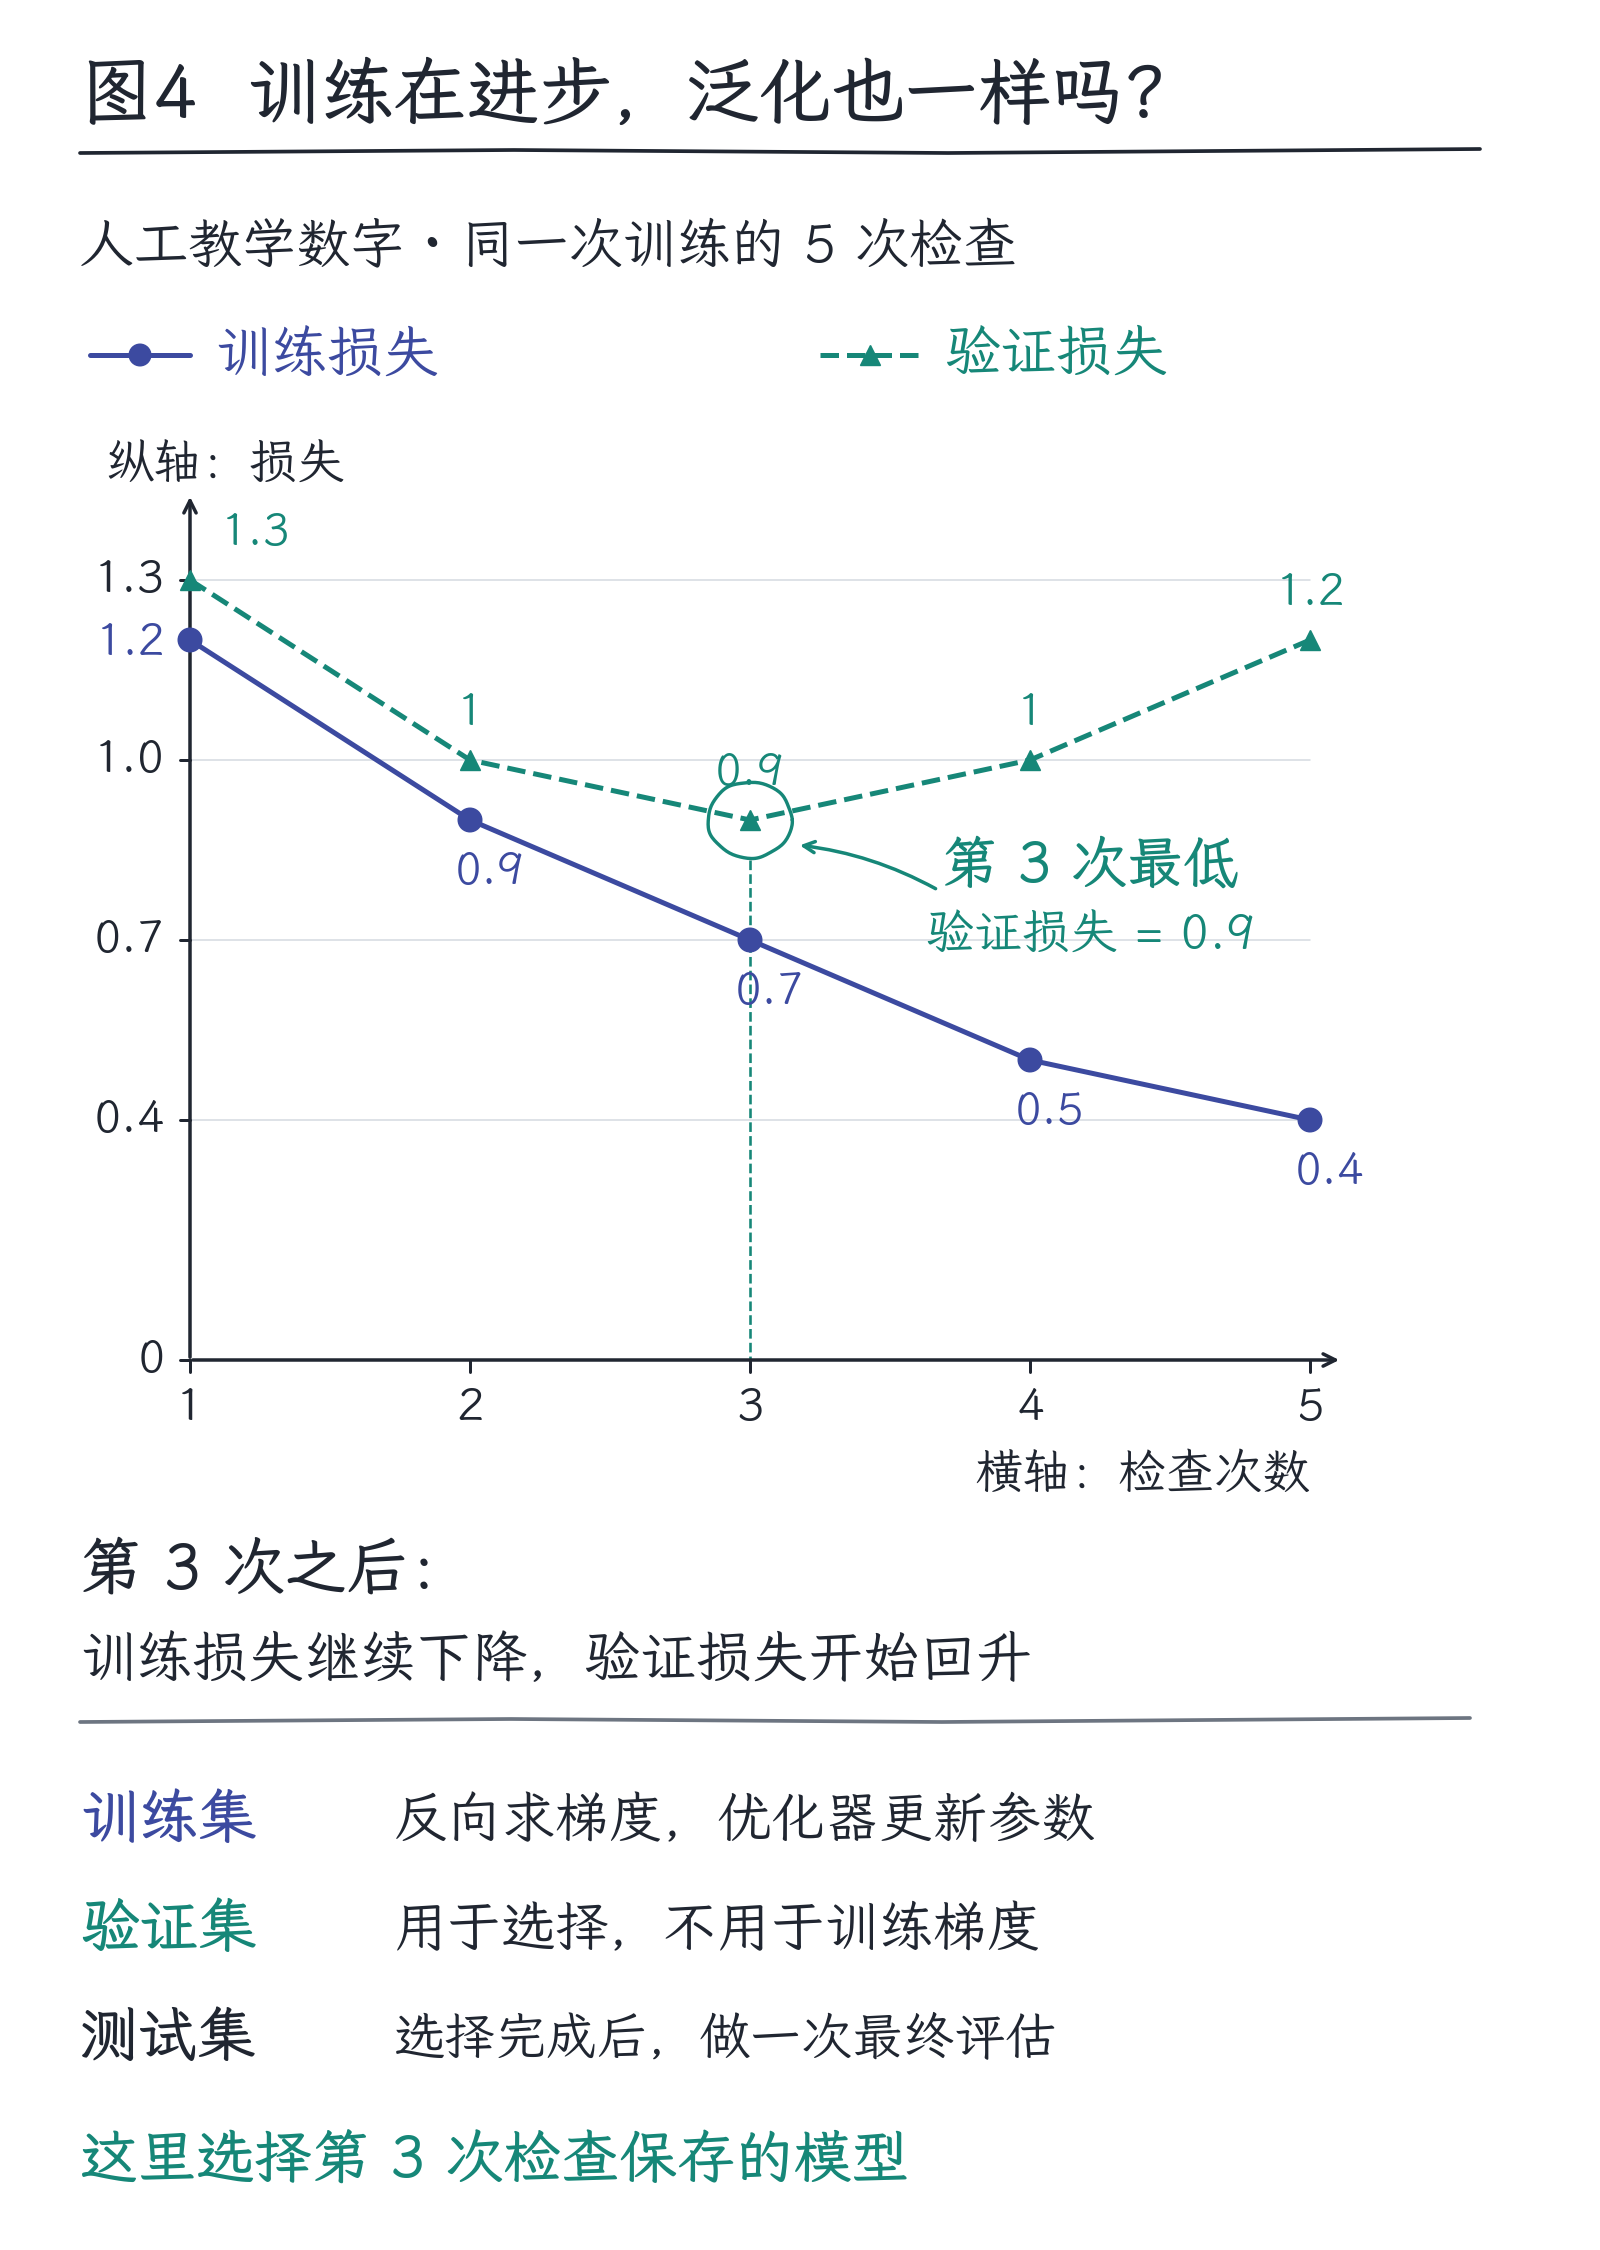
图4|同一组五次检查中,训练损失持续下降,验证损失在第3次最低。验证数据不参与这次反向更新;根据它选择检查点后,再用未参与选择的测试集评价。图中数字用于说明判断方法,不是某个真实模型的训练报告。
若只按训练损失挑选,会选择最后一次;按这组验证记录,则第三次更值得保留,再用独立测试和实际任务检查。真实曲线有噪声,不能把一次轻微波动都判成过拟合;反复看同一验证集并调参,也会逐渐影响对它的适应。
这与软件测试的联系是:先写清希望满足的行为,再保留能暴露未知问题的检查。训练损失是一种反馈,验证集帮助选择,测试集评估最终选择;它们承担不同职责。梯度方向正确、程序无报错、训练损失下降,都只是证据的一部分。
本章练习
题目
问题1|再走一步
仍只更新v,其余8个参数固定。当前v=3,梯度为-2,学习率为0.25。下一步v、预测y和损失L分别是多少?
问题2|方向正确为何仍不进步
从v=2开始,采用学习率1,连续更新两次。写出每次更新后的v和L,并解释为什么没有改善。
问题3|累积与更新
两个等权样本在同一套参数上的梯度分别为-4和2,目标取平均。先累积再更新时,使用什么梯度、更新几次?如果每条样本之后都更新,还能直接复用这两个数吗?
问题4|测试究竟支持什么结论
有限差分与反向传播都给出A第一条权重的梯度-16,训练损失也持续下降。这是否足以证明模型值得采用?结合图4,说明还需要什么证据。
思考提示
提示1|对应问题1
先按更新式修改参数,再重新算预测,最后算损失;不要只更新损失数字。
提示2|对应问题2
第二次更新需要在新位置重新求梯度。比较离最优参数4的距离,而不只看每次往哪边走。
提示3|对应问题3
区分“收集一次梯度”和“改动一次参数”。两条梯度被明确限定在同一套参数上。
提示4|对应问题4
把计算实现正确、拟合训练样本、适用于新数据三个判断分开,看看每项证据支持哪一种。
参考答案与解析
答案1|对应问题1
新v=3-0.25×(-2)=3.5;预测y=3.5+1=4.5;损失L=(4.5-5)²=0.25。这个复算仍依赖其余参数固定的条件。
答案2|对应问题2
第一次得到v=6,L=4;此处梯度是4,第二次得到v=2,L仍为4。参数始终离4相差2,只是在两侧切换。步长使它跨过最低点太远,局部方向正确没有带来更新后的改善。
答案3|对应问题3
平均梯度为(-4+2)÷2=-1,汇总后更新一次。若先处理第一条就更新,第二条的梯度应在新参数上重算,不能继续假定它等于2;两种执行方式一般不等价。
答案4|对应问题4
不足以。两种梯度计算一致,为这个小例子的求导实现提供了检查;训练损失下降说明训练目标改善。图4却显示后期验证损失升高,应关注第3次检查点,再用独立测试和实际任务评价。是否采用还取决于目标任务、数据覆盖和可接受的失败,不能由这两个训练现象直接推出。
下一章
现在我们知道参数怎样从错误中调整,也知道“计算正确”和“学得有用”需要不同证据。接下来还有一个问题:同一个词出现在不同句子里,模型该从周围哪些位置取信息?下一章用一次完整的Attention计算,追踪匹配分数怎样变成读取权重。