看到一张神经网络结构图,你可能认得输入层、隐藏层、输出层,却仍说不出任何一个圆点里发生了什么。输入两个数,沿着几条线走过去,为什么就变成了另一个数?
这一篇把网络缩小到能在纸上完整算完的程度。所有参数都手工指定,不代表某次真实训练的结果。我们先看清一套参数怎样产生答案,下一章再解释参数怎样从错误中更新。
本篇所说的两层,是两层带参数的变换:一层隐藏层,加一层输出层。输入只是送进来的数,不额外计作一层带参数的计算。读真实模型报告时,也要留意“层”指的是单个变换,还是装着多个变换的完整模块。
1.一条连线,先落实为一个乘法
设输入向量是[2,1]。向量在这里就是按顺序放好的两个数,分别记作x₁和x₂。不必把它们解释成“聪明程度”或“语义强度”;暂时只跟踪计算。
第一个计算单元A,对第一项乘1,对第二项乘-1,再把它们相加,最后加0:
A的加权结果=2×1+1×(-1)+0=1。
乘在输入上的1和-1叫权重。权重决定一项输入以怎样的方向和尺度参与组合。最后加的0叫偏置,它允许整组结果整体移动。这里的偏置是一个数学加数,与社会偏见不是同一个概念。
一般写法是:加权结果=w₁×x₁+w₂×x₂+b。x₁、x₂是当前输入,w₁、w₂、b则是这个单元的参数。改变输入和改变参数,都能影响输出,但发生的是两种不同的事。
偏置虽然常被画在角落,作用并不小。如果所有输入都是0,加权和必然是0;有偏置,单元仍可以先输出b。配合稍后介绍的激活函数,偏置还可以移动计算开始产生响应的位置。
第二个计算单元B也接收同一份输入,换一组权重:
B的加权结果=2×(-1)+1×1+0=-1。
同样的两个数,经两种组合,变成[1,-1]。这就是一层计算能够形成多个方向的信息的最小例子。Google机器学习课程:节点、权重与隐藏层
2.激活函数给加权结果再做一次变换
接下来,对刚得到的每一个数应用同一条规则:负数变成0,非负数保持原值。这种激活函数叫ReLU。
于是,1仍是1,-1变成0。把两个结果放在一起,得到隐藏表示h=[1,0]。激活函数是计算规则,“激活值”则是这条规则处理当前输入后得到的数,两者需要区分。ReLU的定义
用这个例子看偏置会更清楚。A原先计算x₁-x₂,只有第一项大于第二项,经过ReLU后才得到正数。若把A的偏置改为-2,它就先算x₁-x₂-2,必须第一项比第二项大超过2,结果才为正。偏置移动了转折所在的位置。
为什么要加这一步,后面会用折线证明。现在先记住一个边界:ReLU只是常见选择之一,网络并非都把负数归零;它也没有把每个结果变成“开”或“关”两个值。输出可以是1、2或其他任意正数。
3.把隐藏表示送到第二层
第二层收到的是[1,0]。给它的两项分别乘2和1,再加偏置1:
输出y=1×2+0×1+1=3。
这个例子的输出层不再使用ReLU,直接把3作为结果。输出需要做什么变换,要看任务:预测一个数、给类别打分、计算概率,要求可能不同。因此,这里的3不能直接称作“概率”。
到这里,一次前向计算就完整了:
[2,1] → 加权结果[1,-1] → ReLU后[1,0] → 输出3。
图1把每条权重写在对应连线上,偏置单独进入加法。沿着输入2经过A的那条路径走一遍,可以逐一找到“乘1、经过ReLU、再乘2”,这条路径也会在下一章求梯度时用到。
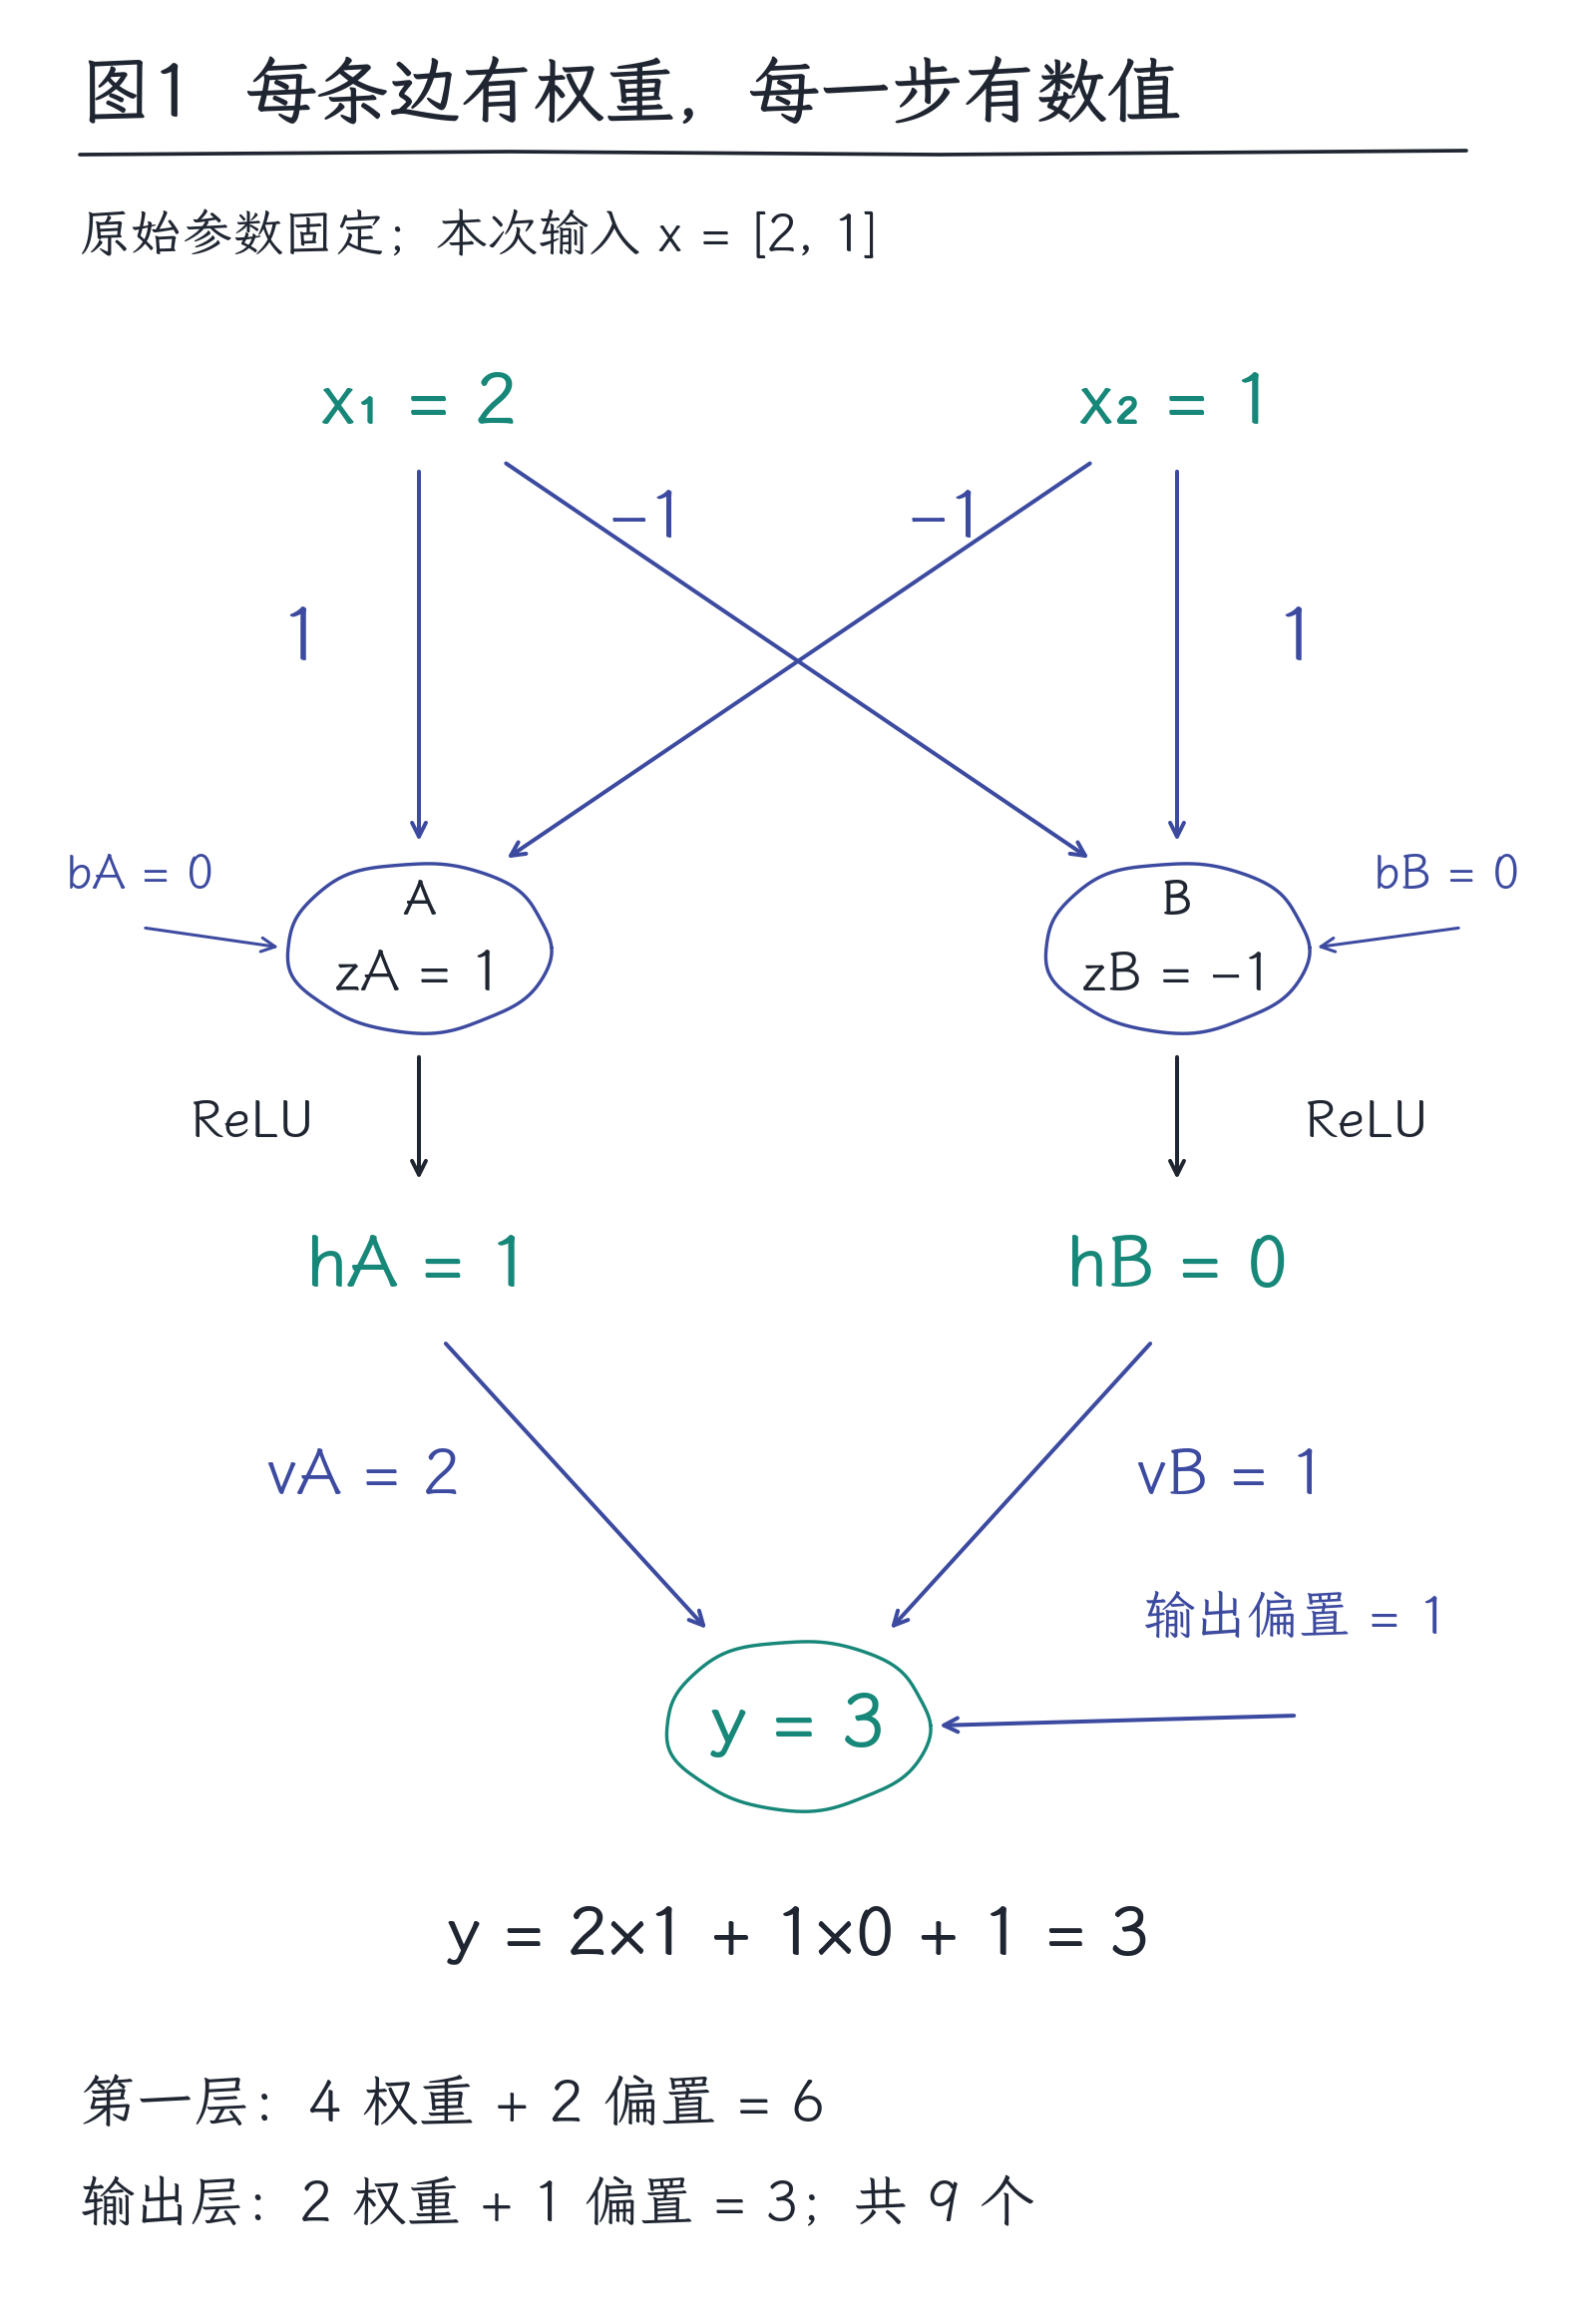
图1|原始9参数网络:A的两条输入权重为[1,−1]、偏置0;B为[−1,1]、偏置0;输出权重[2,1]、偏置1。靛蓝连线标参数,节点文字标本次值;输入[2,1]得到z=[1,−1]、h=[1,0]、y=3。
试着换一份输入[1,3]。A先得到1-3=-2,B先得到-1+3=2;ReLU得到[0,2];输出为0×2+2×1+1=3。
两次输出恰好相同,内部路径却不同:第一次主要使用A的正值,第二次主要使用B的正值。这已经比“直接把两个原始输入按固定比例相加”多了一种能力:根据输入所在的区域,不同组合可以产生不同响应。
再算[2,2]。两个加权结果都是0,隐藏表示[0,0],最终输出1。任何一步都没有神秘判断,只有已经写明的乘法、加法和取非负值。
还可以反过来做一次实验:固定输入,只改A连接第一项输入的权重,从1改成2,其他参数不动。输入[2,1]时,A先得到3,B仍为-1,隐藏表示成为[3,0],最终输出7。输入[1,3]时,A却仍为负数,得到-1;经过ReLU后依旧是0,输出继续为3。
同一个参数改动,对不同样本的影响可能不同,甚至有的样本完全不受影响。这也提醒我们,不能只看一条样本来决定参数怎么改;稍后讨论训练时,需要同时考虑许多样本带来的信号。这里仍只是手动修改参数后的前向复算。
4.参数究竟存在哪里
沿用第03章的行向量约定,把输入写成横排x=[x₁,x₂]。让W₁的第一列保存A的权重[1,-1],第二列保存B的权重[-1,1],就得到第一行[1,-1]、第二行[-1,1]的2×2矩阵。xW₁的每一项,是输入与对应权重列的点积;每一列负责产生一个输出。
再把两个偏置放成向量b₁=[0,0]。第一层包含4个权重、2个偏置,共6个参数。两个偏置碰巧同为0,仍然占据两个不同位置,以后可以被改成不同的数。
第二层的W₂是2×1矩阵:第一行只有2,第二行只有1;偏置b₂=1,共3个参数。整个网络有9个参数。ReLU本身没有需要训练的参数,所以不加进这笔账;其他激活或模块的情况应按实际定义检查。
隐藏表示[1,0]不属于这9个参数。它是用参数处理某次输入得到的中间结果,也常称为激活。网络下次收到[1,3]时,隐藏表示变成[0,2],这不代表模型偷偷重新训练了。
矩阵写法把这些步骤缩成一句:z=xW₁+b₁,h=ReLU(z),y=hW₂+b₂。形状依次为1×2乘2×2得到1×2,再由1×2乘2×1得到1×1;加偏置不改变结果形状。它与第03章的“输入行乘权重表”完全相同。
本例W₁恰好对称,行列交换以后数表外观相同,但这只是所选参数的巧合。不要因此把“一个输出对应哪一行或哪一列”随意混用。按这里的约定,它始终对应权重表的一列;第03章非对称的2×3例子可以帮助检查这一点。
如果一层有m项输入、n个输出,每个输出都连接全部输入,那么它需要m×n个权重;若每个输出另有偏置,再加n个参数。这种层常叫全连接层。我们的小例子就是2项输入、2个隐藏输出,再接1个最终输出。
5.为什么纯粹堆乘法和加法不够
假设第一层只算2x+1,第二层再把结果乘3、加4。展开就是:
3×(2x+1)+4=6x+7。
虽然执行了两步,整体仍等价于一次“乘一个固定数,再加一个固定数”。继续堆这种层,也不会凭空长出转折。向量和矩阵也是同样道理:固定线性变换的组合仍是线性变换;加上偏置后,严格说叫仿射变换,组合后仍是同类形式。
这不是说多层线性网络无法训练,或在研究中毫无价值。结论限定在表达能力:如果中间只有固定的乘加运算,没有其他非线性机制,最后能表示的函数类型不会因此变成任意曲线。
直接用刚才的网络验证。把第二项输入固定为0,只让第一项x变化。保留ReLU时,输出是:
y=2×ReLU(x)+ReLU(-x)+1。
依次代入-2、-1、0、1、2,得到3、2、1、3、5。把五个点画在纸上,会看到一条有拐点的折线:左边输入每增加1,输出减少1;右边输入每增加1,输出增加2。
任何一条直线都只能保持同一种变化速度,不能同时经过这五个点。ReLU让不同输入区域采用不同的局部关系,这正是这里的非线性。
若删去两个ReLU,整体则变成2x+(-x)+1=x+1,五次输出变为-1、0、1、2、3,重新落在一条直线上。即使重新挑选纯线性层的全部权重,也无法把一条直线变成刚才那条折线。
看图2时,原始9个参数全部保持不变,只把输入限制在[x,0]这条线上。蓝色折线与橙色虚线共用坐标;两者的差别只有是否保留ReLU。
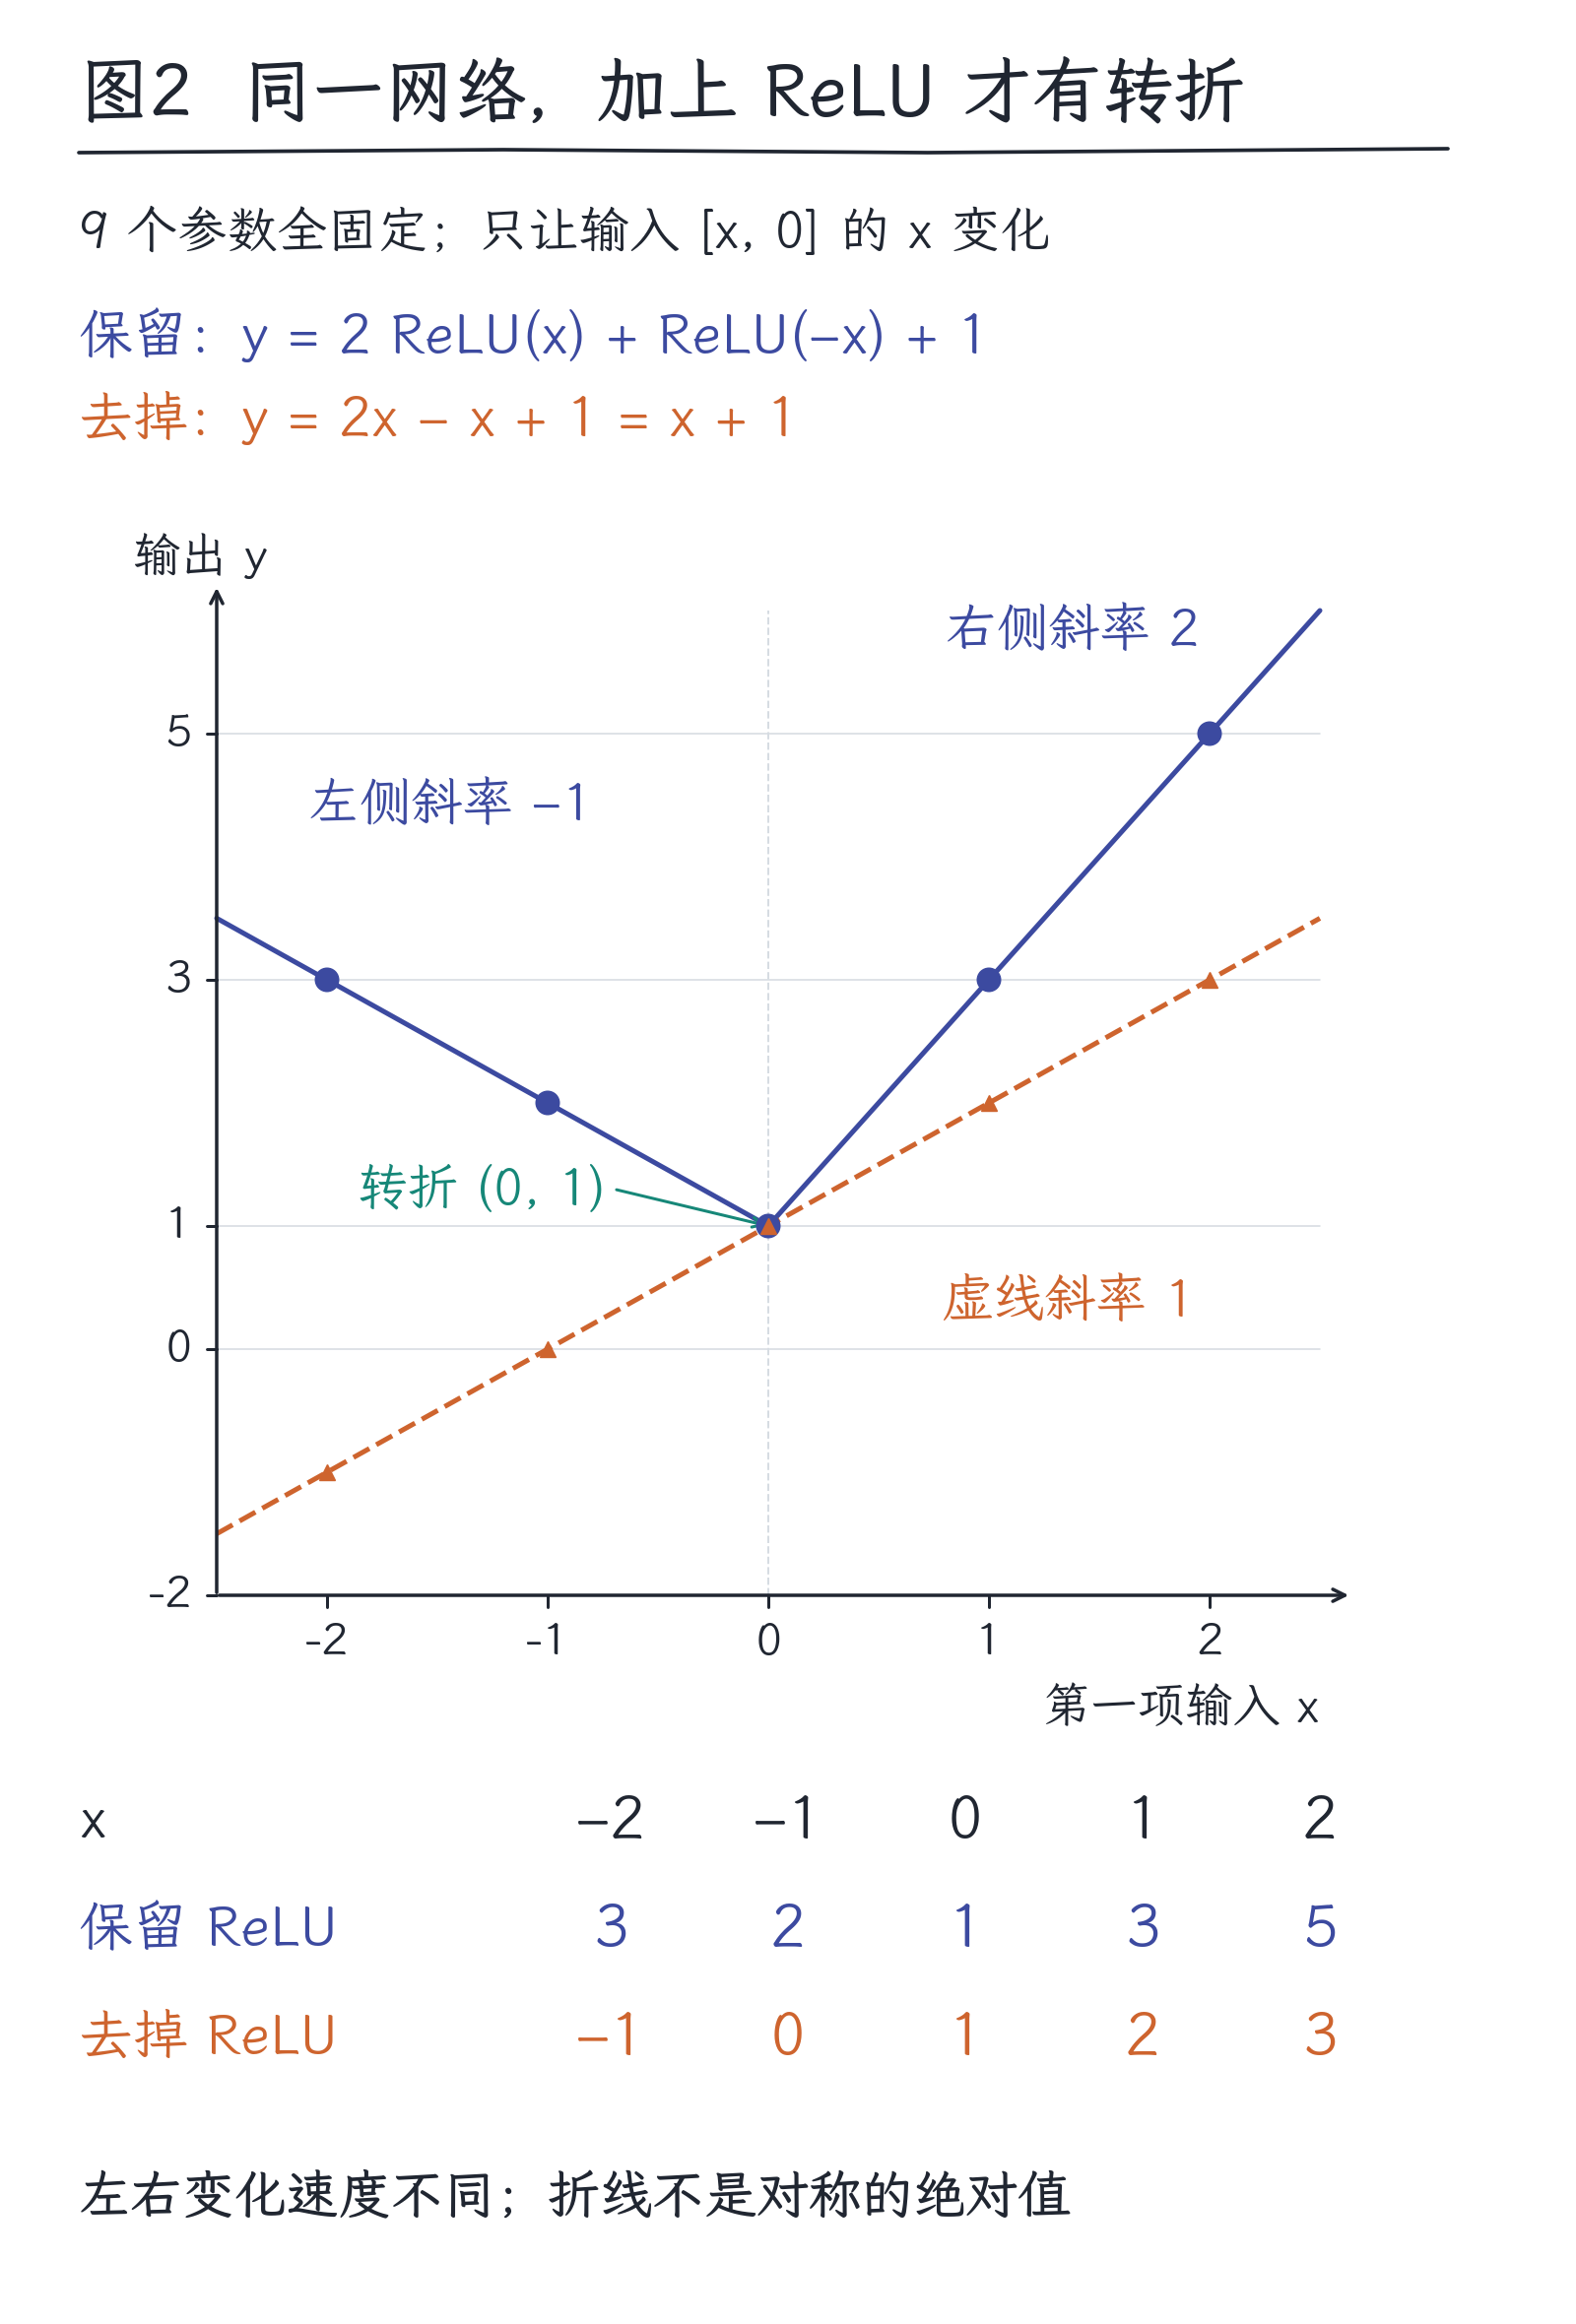
图2|保留ReLU时,网络出现两种变化速度;去掉ReLU后,整个计算合并成直线。图中固定第二项输入为0,右边的折线比左边更陡,并非对称的绝对值曲线。
6.隐藏表示里有信息,但不必有固定的名称
在这个手工设计的网络里,A的输出表示“第一项超过第二项的部分”,B的输出表示反方向的差。我们能给它们命名,是因为权重特意这样安排。
对于训练出来的大网络,不能预先规定第一层识别单词、第二层掌握语法、第三层负责推理。一个概念可能由多个方向共同表达,一个单元也可能参与多种模式。给某层贴上直观名称,需要实验支持。
“隐藏”也不是说里面的数不能读取。它通常指位于输入与最终输出之间的计算。训练数据往往告诉系统最终答案,却没有给每一个隐藏单元都发一份标准答案。
表示还会舍弃信息。[0,0]和[2,2]经过我们这层后都成为[0,0],后面只看到隐藏表示,就无法再分辨原来是哪组数。若任务只在意两项差异,这可能很合适;若任务要计算两项总和,这组参数就不合用。一个后续模块只接收h,就只能利用h保留下来的区别;中间接口丢掉的信息,不能靠最后多接几个相同输入的计算单元恢复。
因此,层数增加不意味着信息必然越来越完整。多层的意义,在于允许前面形成的模式被后面再次组合。训练是否找到了对任务有用的组合,仍要回到上一章的独立评测。
7.在Transformer和Qwen3里找到这些运算
Transformer原论文把一个前馈网络写得很直接:先做一次带参数的变换,经过ReLU,再做第二次带参数的变换。原文的这部分使用512维输入,扩展到2048维隐藏表示,再回到512维。Transformer原论文第3.3节
维数变大了,基本计算仍可沿着本篇的小网络理解。这个前馈模块分别处理各个位置的向量,同一层的不同位置共用一组参数,不同层则有各自的参数。位置之间怎样交换信息,还需要Attention;不能把这一个前馈模块当成整个Transformer。
更近的公开模型中,Qwen3技术报告明确列出其稠密模型使用SwiGLU。Qwen3技术报告第2节
SwiGLU沿着相似思路增加了门控组合:从同一个输入算出两组数,让其中一组经过平滑的非线性变换,再与另一组逐项相乘,最后继续投影。它仍由可训练矩阵和明确运算组成,只是没有照搬我们“负数直接归零”的教学规则。SwiGLU的原始定义
读到这里,不必背下所有激活函数名称。更有用的是能追问:哪一步使用参数,哪一步改变当前表示,非线性在哪里,参数是否跨位置共享。这几件事比圆点画得多漂亮更接近真实机制。
8.表达得出来,还不等于学得出来
增加隐藏单元,通常能增加可用的组合;增加层数,可以让组合被继续加工。不过,更宽、更深也意味着计算、参数存储或中间结果开销增加,训练可能更难,效果还取决于数据与优化方法。
也别把权重的绝对大小直接当成输入的“重要程度”。若把某项输入的计量单位放大100倍,同时把对应权重缩小到原来的百分之一,乘积可以原样保留。单独看某个权重有多大,既漏掉了输入尺度,也漏掉了后续的非线性和其他路径。
ReLU在负半轴把值归零,提供了容易理解的分段行为;其他激活函数会采用平滑曲线或门控,训练中的响应也会不同。没有一种激活仅凭名称就保证对所有任务最好。
更重要的是,本篇只是展示网络能表达什么。9个参数都由我们手填,输出3也只是算术结果,不能说明它预测得准。如果目标答案其实是5,它仍然答错了。
要让一套结构从数据中得到合适参数,必须明确误差,判断每个参数怎样影响误差,再选择更新方向和幅度。这也解释了为什么“模型结构”“训练方法”“训练后的模型”不能混成一件事。
本章练习
题目
问题1|完整走一遍网络
全部9个参数保持原值,输入换成[1,3]。依次计算A/B的加权结果、ReLU后的隐藏表示和最终输出。
问题2|同一网络,画两个新点
固定第二项输入为0,其余参数原值不动。分别取x=−3与x=3,计算保留ReLU和去掉ReLU时的输出。用结果解释为什么一条直线不能表示本章折线。
问题3|数清参数与中间值
A和B各连接两个输入,各有一个偏置;输出连接两个隐藏值,另有一个偏置。说明为什么总数是9,两个0偏置为什么仍算两个,h=[1,0]为什么不加入参数数目。
思考提示
提示1|对应问题1
先分别使用A、B的两条权重,再逐项应用ReLU,最后带入输出权重和偏置。
提示2|对应问题2
保留ReLU时分别判断x和−x哪一个为正;删去ReLU时把乘加展开。
提示3|对应问题3
数独立的可训练位置,而不是数不同数值的种类;再区分持久参数和本次计算结果。
参考答案与解析
答案1|对应问题1
A为1×1+3×(−1)+0=−2;B为1×(−1)+3×1+0=2。ReLU后h=[0,2];输出y=0×2+2×1+1=3。参数没变,改变的是输入与本次激活。
答案2|对应问题2
保留时y=2ReLU(x)+ReLU(−x)+1:x=−3得4,x=3得7。去掉时y=x+1,分别得−2与4。仅凭这两个新点还不足以排除所有直线;结合正文转折点(0,1),左侧斜率为−1、右侧为2,一条固定斜率的直线无法同时符合。
答案3|对应问题3
第一层4个权重+2个偏置=6,第二层2个权重+1个偏置=3,总计9。两个0占不同的可独立改变的位置,因此仍是两个参数。h由当前输入与参数计算出来,是激活,不是额外可训练参数;本例ReLU也没有可训练参数。
下一章
一次前向计算已经能完整复算,但网络预测3,目标却可能是5。应该改哪个权重、改多少,怎样知道改完更好?下一章继续使用同一套9参数网络,从损失、梯度和反向传播接起真正的学习过程。