同样的问题问两次,模型有时换一种说法,有时连答案都变了。把温度调低后,它又可能十分稳定地说错。另一方面,一段文字能流畅地从开头写到结尾,却不代表模型在输出第一个字时,已经选定并核验了整篇答案。
要理解这些现象,需要把“模型算出什么”与“程序选出什么”分开,再沿着每一步看过去。本章只需会比较大小、求和与相乘,就能走完一条完整的生成路径。
1.模型每次回答的是一个带条件的问题
第04章里,模型先给词表中的候选token打分,这些分数叫logits,再用softmax变成概率。本章把它放回实际时序:输入请求、对话角色标记以及已经生成的内容,共同组成当前前缀。模型根据这个前缀,计算下一token的条件分布。
“条件”意味着概率必须连同前缀一起读。接在“今天会议在”后面的候选,与接在“今天会议取消,因为”后面的候选不会相同。某个token没有一个到处通用的“出现概率”。
词表里的token也不一定是一个完整汉字或单词。为了聚焦机制,本篇用A、B、C等标签代表人工候选,不声称它们对应任何真实模型的分词。模型通常对整个词表提供分数;示意图只画少量候选,是教学简化。
接下来,解码程序根据规则选出一个token,把它接到前缀末尾,再用更新后的前缀计算下一步。这样让自己的历史输出成为后续输入,就叫自回归生成。基础循环不断重复,直到停止条件满足。Transformers:生成策略与贪心循环
本轮分布也不等于下一轮分布的缓存答案。比如当前选了日期token,下一步可能更偏向时间或标点;当前选了否定词,后面又会进入另一组表达。采样改变一个位置,后续许多位置都可能随之前缀一起改变,所以两份回答的差异不一定局限在最早抽中的那个词。
因此,生成并非从答案库抽取一段完整文本,也不是每一步互不相关地掷骰子。计算可以利用缓存等技术加速,但下一步仍以已经接受的前缀为条件。
2.一句话的概率,要沿着具体路径连乘
假设输入记为P。第一步A的概率是0.6,B的概率是0.4。选中A后,下一步C的概率是0.55,D是0.45;选中B后,下一步C变成0.1,D变成0.9。所有数字都是人工构造的。
再假设,在这四种两token前缀后,结束标记EOS的概率均为0.9,其余0.1对应继续生成。于是生成“A、C、EOS”这条完整路径的概率是:
0.6×0.55×0.9=0.297。
每个因子都回答不同问题:先在P之后选A,再在P和A之后选C,最后在P、A、C之后结束。“B、D、EOS”的概率则是0.4×0.9×0.9=0.324。
这是条件概率的连乘,不是假设各步独立。如果把第二步一律写成同一组概率,就抹掉了前缀对结果的影响。若要算“以A、C开头”而不要求此刻结束,则只乘前两个因子,结果为0.33;算确切结束的整段序列时,才再纳入EOS。
这些数字是模型对序列的概率,不是命题为真的概率。某条错得很常见的表述也可能得到高分。连乘还使长序列常常得到较小的原始概率,不能直接据此比较长短不同的回答哪篇更好。
3.贪心每次选第一名,却没有看遍所有结局
贪心解码的规则很简单:每一步直接选择当前概率最高的token。刚才第一步会选A,第二步选C,再选EOS,得到概率0.297的路径。
但B、D、EOS的概率是0.324,比它更高。第一步局部看起来更好的选择,没有保证整条路径最好。这与走迷宫相似:眼前更宽的入口,不一定连接更短的出口;模型也没有因为选了当前第一名,就完成对全部后续序列的搜索。
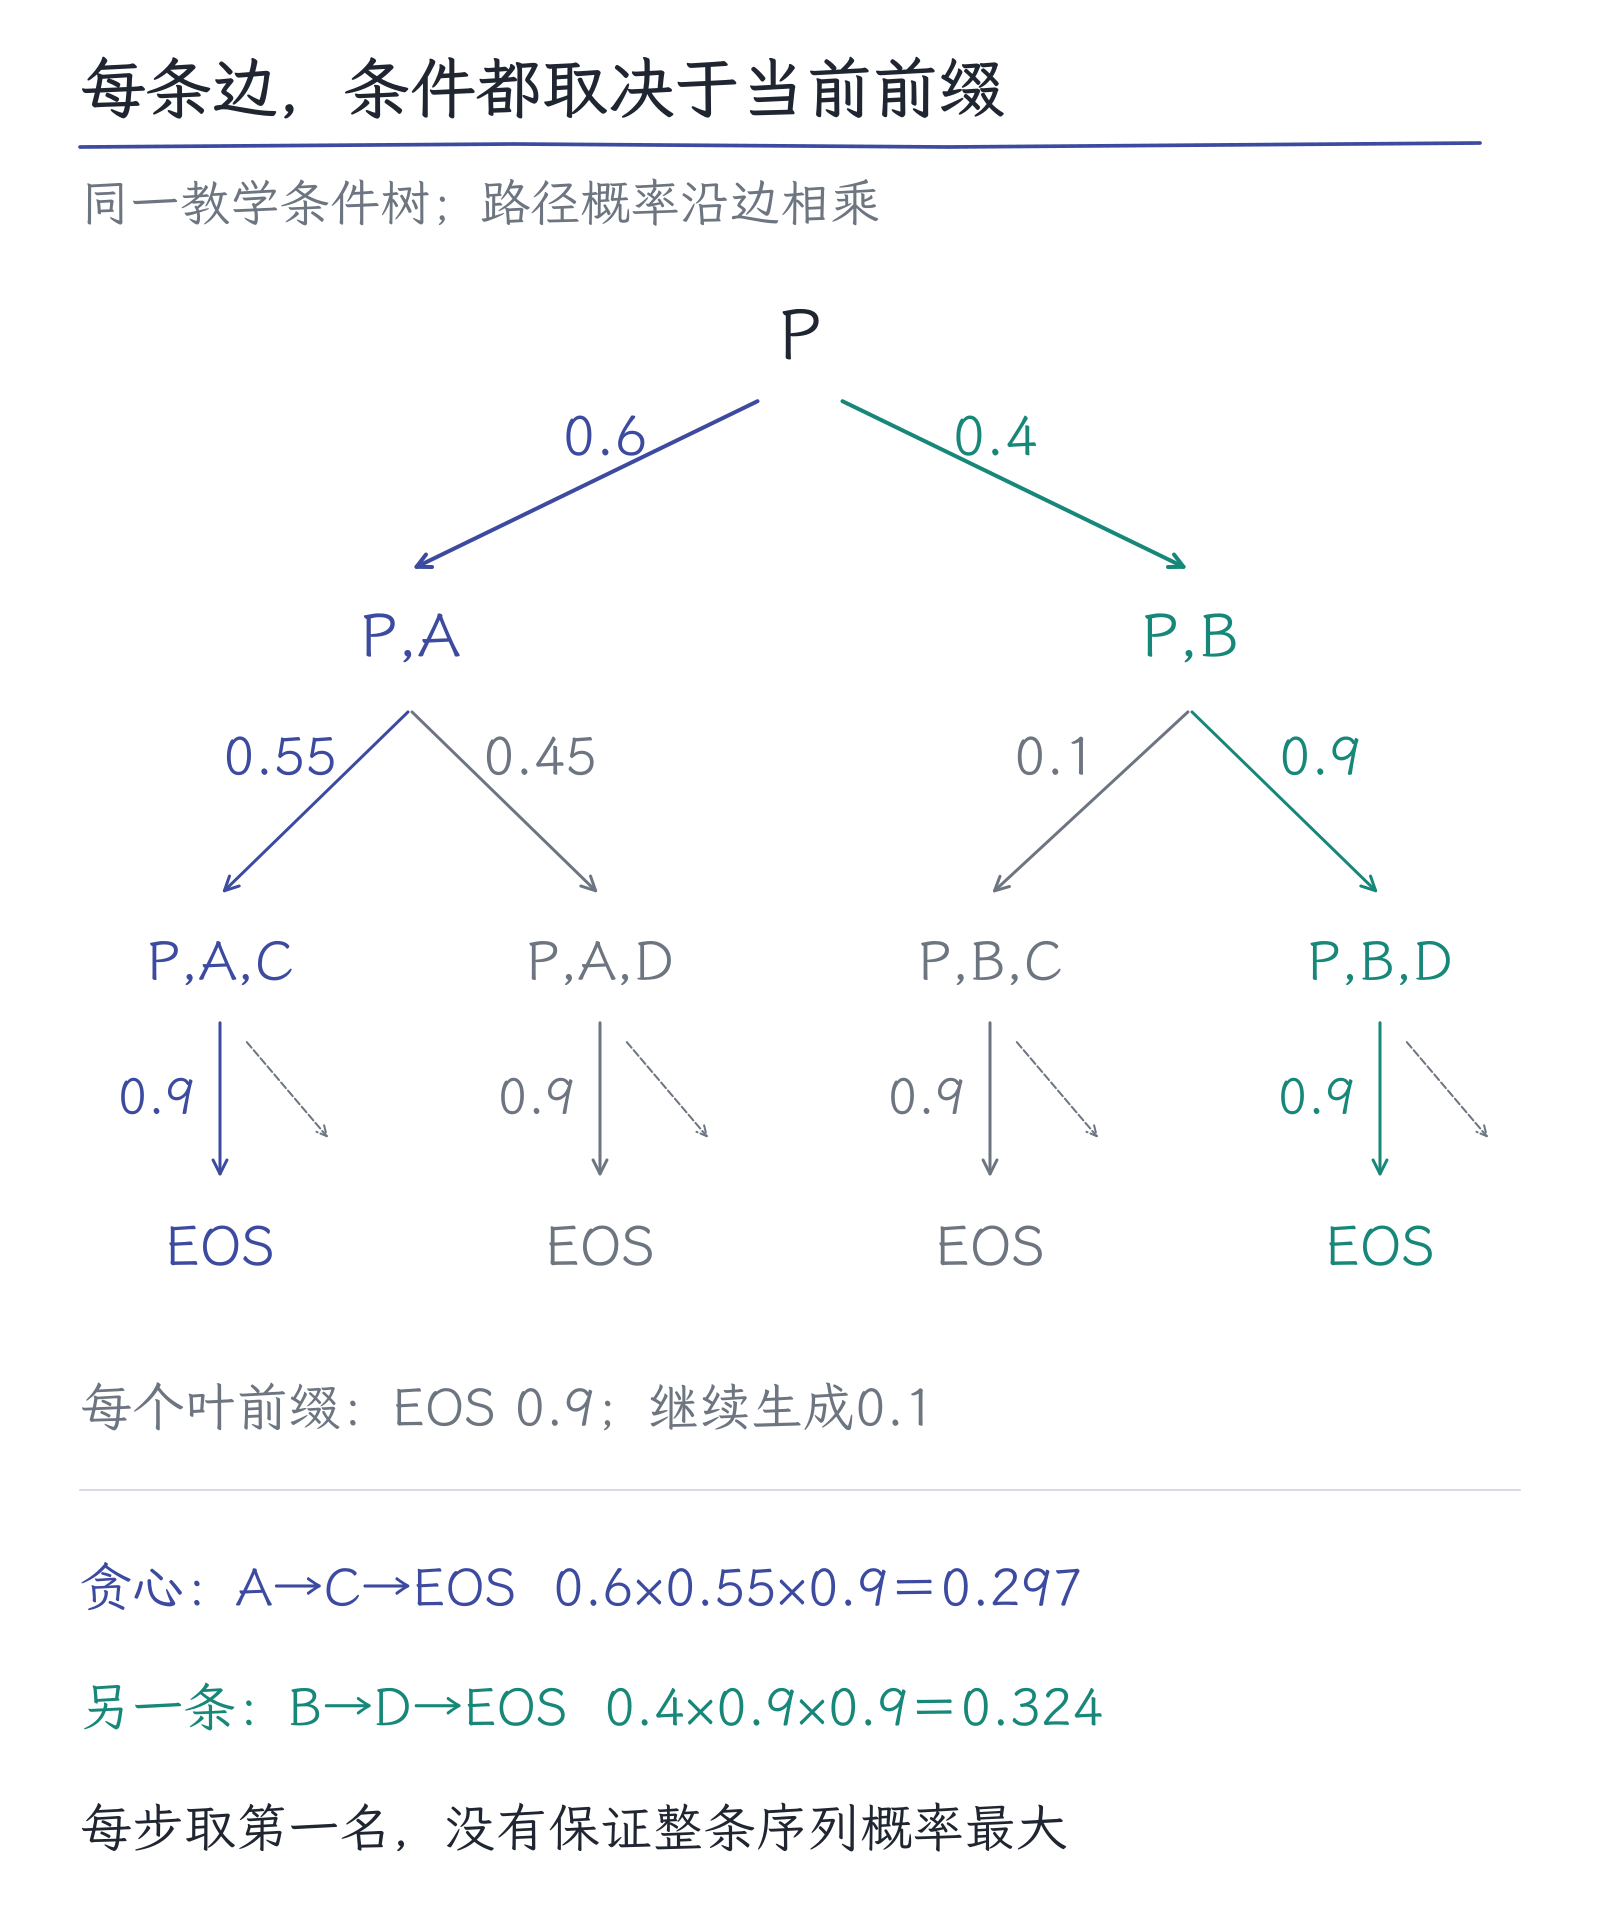
图1|同一棵条件树中,贪心选择A、C、EOS,路径概率0.297;先选B再选D并结束的路径概率0.324。每条边的条件由到达它的前缀决定,EOS也有自己的概率。虚线表示剩余0.1继续生成。
实际还有束搜索等保留多条候选路径的方法,但寻找更高序列概率,本身仍不等于核验事实。本章先抓住贪心与采样的区别:前者取最大项,后者按概率抽取。Transformers:贪心、采样与束搜索
在分数、并列处理和运行条件完全相同时,贪心选择可重复。部署中的数值实现与条件变化仍可能影响结果,所以不能仅凭“没开随机采样”就保证跨设备、跨版本逐字相同。PyTorch:复现的边界
4.用一张概率尺,模拟真正的抽样
固定另一组下一token分布:A为0.40、B为0.25、C为0.20、D为0.10、E为0.05,总和为1。接下来的各项实验都从这一组分布重新开始,不是依次改变同一轮结果。
把0到1分成五段:A占0到0.40,B占0.40到0.65,C占0.65到0.85,D占0.85到0.95,E占0.95到1。约定每段含起点、不含终点。从0到1均匀抽一个随机数,落在哪段就选谁。
如果抽到0.60,就选B;抽到0.83,就选C。B不是最大项,却有四分之一机会被选中。概率只约束抽样机会,不要求每连续四次一定出现一次B。
现在在纸上写下0.03、0.18、0.42、0.61、0.70、0.84、0.90、0.97,依次查区间,会得到A、A、B、B、C、C、D、E。这是预先给定的一串教学数,不是随机实验统计。它只用于检查抽样规则,不能拿这八次频数反过来宣称模型概率是另一组数。
更重要的是,这里刻意固定了前缀。真正生成连续八个token时,每选一个就要接回前缀,重新计算分布,不能拿这把不变的概率尺一路抽到底。
5.温度改变分布的集中程度
temperature常记为T,是一个正数。常见做法是在softmax之前,把每个logit除以T。T小于1时,分布通常更集中;T大于1时,更平缓。它控制的是选择倾向,不是事实审查的强度。Transformers:TemperatureLogitsWarper
为什么“logits除以T”会变成“概率做幂”?原softmax可写为pᵢ=exp(zᵢ)/S,其中S是所有exp(z)的和。因此exp(zᵢ/T)=(S×pᵢ)^(1/T);再除以所有候选的总和时,共同因子S^(1/T)会消掉,留下:
新pᵢ=pᵢ^(1/T)÷Σpⱼ^(1/T)。
这条关系固定了原logits,只改变温度;暂未加入top-k或top-p。T=0.5时1/T=2,于是得到平方后归一化。现在用上一节的概率手算。当T=0.5时,新概率与原概率的平方成比例:先算0.16、0.0625、0.04、0.01、0.0025,它们的和是0.275;各项除以0.275,得到约0.582、0.227、0.145、0.036、0.009。
A的机会从40%升到约58.2%,其余候选仍有机会。这不是贪心。如果仍用随机数0.60,A对应的区间在约0.5818处结束,因此这一次仍选B。降温并不意味着每次输出都会改变,更不意味着每次都选第一名。
温度为正时,单独改变温度不会颠倒logit的排序。原先最受偏好的错误答案可能更稳定地出现。
还可以只比较两项的相对机会:原来A与C是0.4比0.2,即2比1;温度降到0.5后,变成0.16比0.04,即4比1。归一化不会改变这个比值,只把总和拉回1。这说明降温放大了已有偏好,并没有加入一条“检查日期是否正确”的新证据。
接近零的温度在理想极限下会集中到最大项,但具体接口未必允许把T直接设为0;应按框架提供的贪心开关表达该意图。
6.top-k和top-p怎样缩小候选集合
top-k保留概率最高的k个候选,其他候选不参与这次抽样,再把保留项归一化。对原分布取k=2,只保留A和B。它们的原概率和为0.65,新概率分别为0.40÷0.65=8/13,以及0.25÷0.65=5/13,约为0.615和0.385。
top-p则按概率由高到低累加,保留累计达到阈值的最小候选集合。设阈值为0.70,A加B只有0.65,还不够;加入C后为0.85,所以保留前三项。重新归一化后,概率为8/17、5/17、4/17,约为0.471、0.294、0.235。Transformers:top_k与top_p定义
top-p=0.70不是保留70%的词表,也不要求保留项的原概率恰好等于0.70。若第一名就有0.8,同一阈值可只留下一个候选;分布平坦时则可能留下更多。这是固定候选数量与按累计概率决定数量的区别。
用同一个0.60作随机数,top-k=2会选A,top-p=0.70会选B。哪一个更真实,单靠区间和抽样结果并不知道。过滤候选也可能把正确续写移出去。假如某个少见但准确的人名对应候选E,过滤后它在本步的抽样机会就是零;提高多样性可能把它放回来,同时也会放回其他不合适的候选。要知道哪个名字正确,需要任务证据和评测,不能只凭候选是否罕见决定。
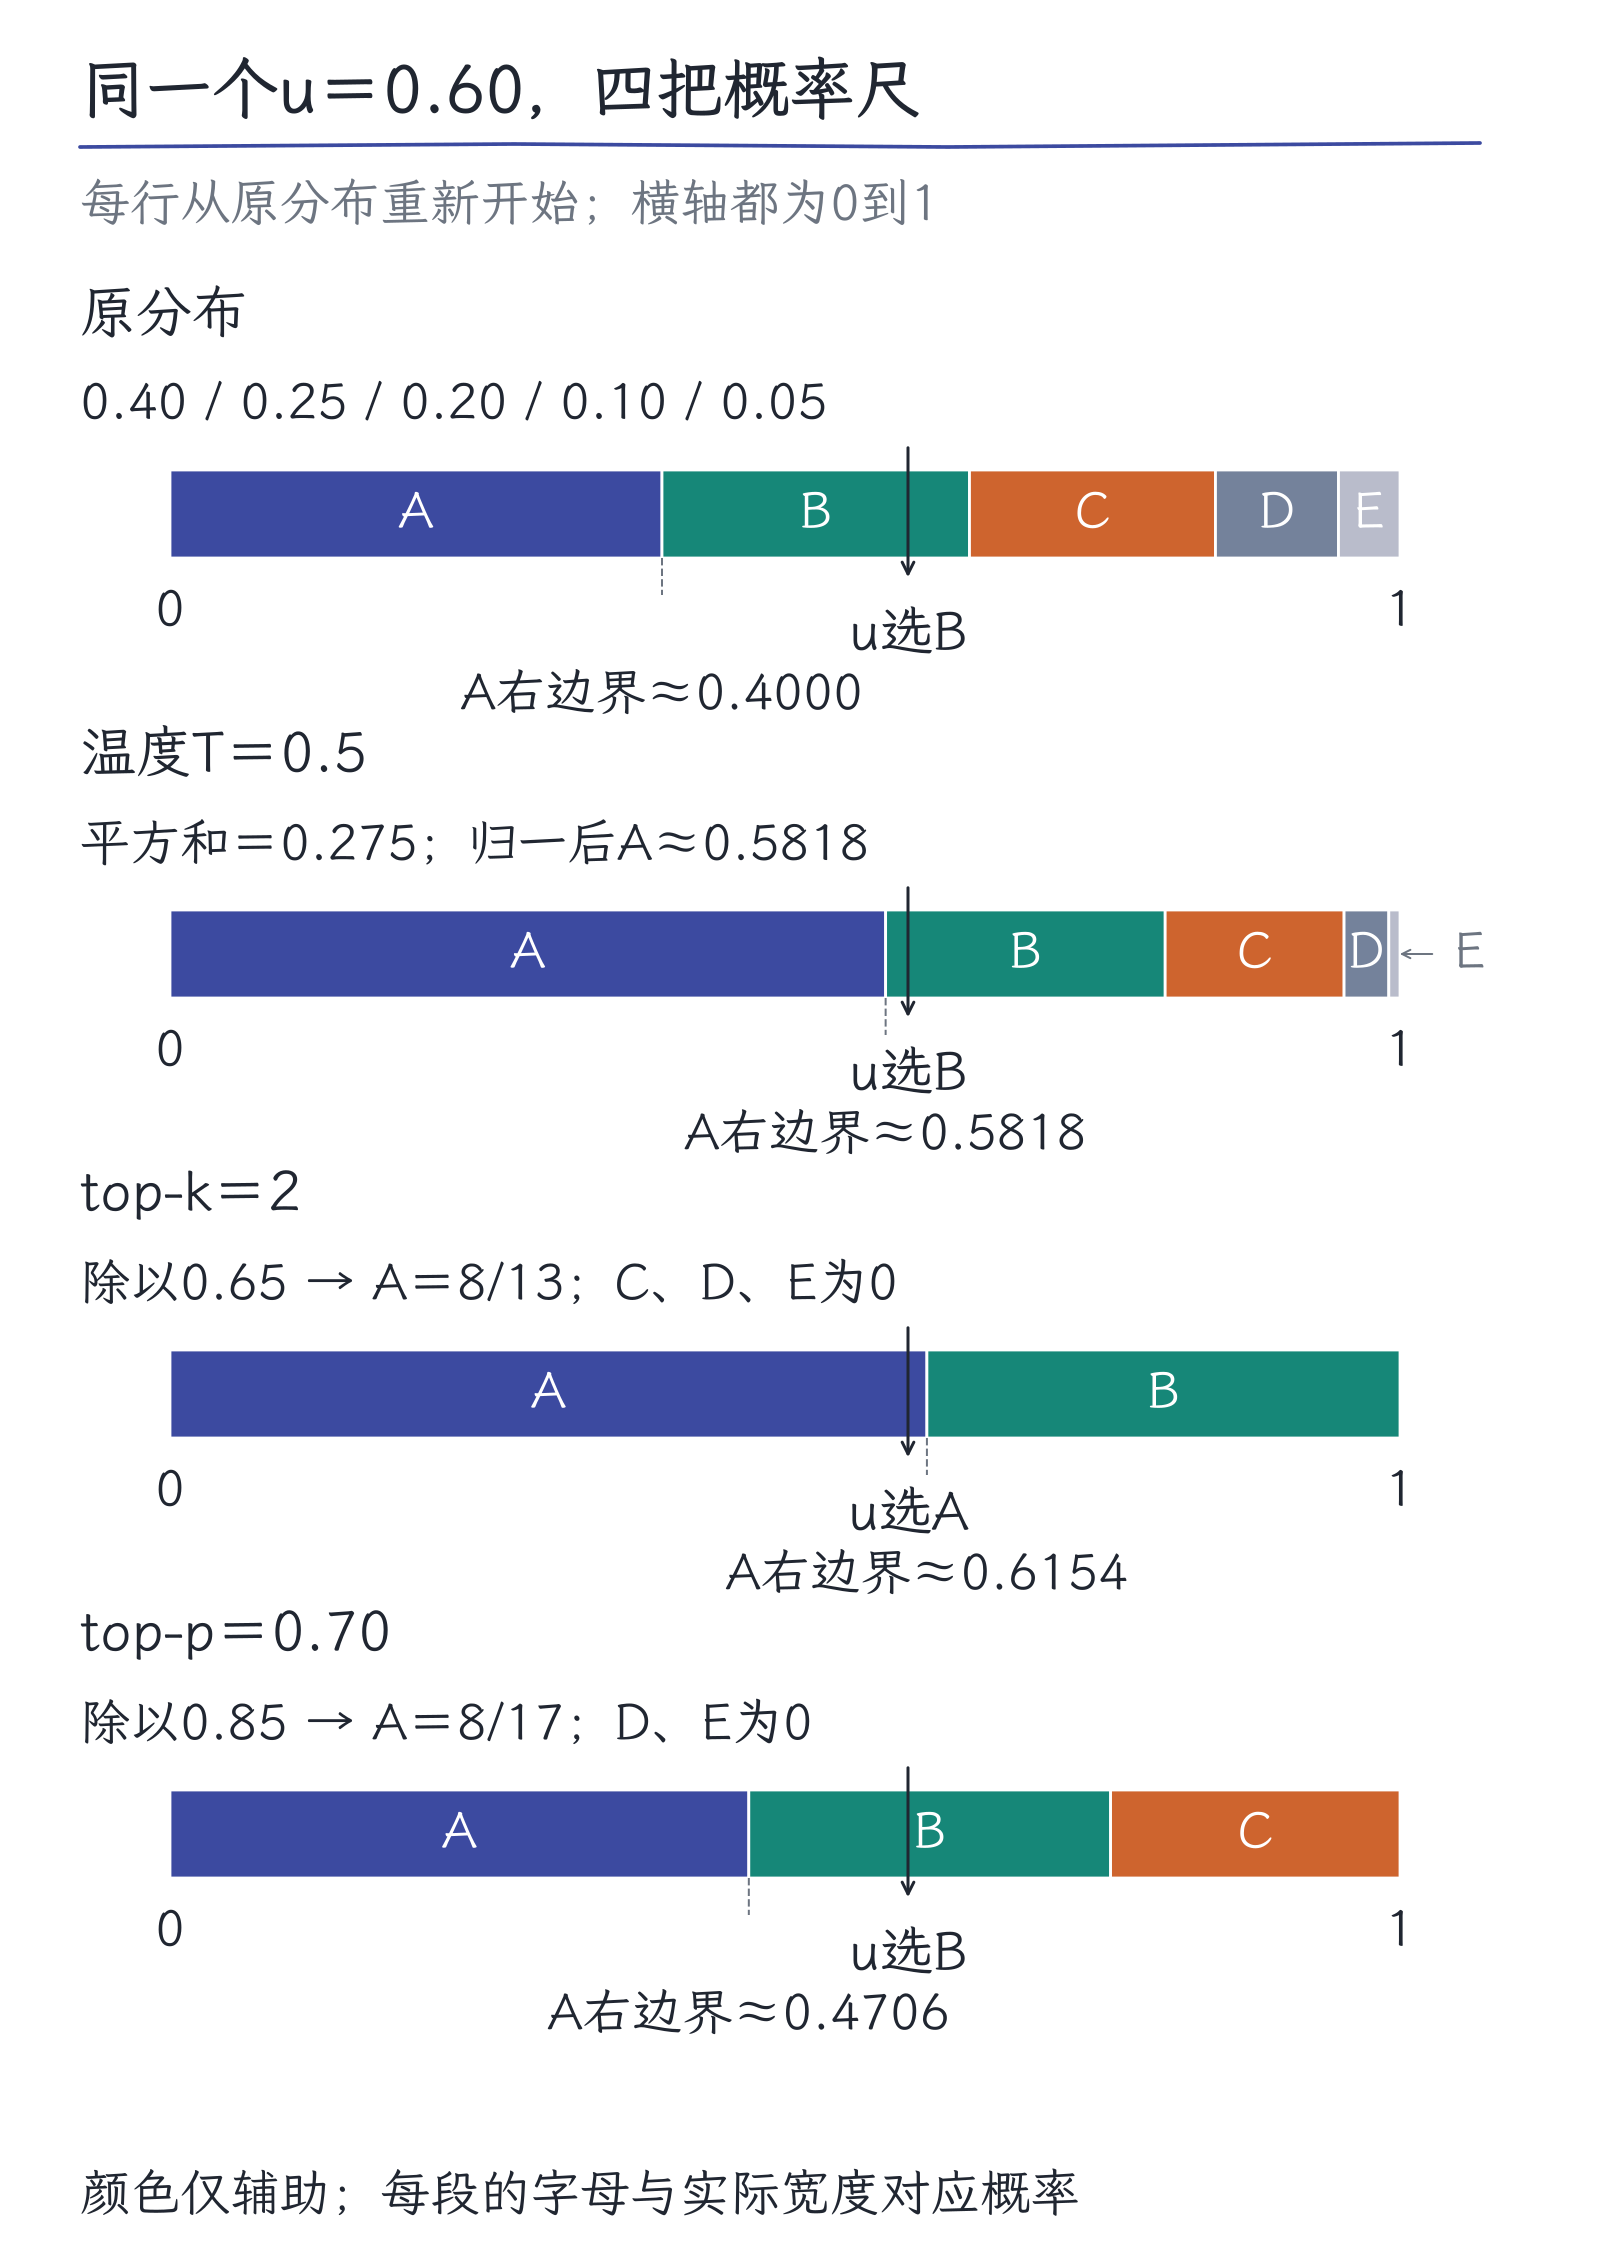
图2|四把概率尺共用0到1横轴,同一个u=0.60依次落到B、B、A、B。每行从原分布重新开始:低温除以0.275,top-k除以0.65,top-p除以0.85。被过滤的候选标明为0,不再占尺上区间。
实际配置可以组合温度、top-k和top-p,效果还受应用顺序与实现约束影响。组合后的抽样分布已经不同于原模型分布:若计算“这套程序实际输出某序列的概率”,要连乘修改后的条件概率,不能继续照抄未经处理的原概率。
7.标准前缀与自己写出的前缀,为什么不同
常见下一token训练会给每个位置提供数据中的标准前缀,再计算目标token的损失。这叫teacher forcing。因果掩码不让当前位置偷看后面的答案,但训练程序已经知道整条标准序列,可以一起组织多个位置的监督。Transformer原论文:因果掩码与并行计算
不要把这种训练理解为:先抽出一个词,再等它正确了才教下一个。在标准前缀训练中,某位置预测错误,不会立刻把后面位置的标准输入改成它的错误预测。这让计算更容易并行,也解释了为何训练中每一步都有提示扶着,完整使用时却必须面对自己刚作出的选择。
使用时没有下一步标准答案,前缀包含模型刚才实际选出的token。假设训练文本是“会议在周五下午”,模型使用时却先写成“会议在周四”,后续计算将面对这个自生成前缀。它可能继续把周四补得很通顺,也可能借助上下文纠正,不会自动被替换回训练中的周五。
这种训练与使用条件的差异,可能让错误沿序列传播。早期序列学习研究已经明确讨论过这个问题,但不能因此断言所有长回答必然越来越错。Scheduled Sampling原论文:训练与推理前缀差异
这也是为什么逐token训练损失较低,还需要完整生成评测。评测应观察模型真的走过哪些前缀、有没有恢复能力,以及最终任务是否完成。
这类似把单步预测检查与自由运行检查分开:前者每一步拿到固定的正确输入,后者要接受自己的输出造成的新状态。复现实验时应保存模型与分词器版本、完整输入、生效的解码参数和运行环境;使用采样时还要记录随机种子,但种子相同也不是跨环境逐字一致的保证。
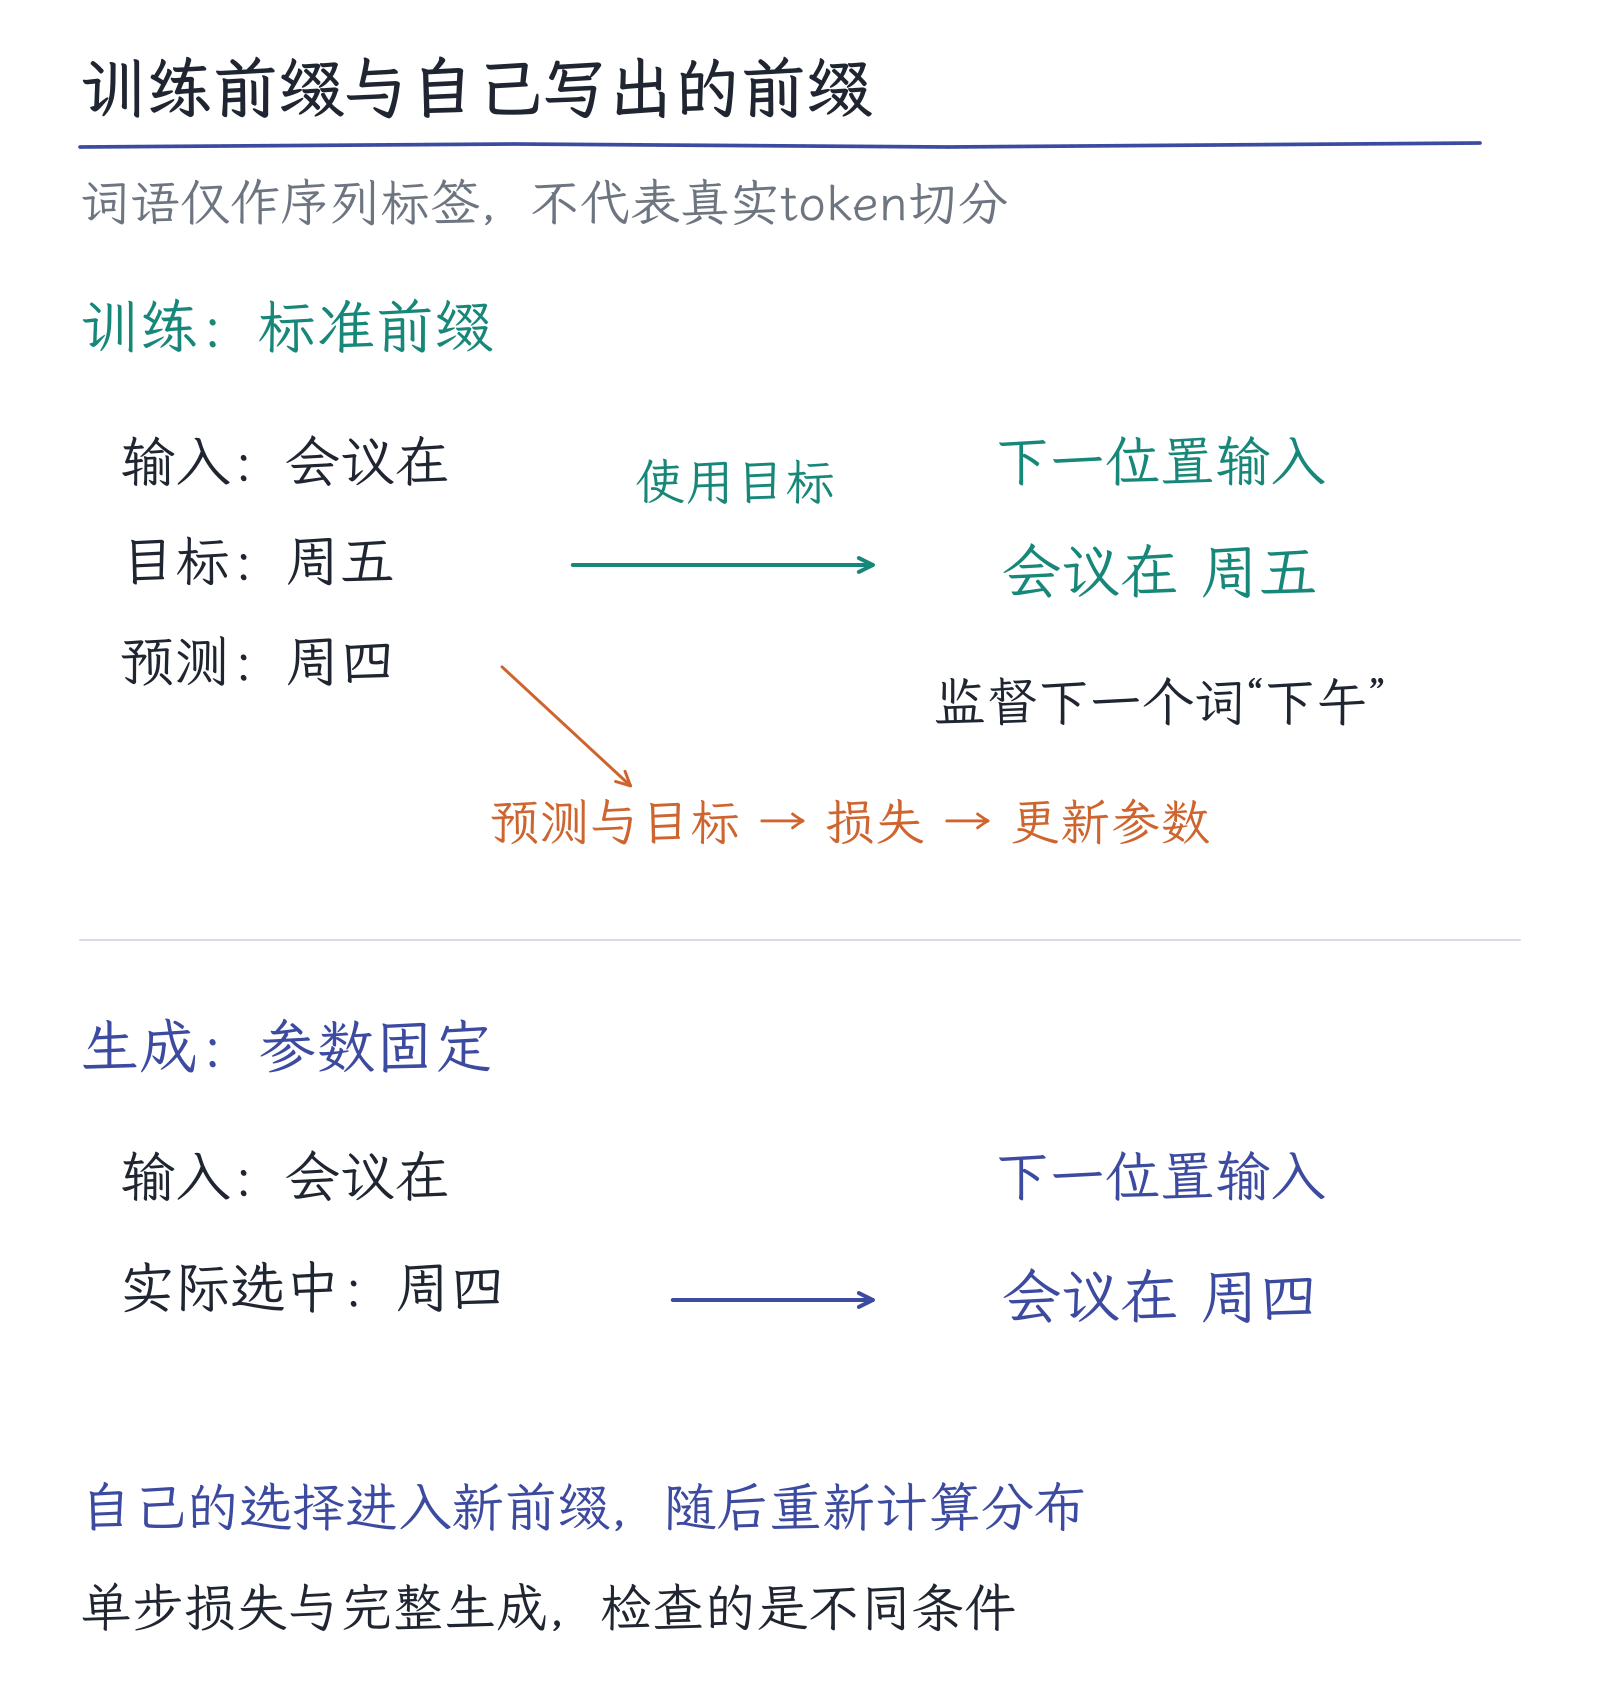
图3|训练时,即使当前位置预测“周四”,下一位置仍使用示范中的“周五”作为输入;生成时实际选中的“周四”会进入下一轮前缀。上行可以形成损失并更新参数,下行是固定参数下的一次回答。
8.什么时候停止,谁来决定
一种停止方式是选中指定EOS,即序列结束token。模型把“结束”也当成候选,程序识别后停下。EOS不一定显示为普通文字,某些配置也允许多个结束token编号。
另一种是程序达到长度上限。max_new_tokens控制新增token数,不包含原输入;max_length通常控制输入加输出的总长度。例如输入已有100个token,新增上限20意味着最多再写20个,不是让总长度缩到20;若按总长度控制,对应的上限才是120。这里数的是token,并非20个汉字或20句话。还可以配置停止字符串,由程序检测生成文本是否匹配。Transformers:长度与停止条件
达到长度上限时,回答可能停在半句话;生成EOS时,也可能过早收尾。两者都不证明任务完成。批量处理时用于对齐长度的PAD还有不同职责,不能只因某份配置复用同一编号,就把所有补齐位置当成实际生成的回答。
给更高上限只是允许继续写,并不要求写满,也不保证多写就更正确。若答案需要引用和验证,长度额度本身不会提供证据。排查“为什么没写完”时,先分清是否触发上限、结束token或应用停止规则,再看模型是否遗漏任务要求。单纯反复提高长度,可能只让重复内容持续更久。
回看第2节,同样显示出“A、C”后停下,还可能是不同事件:模型选择EOS,或者程序在两个新增token后触发上限。前者的概率为0.33×0.9=0.297;后者在本例不再抽第三个token,输出这个前缀的概率为0.33。事件定义改变了,乘数也改变了。
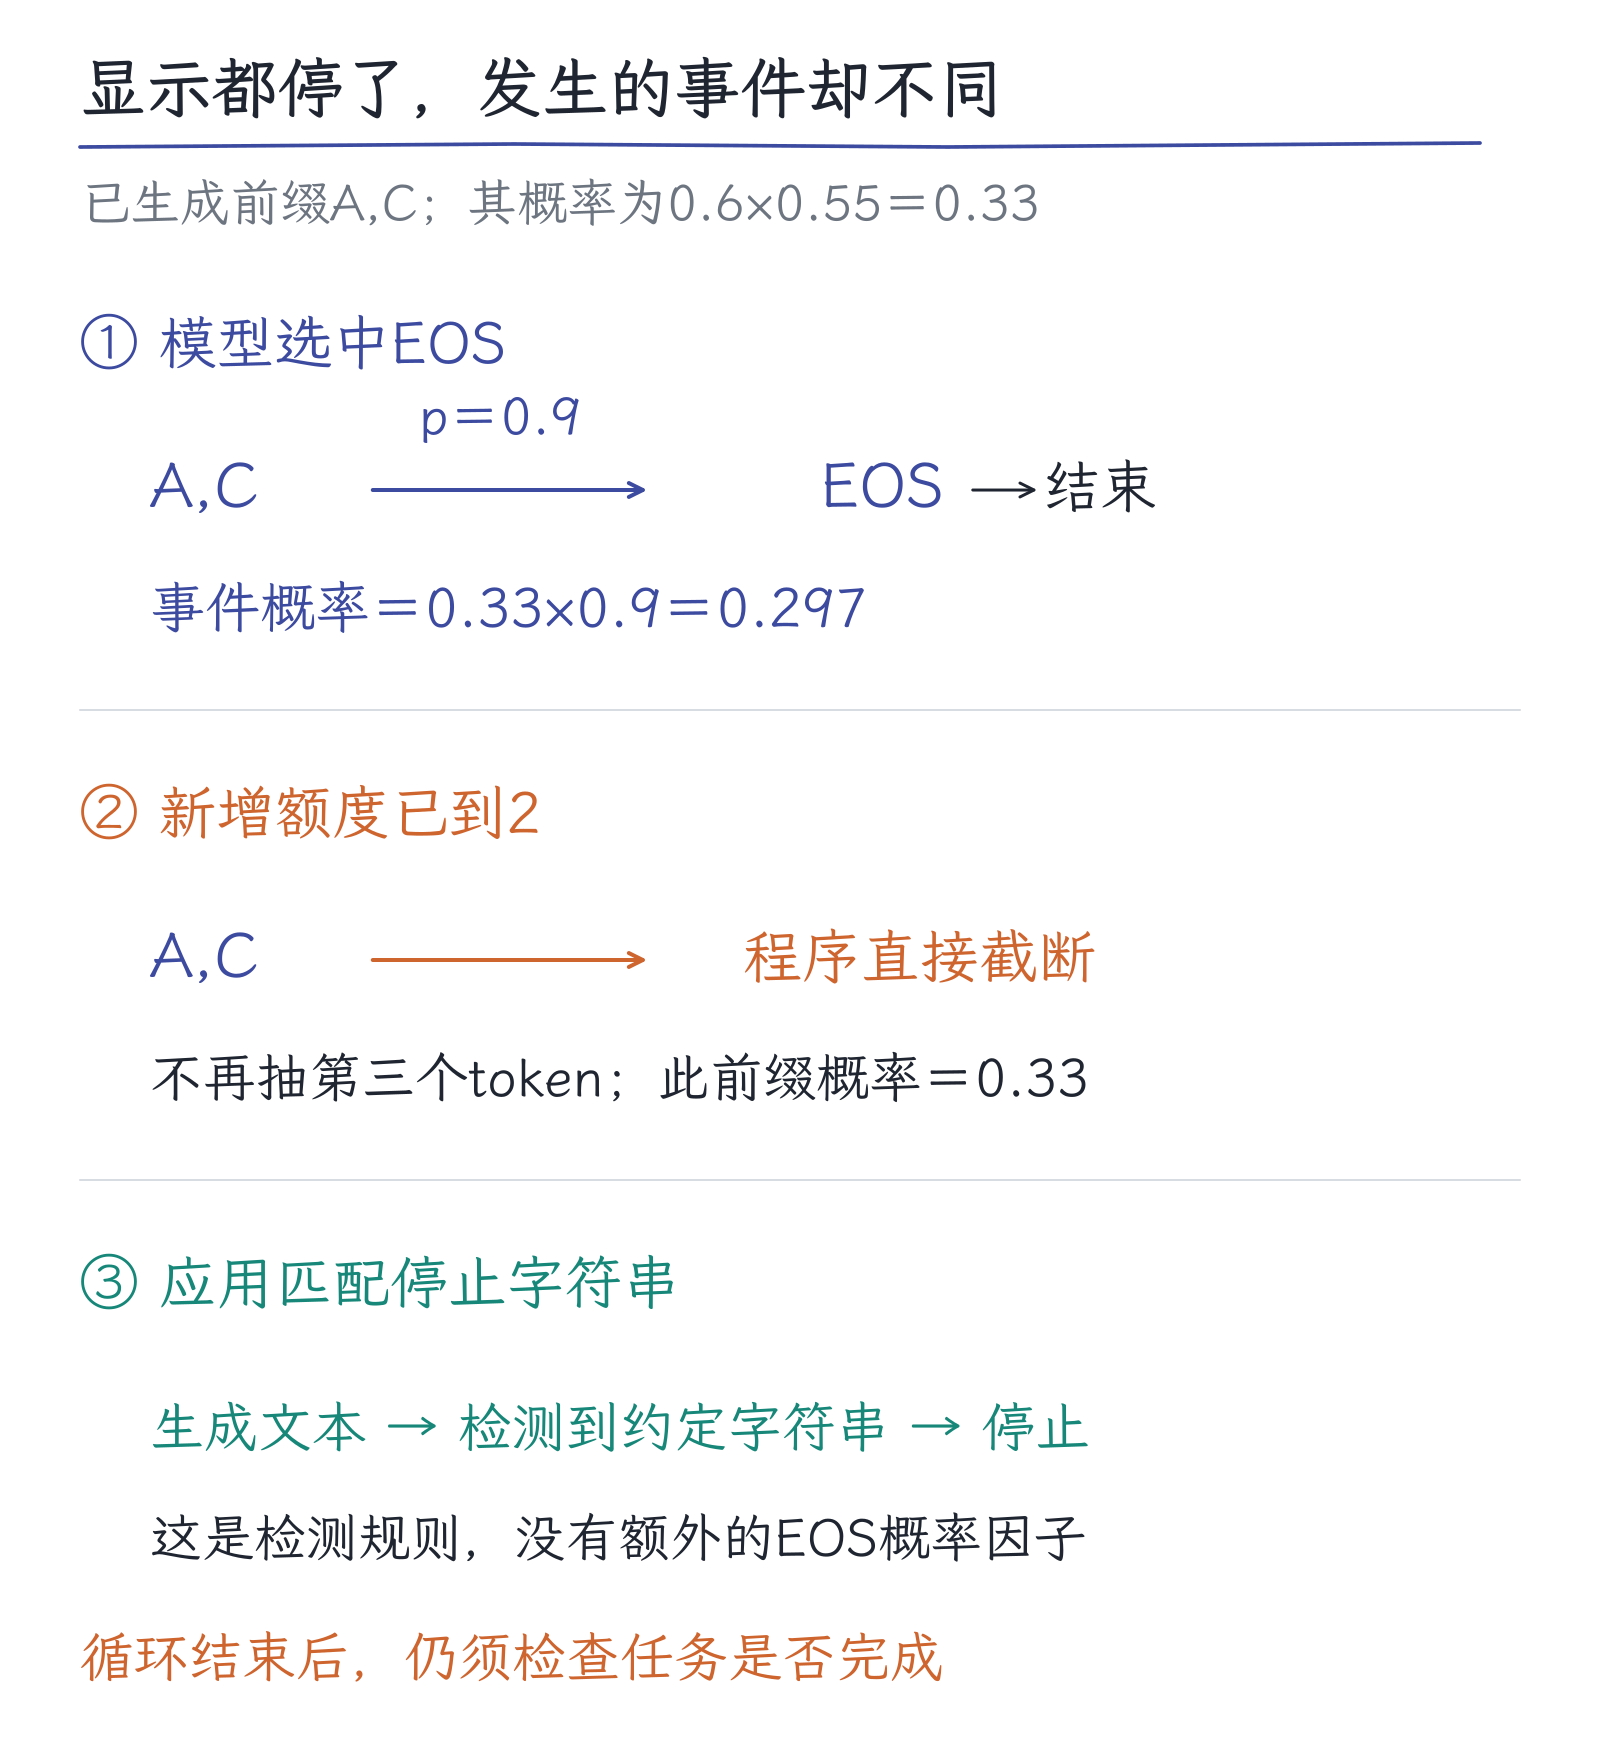
图4|同一前缀A、C之后,EOS选择、长度额度耗尽和停止字符串匹配属于不同停止来源。前两条展示在本例中的事件概率;停止字符串是应用检测规则,图中不赋予一个独立“模型概率”。停止只说明循环结束,任务完成要另行检查。
9.在Qwen公开配置里找到这些开关
Qwen3-8B的公开提交47719a2中,generation_config.json设置do_sample为true、temperature为0.6、top_k为20、top_p为0.95,结束token编号为151645和151643;文件记录的Transformers版本是4.51.0。Qwen3-8B固定提交:生成配置
这是一份具体模型配置,不是所有框架的共同默认值。为解释参数含义,本章对应Transformers v4.57.1文档;它与文件记录版本也应分开,不能说二者完全相同。
Qwen3-8B模型卡对思考模式推荐0.6温度、0.95的top-p与20的top-k,并提醒贪心可能造成质量下降和重复;非思考模式则建议另一组设置。这是针对该模型和模式的公开建议,不是“采样永远胜过贪心”的定理。Qwen3-8B:生成设置建议
配置文件还可能被运行时参数覆盖。判断一次回答究竟怎样产生,需要实际生效的设置、模型版本和输入,不能仅凭下载目录里某份默认文件推断全过程。
本章练习
题目
问题1|保留集合与归一化
从[0.40,0.25,0.20,0.10,0.05]开始,top-p=0.70保留哪些候选?各项新概率是多少?同样的u=0.60会选谁?
问题2|为什么平方仍要归一化
原分布不变,只设T=0.5。为什么用概率平方?A的新概率与其区间右边界是多少,u=0.60会选A吗?这能证明答案真实吗?
问题3|显示相同,事件不同
A、C前缀概率0.33,随后EOS概率0.9。生成A、C、EOS的概率是多少?若新增上限设为2、到A、C便截断,输出这个前缀的概率是多少?两种停止能证明任务完成吗?
思考提示
提示1|对应问题1
先累计到跨过阈值,再除以保留项的原概率总和,最后标区间边界。
提示2|对应问题2
把1/T代入概率幂公式,再求全部平方的总和。
提示3|对应问题3
第一种事件要求再选择EOS;第二种事件在两个token后由程序停止。
参考答案与解析
答案1|对应问题1
保留A、B、C,原概率和0.85;新概率为8/17、5/17、4/17,约[0.4706,0.2941,0.2353],和为1。B的区间为[8/17,13/17),u=0.60落入其中,所以选B。
答案2|对应问题2
T=0.5使1/T=2,所以各项平方后归一化。平方和0.275,A为0.16/0.275=32/55≈0.5818,区间[0,32/55)。u=0.60越过A边界且未越过B边界,仍选B。温度只重新分配概率,没有核验事实。
答案3|对应问题3
完整EOS路径为0.33×0.9=0.297;长度上限事件不要求第三次选择,所以本例输出A、C前缀的概率为0.33。两者不是同一事件,也都不能证明任务完成:可能过早EOS或在上限处截断,还须检查内容是否满足请求。
下一章
一段回答是连续的条件选择:算分布、选token、接回前缀、检查停止。序列越长,后面的计算面对的历史也越长。下一章讨论prefill、decode与KV缓存,看看哪些内容可以复用,哪些资源仍会随着上下文增长。