上一章,我们已经算过一次注意力:一个位置怎样用Q寻找相关的K,再把相应的V加权带回来。但这只完成了一次读取。读回来的信息怎么加工?原来的表示会不会被覆盖?这样的操作怎样连续做几十次?
Transformer给出的不是一个孤立公式,而是一套能反复连接的计算结构。今天沿着三个位置、每个位置四个数的小模型走一遍。你不必记住所有缩写,只要随时能回答:现在有几行、每行几个数、哪些位置能够互相影响。
1.先认清主干上流动的东西
把“小猫/追/小狗”暂定为三个教学token。查词向量后,每个位置有四个数,合起来就是3×4的矩阵X:3行是位置,4列是表示维度。真实分词未必这样切,真实模型的维度也远大于4。
这张表不是三个词的释义清单。四列没有预先指定为动物、动作、情绪、逻辑。经过不同层后,同一个位置的四个数会改变,因为它已经结合了上下文。
这里先采用纯解码器里的因果注意力:第一个位置只能读取自己,第二个位置能读前两个,第三个位置能读全部三个。“读取”指使用那些位置的表示,不是从外部数据库查资料。
一个关键习惯是把位置数与表示宽度分开。3×4变成3×8,仍然是三个位置,只是每个位置临时有八个数;绝不是句子长出了五个新token。
2.把一个完整模块连起来
本篇选用预归一化,也叫pre-norm的排列。Norm表示稍后解释的归一化;Attention表示注意力分支;FFN表示前馈分支。
第一步,把X逐行归一化,送入注意力,得到3×4的结果,再与原来的X逐项相加,得到H。
第二步,把H逐行归一化,送入FFN,也得到3×4的结果,再与原来的H逐项相加,得到Y。
缩写为两行:
H=X+Attention(Norm(X))。
Y=H+FFN(Norm(H))。
这些加号叫残差连接。请留意,旁路传过来的是归一化之前的X或H。主干宽度一直保持4,所以每次相加都能找到对应项。
两个Norm也通常有各自的可学习参数。图里都写Norm,是在标出操作类别,不是要求两处共享同一组缩放系数。注意力分支和FFN分支的参数同样各有用途。
这只是一种明确的排列。2017年原始Transformer采用先做子层与残差相加、再归一化的post-norm。二者不能看见模块名称相同,就随意交换顺序。实际模型还可能有额外归一化或其他变体。Transformer原论文第3.1节
先把两条旁路画出来,再沿分支检查形状。图1下半部分会把同一个加法展开到反向传播:这不是额外的算法,而是第07章的“多条路径贡献相加”。
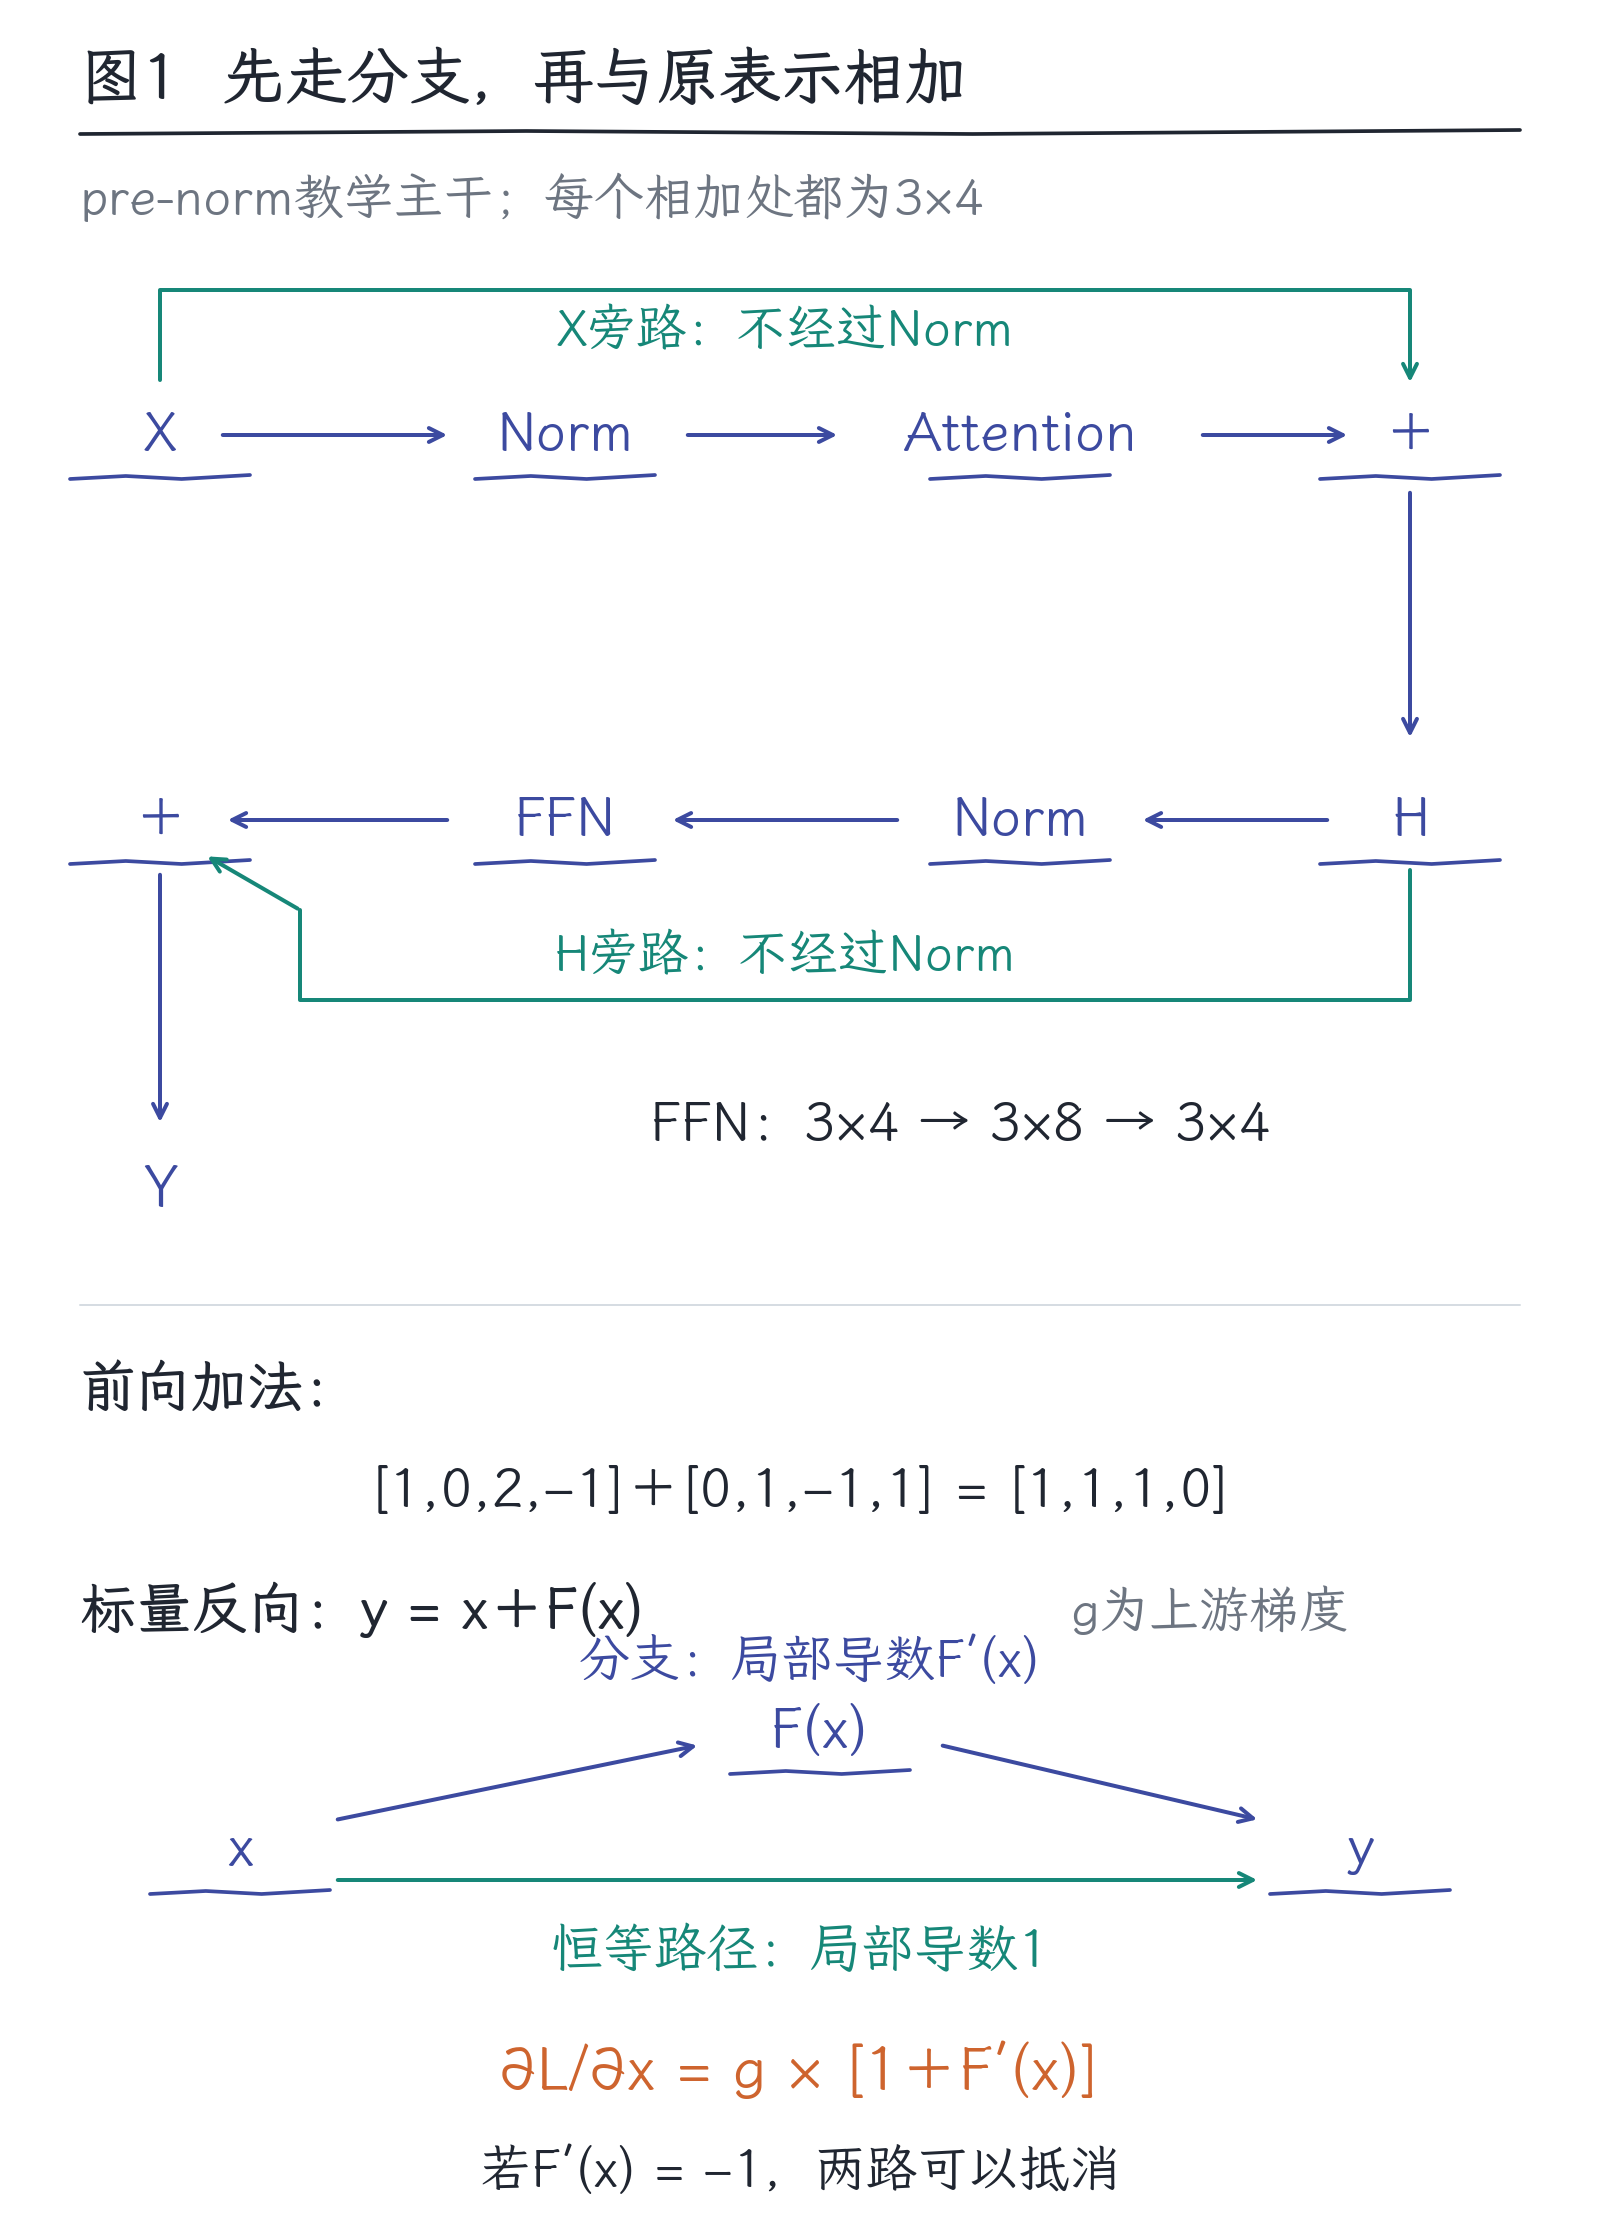
图1|pre-norm的旁路绕过Norm,分支输出才与原表示相加。下半部分单独用标量y=x+F(x)解释梯度:恒等路径贡献1,分支贡献F′(x),两者相加;不把它误作完整模型梯度。
3.注意力改变内容,通常不改变位置数
设这个小模型有两个注意力头,每头两维。归一化后的3×4输入,经各头的投影,分别产生3×2的Q、K、V。
一个头的三个查询,与三个键两两匹配,形成3×3的分数表。行表示谁在查询,列表示读取谁。应用因果mask,再按行计算softmax,得到每行合计为1的读取权重。
权重表3×3乘上V的3×2,得到3×2:仍然三个位置,每个位置取回两个数。两个头的结果拼成3×4,再经过输出投影,得到可与X相加的3×4。
可以先在纸上只写尺寸,不写任何元素。如果把输出投影误画成3×6,下一步与3×4相加就接不上。检查尺寸不是形式主义,而是验证图里是否真的定义了一套可执行计算。
同一层中,各个位置读取的是送入这层的表示。第一个位置刚算出的结果,不会立刻成为同一层第二个位置的输入。因此,同一层的多个位置可以成批计算;层与层之间仍有先后依赖。
还可以做一个不用知道权重的实验:固定参数,只把第三个位置“小狗”换成“小鸟”。第一层中,前两个位置看不到这个改动,所以它们的结果不变;第三个位置可能改变。进入第二层时,前两个位置依然只能读未受影响的前缀,所以改动仍不能倒流。逐层重复这个检查,就能理解为什么只在最外面挡一次未来信息是不够的,每一层都要遵守可见范围。这个判断假定没有其他跨位置的泄漏路径。
实现时,可以把这两条“前缀相同、后缀不同”的输入保留下来,检查前缀位置的输出是否符合上述不变关系。这与软件测试检查模块之间的信息边界相通:输出形状接得上,还要确认禁止的依赖没有偷偷接上。在本章不含随机步骤的计算里,未来变化不应改变前缀结果;这项检查即使通过,也只支持相应的信息隔离,不能证明模型读懂了句意。
多个头提供不同的读取与组合路径,却没有一个“主语头”“事实头”的固定岗位表。这些路径究竟学了什么,要通过实验分析。
4.FFN在每一行里继续加工
注意力把其他位置的信息带来,FFN再对当前行做非线性变换。沿用第06章的简单结构:四维输入乘4×8的权重矩阵,得到八维;通过非线性;再乘8×4的矩阵,回到四维。偏置若存在,按对应输出项相加,不改变形状。
因此,整张表的路径是3×4 → 3×8 → 3×4。同一层的三行共用这套FFN参数,但互不直接读取对方的行。当前行已经被注意力更新过,所以“逐行处理”并不等于“完全不知道上下文”。
中间加宽提供更多可学习的组合,非线性让这些组合对不同输入产生不同响应,最后再投影回主干宽度,方便下一次残差相加。它不会因为数字变多就凭空增加事实。
原始Transformer使用两次线性变换和ReLU;现代模型可能使用门控结构,例如第06章提过的SwiGLU。读图时要分清“逐位置加工”这个共同作用,与模块内部具体采用哪种公式。原论文的前馈网络
5.残差让分支学习怎样修改已有表示
单独做一次加法实验。假设某行原表示是[1,0,2,-1],一个分支给出的结果是[0,1,-1,1],相加得到[1,1,1,0]。这只检验残差加法,不声称已经给出产生该分支结果的完整权重。
若分支输出全为0,这段主干就原样通过。于是分支可以学习“在已有结果上补什么、改什么”,不必每次从零重新制造整份表示。这是残差结构的重要直觉。残差学习原论文
结合第07章的反向传播再看:主干有一条直接绕过分支的路径,梯度也能沿这条路径传回较早的层。这样有助于深层网络的优化,但不是无条件保证梯度永远健康,更不是保证堆得越深越准确。TensorFlow官方教程对残差路径的解释
把一行暂缩成一个数,写y=x+F(x)。x稍增一点,直达路径让y同样增加一点;分支还带来F′(x)倍的变化。这里F′(x)读作“F在x处的导数”,就是分支在当前位置的局部斜率。因此dy/dx=1+F′(x)。若从后面传来的损失梯度是g,则传到x的是g×[1+F′(x)]。例如g=2、F′(x)=0.5时得到3;若F′(x)=-1,两路恰好抵消,结果为0。残差提供直接路径,却没有取消抵消或其他数值问题。
残差也不等于无损备份。[1,0]加上[-1,0]就变成[0,0],原信息可能被抵消;相加后的四个数也不会自动附带“哪部分来自哪条路”的标签。它提供的是计算路径,不是一份可随时恢复的原文档案。
6.归一化管的是数值尺度
多次乘加可能让不同层的数值尺度差别很大。归一化根据当前表示计算一个尺度,再调整各项,帮助后续计算和训练保持可控。它不是把句子翻译成标准语言。
看LayerNorm的简化算例:一行是[1,1,3,3],平均值为2。逐项减去2,得到[-1,-1,1,1];四个偏差的平方平均为1,开平方仍为1;再除以这个数,结果不变。
这是暂不加入数值稳定小量、并把可学习缩放设为1、平移设为0的结果。实际实现会加入小量,避免分母为0;缩放与平移也可以学习。输出不一定一直保持平均值0、方差1。LayerNorm原论文
RMSNorm少了“减平均值”这一步。对同一行,四项平方的平均是5,开平方得到√5,于是先得到[1/√5,1/√5,3/√5,3/√5],再应用可学习缩放。它不要求输出均值为0。RMSNorm原论文
在本文主干里,这些统计都在一个位置自己的四个数上计算。第三个位置出现什么词,不会通过这一步进入第一个位置。若错误地把整句话所有位置混在一起求统计量,甚至可能绕过因果mask泄漏未来信息。
把“统计范围”和“变换公式”一起核对,才能知道Norm是否接对。对这行数据,LayerNorm先去掉整体偏移2;RMSNorm保留偏移,只按均方根调整幅度,所以它得到约[0.4472,0.4472,1.3416,1.3416],均值约0.8944。两者都叫归一化,并不意味着输出相同。
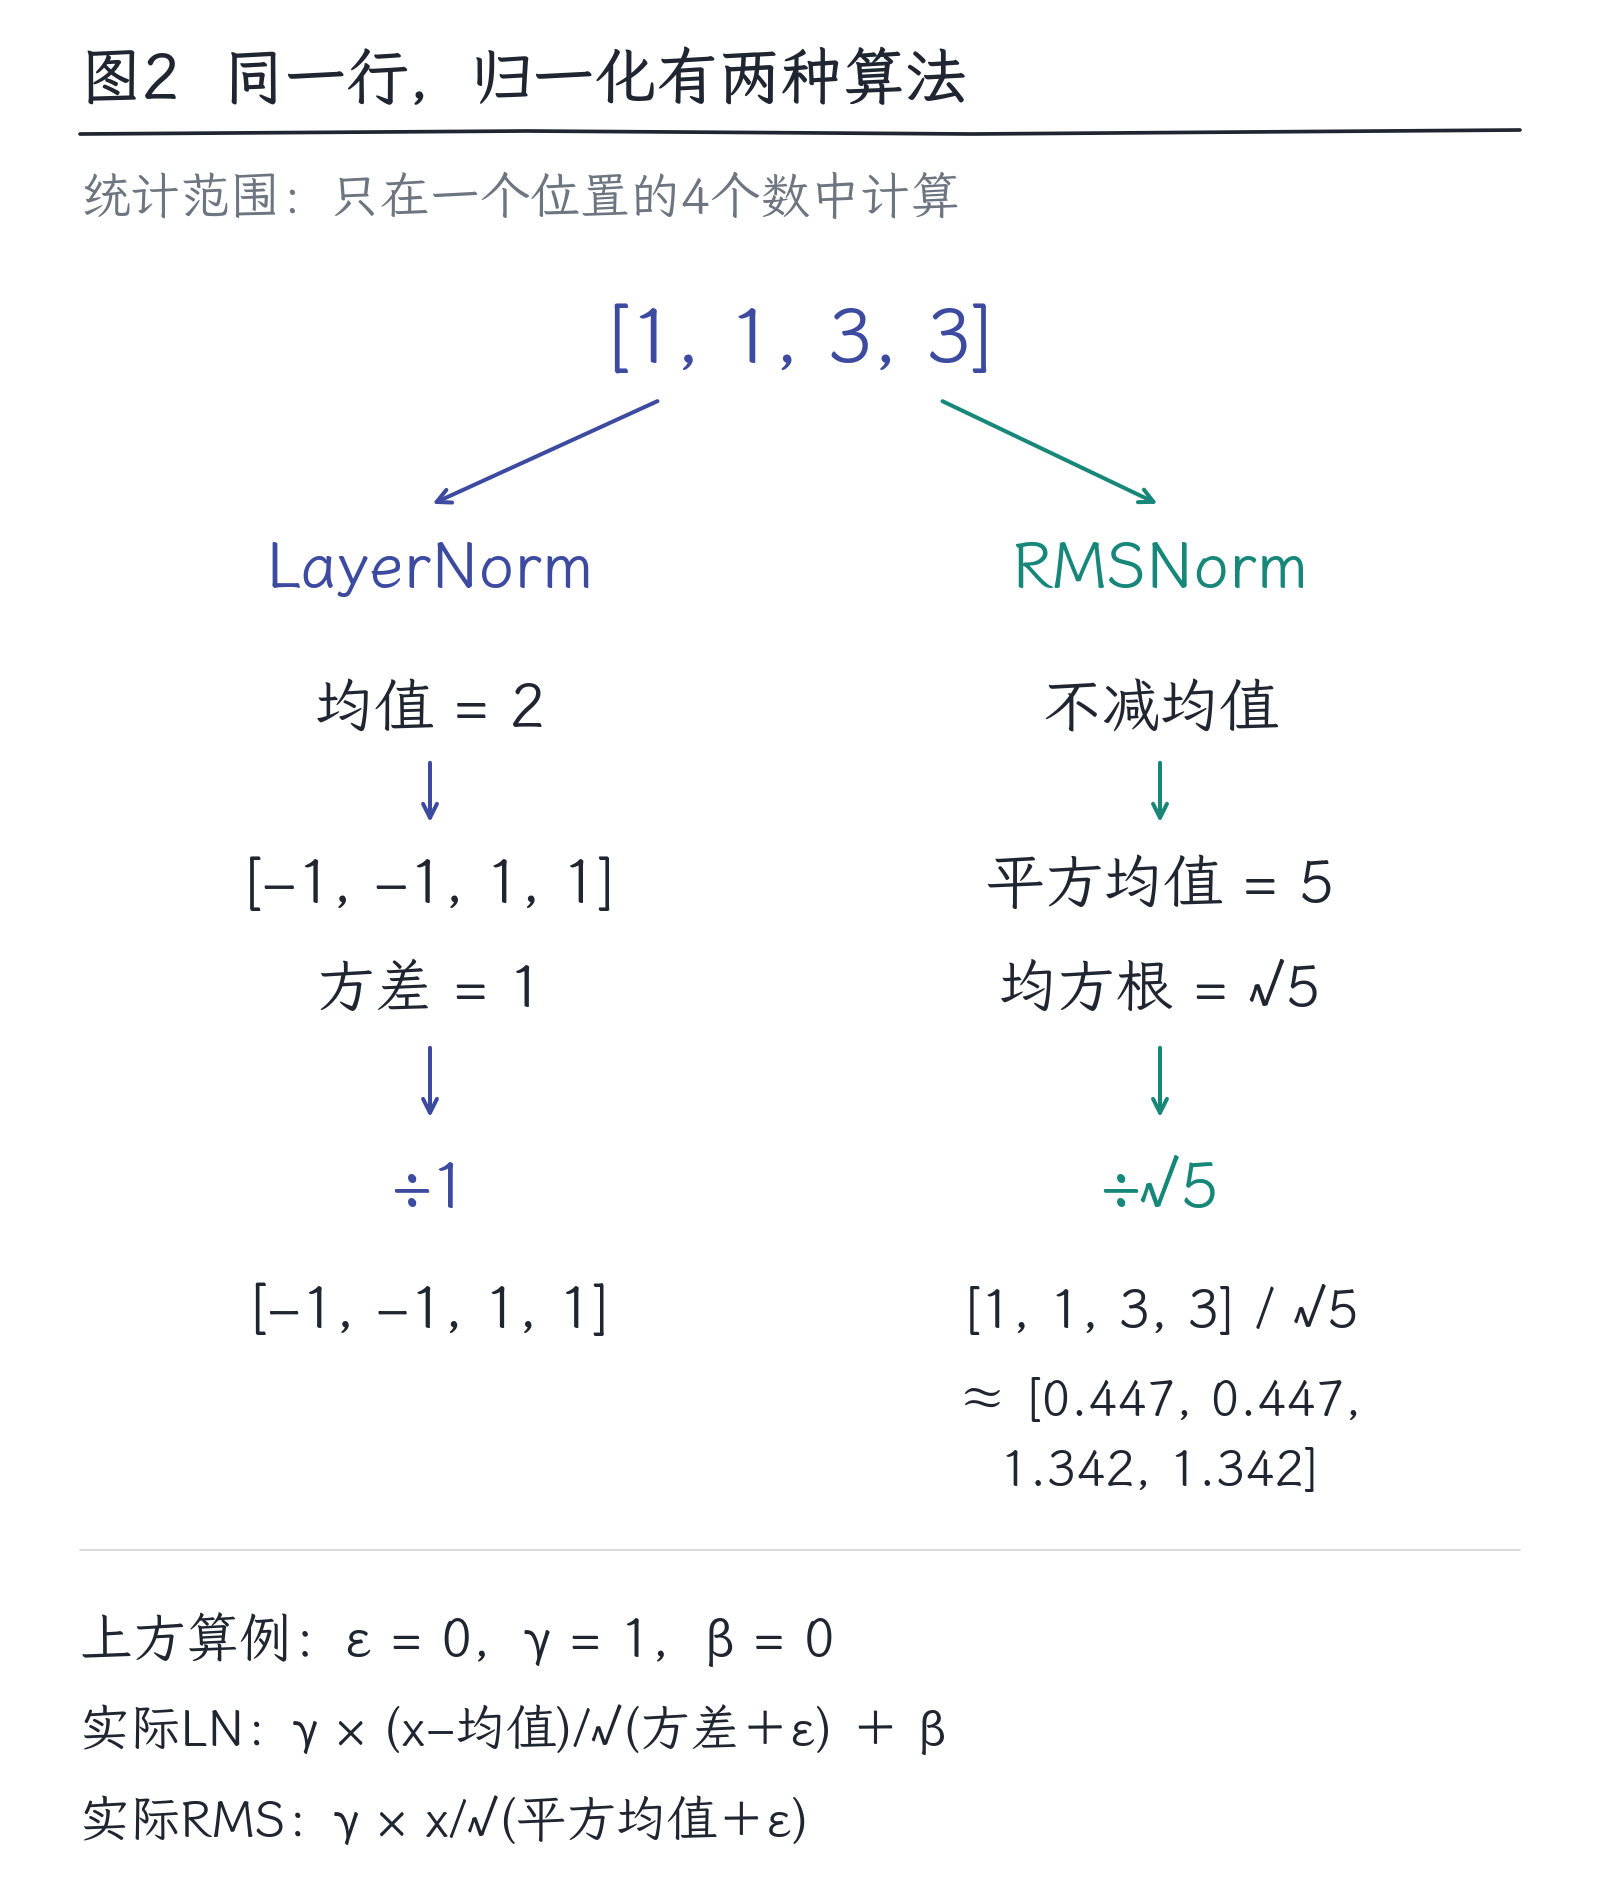
图2|同一行[1,1,3,3]分两路:LayerNorm先减均值2,再除标准差1;RMSNorm直接除√5。数值算例取ε=0、γ=1、β=0;真实分母内加入ε,并应用可学习参数。统计只在本行四维内进行。
7.位置机制和mask分别解决什么
“小猫追小狗”与“小狗追小猫”使用相同的词,关系却不同。对于没有位置机制、也没有mask的自注意力,同步交换输入行,只会相应交换输出行;它不能仅凭这组词识别谁在前面。
原始Transformer把位置编码加到词向量上,让相同token在不同位置携带不同的位置线索。其他模型也可以通过修改注意力计算加入位置信息。因果mask本身带来前缀范围的不对称,但“哪些位置可读”与“相隔多远”仍是不同问题。
RoPE的直觉是把Q和K中的成对坐标按位置旋转,再做点积。只看二维:两个原本都是[1,0]的箭头,同向时点积为1;相差90度时点积为0。若把两个箭头一起再转相同角度,相对夹角不变,点积也不变。
因此,旋转可以让匹配分数携带相对位置的信息。真实RoPE在多组成对坐标上使用不同频率,并非所有位置都按90度旋转,也不是简单把位置编号加到每个数上。这个几何性质本身不保证模型能可靠处理任意长文本。RoPE原论文
mask则直接禁止某些连接。即使RoPE让两个位置很匹配,被禁止的位置仍不能读。二者通常需要共同工作。
可以手算同步旋转:q=[1,0]、k=[0,1]原本点积为0。共同旋转45°后,q变为[√2/2,√2/2],k变为[-√2/2,√2/2],点积仍是-1/2+1/2=0。保持不变的是相对夹角,两个向量各自的坐标已经变化。
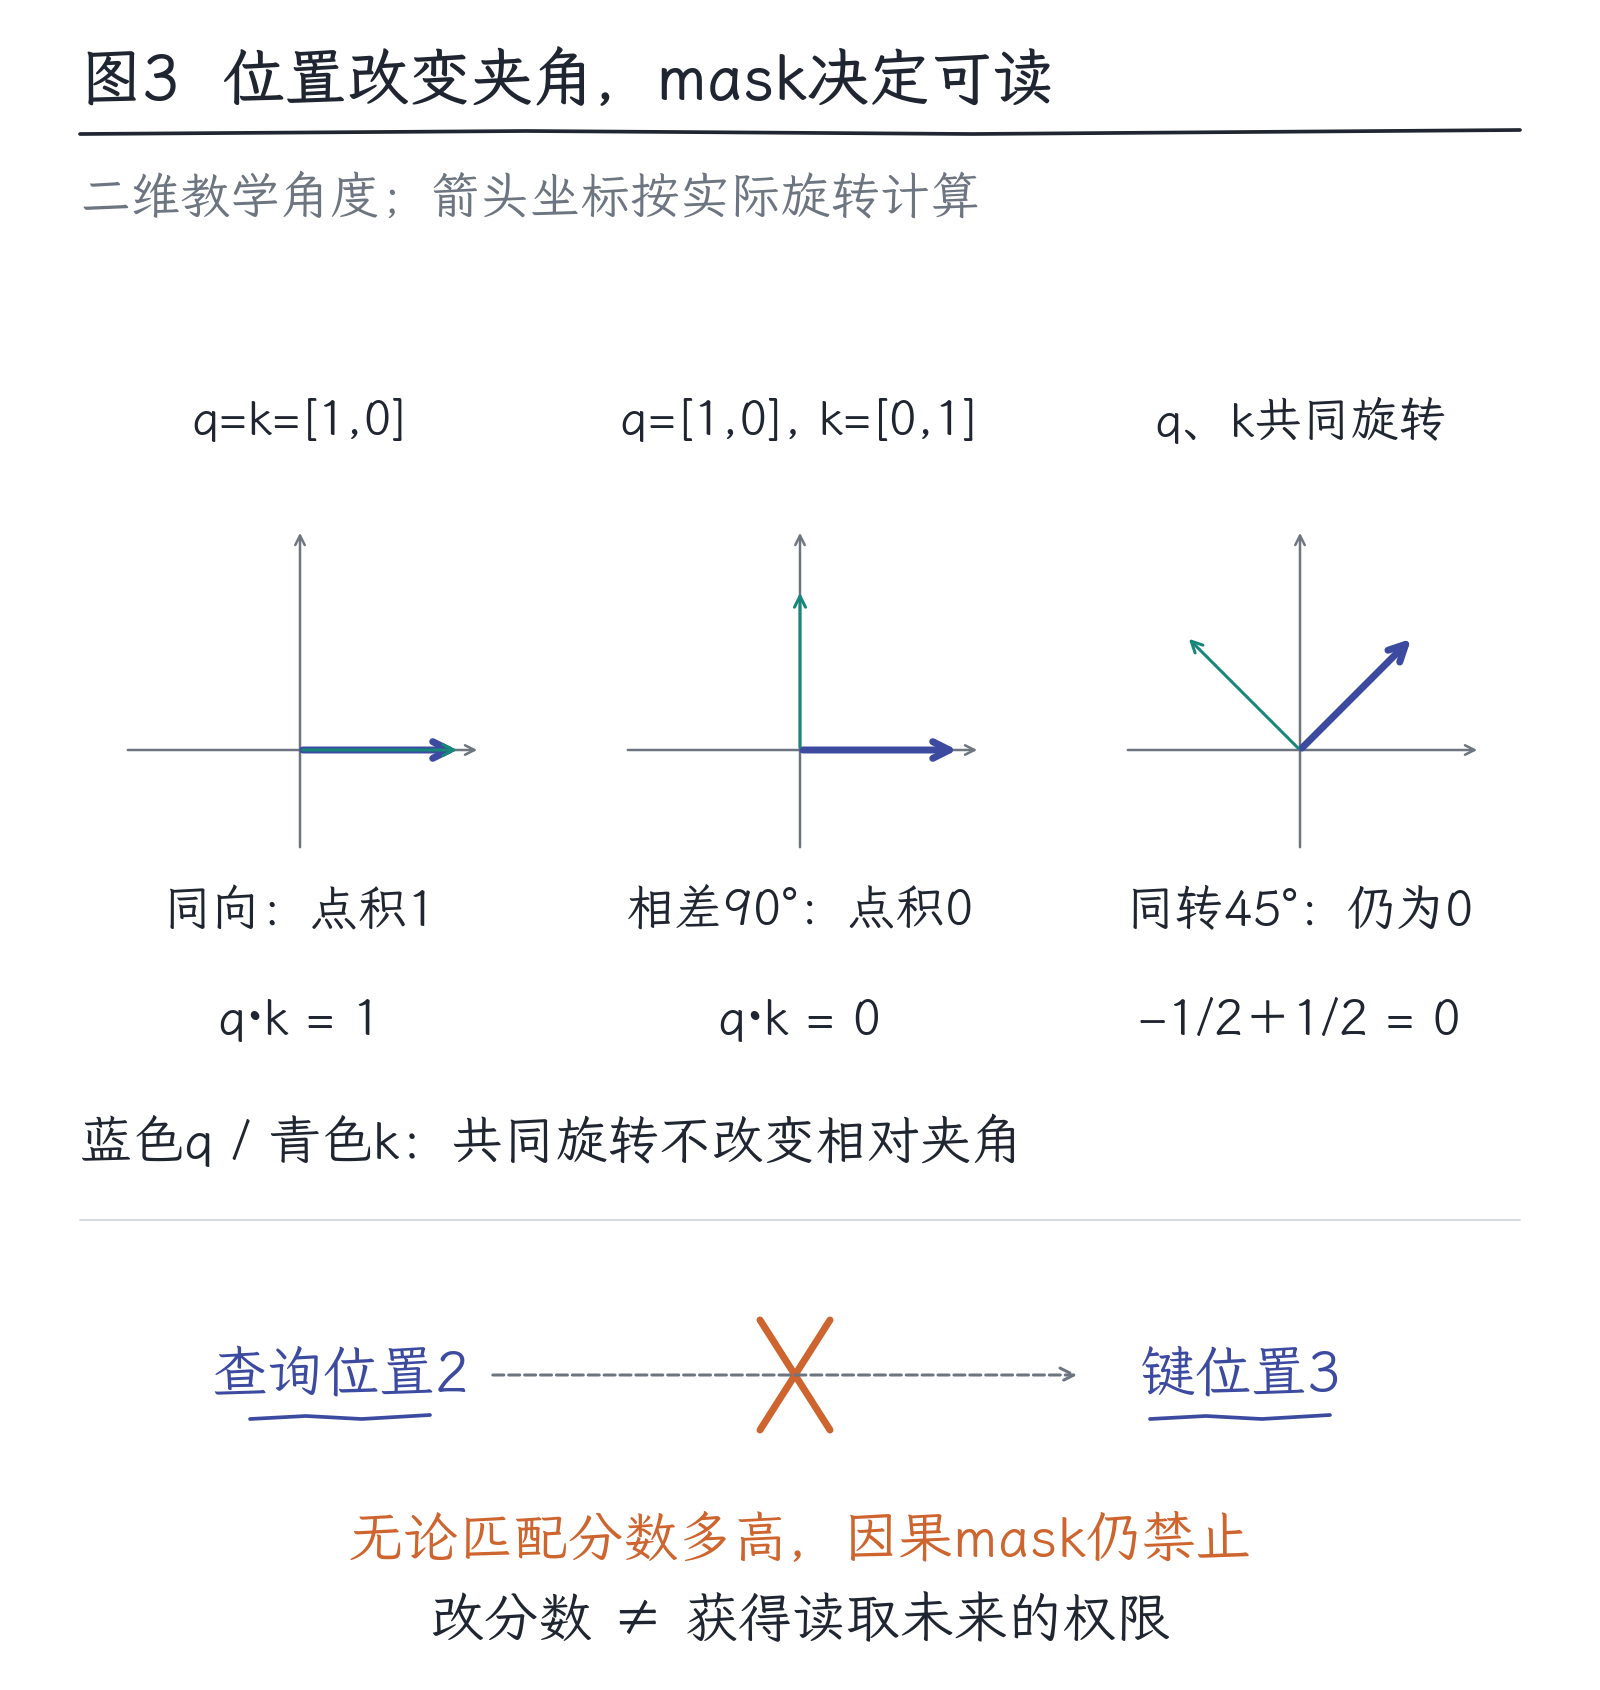
图3|二维旋转的实际箭头:同向点积1,相差90°点积0,再共同转45°仍为0。下方另画“位置2不能读位置3”的被禁连接,区分改变匹配分数与禁止访问;90°只是教学角度。
8.Transformer并不只有一种外形
编码器,即encoder,通常让输入中的各位置双向读取,适合把完整输入转成上下文表示。BERT是典型例子。它从选中的预测位置恢复原token:原论文把这些位置中的80%替换为MASK、10%换成随机token、10%保留原样。因而不能笼统说它把所有目标都遮住了;双向可见要与这种样本构造和训练目标一起理解。BERT原论文
纯解码器,即decoder-only,在自回归语言模型中采用因果读取。堆叠多个模块后,经最终归一化和词表投影,可以把3×4变成3×词表大小的分数,再得到各位置的下一token分布。自由续写时通常取最后一个位置的分布决定下一步。
编码器—解码器,即encoder-decoder,则有两条主干。例如翻译时,编码器先读取完整原文;解码器只能读取已给出的译文前缀,同时通过交叉注意力访问编码器的输出。交叉注意力的Q来自解码器,K、V来自编码结果。原始Transformer的信息流
判断这三类结构,可以用同一个检查法:圈出当前查询,再标出它能读的来源。译文端能读完整原文,不等于能读未来译文;交叉注意力的来源和自注意力的时间限制必须分别检查。
9.把教学图放回真实模型
Qwen团队的2025年Qwen3技术报告明确列出:其稠密模型采用分组查询注意力GQA、SwiGLU、RoPE,以及预归一化的RMSNorm,还在注意力中引入QK-Norm。官方Qwen3-8B模型卡将其标为因果语言模型。Qwen3架构报告、官方模型卡
这说明本文的pre-norm主干有现实对应,但“两头、四维、八维FFN”只是便于检查的教学配置。QK-Norm作用于注意力内部的Q、K,也不能与主干上的RMSNorm混为一个步骤。
一层输出仍为3×4,可以继续送进下一层。通常各层有各自的参数,因此是不断更新表示,而非把同一张固定表抄写几十遍。不能未经证据就说第一层管词义、第二层管语法、最后一层管推理。
“深”带来的机会是后面的层可以继续处理前面已经组合过的信息。例如,一次读取先汇合若干线索,下一层再依据更新后的表示决定读取对象。这是计算可以逐步组合的原因,却不能据此推断某个具体模型已经掌握了特定推理规则。
更多层意味着更多计算与中间结果;更长输入意味着注意力需要考虑更多位置对。按显式完整分数表计,位置数从3增到6,格子从9增到36。具体实现的存储方式可以不同,但可见关系带来的计算代价不能只靠画小方框忽略。增加深度、宽度和输入长度,也不是同一种扩容:一个增加串联步骤,一个增加每步的表示空间,一个增加可读取的材料。它们怎样搭配,要结合数据和预算判断。
本章练习
题目
问题1|检查模块接口
FFN把3×4变成3×8再变回3×4,各数字各代表什么?若最后输出3×6,能直接与原X作本章的残差加法吗?
问题2|残差的前向与反向
原行[1,0,2,-1]加上分支[0,1,-1,1]是什么?另取标量y=x+F(x),g=2、F′(x)=-1时传到x的梯度是多少?
问题3|手算两种归一化
对[1,1,3,3]取ε=0、γ=1、β=0,分别写LayerNorm与RMSNorm的输出。它们是否跨三个token求统计?
问题4|区分位置与可见性
把q=[1,0]与k=[0,1]共同旋转45°,点积是多少?如果它们来自查询位置2与键位置3,旋转会解除因果mask吗?
思考提示
提示1|对应问题1
行数是位置数;残差的每个元素要有同形的对应项。
提示2|对应问题2
前向逐项相加;反向把直达与分支贡献相加,再乘上游梯度。
提示3|对应问题3
先分别求平均数、中心化方差和平方的平均数。
提示4|对应问题4
先算旋转后的坐标;再单独检查可见范围。
参考答案与解析
答案1|对应问题1
3始终是token位置数,4是主干宽度,8是FFN中间宽度,没有新增token。3×6不能直接与3×4逐项相加,必须先设计回到兼容形状的变换;尺寸兼容也只是计算有效的必要检查。
答案2|对应问题2
前向为[1,1,1,0]。标量反向为2×[1+(-1)]=0,说明恒等路径虽存在,分支仍可能抵消其贡献。若分支输出全零,当前残差加法原样通过,但这不约束其他层。
答案3|对应问题3
LayerNorm为[-1,-1,1,1];RMSNorm为[1/√5,1/√5,3/√5,3/√5],约[0.4472,0.4472,1.3416,1.3416]。本章统计在每个位置自己的四维内完成,不跨三个token;实际可学习变换也可能改变最终均值。
答案4|对应问题4
旋转后分别为[√2/2,√2/2]、[-√2/2,√2/2],点积为0。因果mask仍禁止位置2读取位置3;RoPE改变匹配中的位置关系,不赋予访问未来的权限。
下一章
现在计算结构已经接通,参数却还需要学习。下一章从一条普通句子出发:同一层为什么能并行产生许多预测信号,这些信号又怎样推动共享参数学到可复用的关系?