先修:01 模型、目标与假设;02 命题与条件;分数、百分比与分类计数
设想一套设备监控系统。介绍材料写着:“故障检出比例99%,健康状态下误报比例仅1%。”值班人员满怀期待地打开告警列表,核查结束后,却发现其中只有一半对应真故障。这套系统在夸大效果吗?还是有人把账算错了?
两边可能都没有说错。检测器面对真故障时有多灵,和收到告警后其中有多少是真的,问的是两件事。本章先不引入概率公式,只整理一张台账。困惑的关键就藏在除法的分母里。
先约定怎样算一次
我们用一份专为讲解构造的虚构台账,共有10000条记录,并非实际系统评测。每条记录对应“某台设备的一段五分钟”,叫一个检测窗口。同一设备的窗口不重叠;每个窗口只记一次“告警”或“未告警”,即使系统在这五分钟内连续响了三次,也不重复计数。
另有事后核查标签,记为“确有故障”或“健康”。本例把故障范围事先定好,并假定标签准确、每个窗口恰属一类。现实中,传感器短暂异常算不算故障、维修记录是否完整,都需要另行核验。
因此,这里数的是窗口,不是设备台数,也不是相互独立的事故数。一次持续十五分钟的故障可能占据三个窗口。把窗口比例改口说成“设备中有多少会坏”,就已经换了计数对象。
现在摊开台账:100个窗口确有故障,9900个窗口健康。检测器在前一组报出了99个,漏了1个;在后一组误报99个,其余9801个保持安静。
| 事后核查状态 | 发出告警 | 未发出告警 | 合计 |
|---|---|---|---|
| 确有故障 | 99 | 1 | 100 |
| 健康 | 99 | 9801 | 9900 |
| 合计 | 198 | 9802 | 10000 |
先查加法:两行分别加回100、9900,两列加回198、9802,所有格子加回10000。比起立刻看百分数,这一步更能发现重复统计或漏掉的记录。
两个漂亮的数字,各自除以谁
“故障检出比例99%”是从确有故障的100个窗口出发,问其中多少发出了告警:
故障检出比例=99÷100=99%。
它常叫灵敏度,在机器学习分类任务中也叫召回率。相应地,“健康误报比例1%”从健康的9900个窗口出发:
健康误报比例=99÷9900=1%。
这叫假阳性率。这里把“发出告警”称作阳性,把“没有告警”称作阴性;阳性只是检测结果的名称,不等于故障已被证实。1
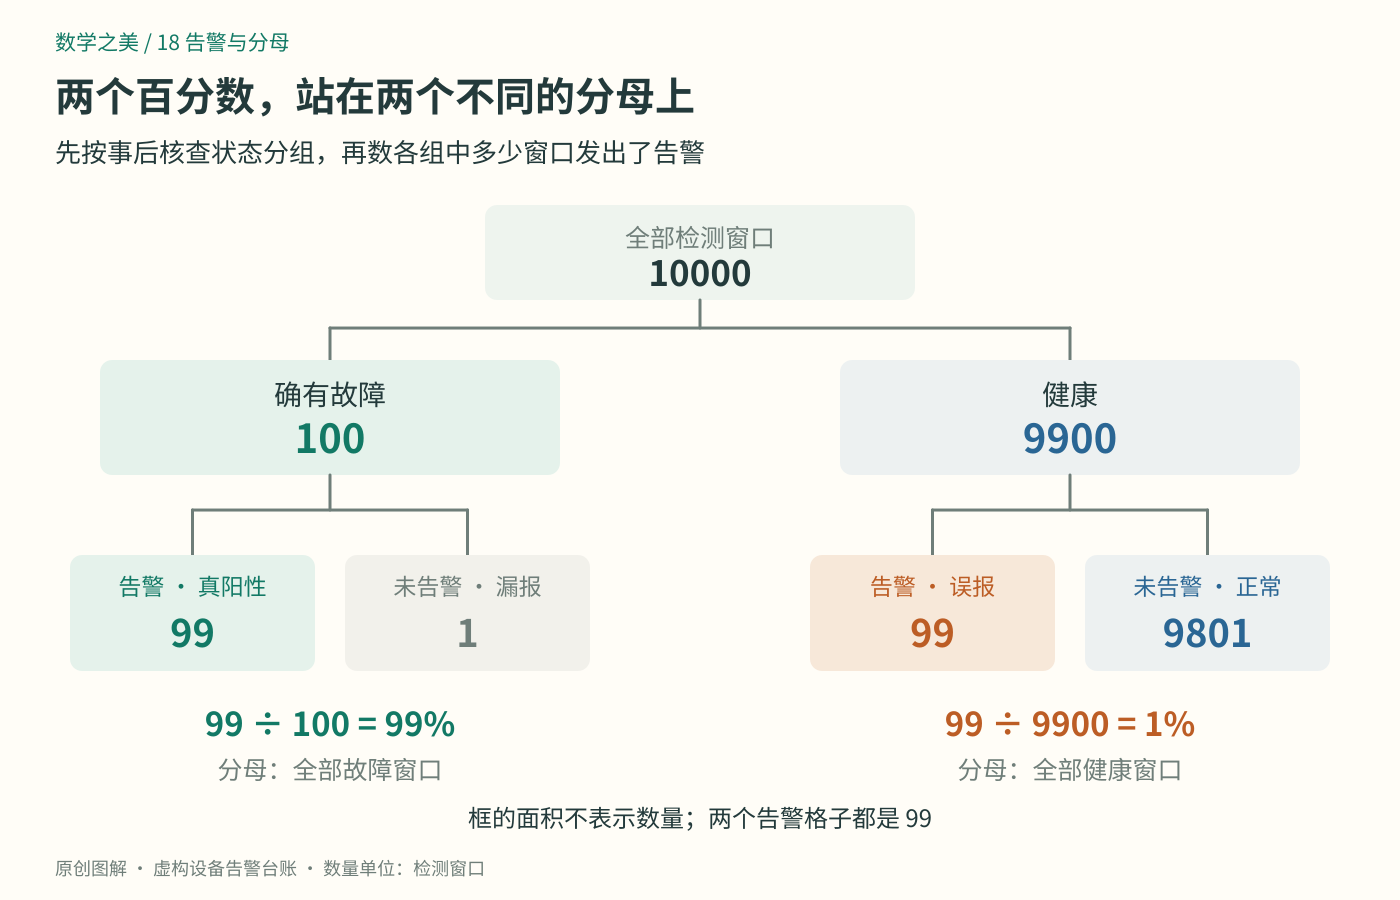
图1:树上的每一步都在分组,框的面积不表示数量。左侧的99%除以100,右侧的1%除以9900。
四个格子也有常用名称:故障且告警是真阳性,记作TP;故障却未告警是假阴性,记作FN;健康却告警是假阳性,记作FP;健康且未告警是真阴性,记作TN。先记住格子含义,比背缩写更重要。
留意一个容易滑过去的细节:两个告警格子都是99。检测器只误伤了健康组的百分之一,可健康窗口足足是故障窗口的99倍。一个很小的比例,乘上一个很大的基数,仍会送来不少消息。
说“误报只有1%,所以收到的消息只有1%是假的”,就把分母悄悄换了。9900是全部健康窗口,绝不是全部告警。
打开告警列表,重新数一次
值班人员不会在列表里看见那9801个健康且安静的窗口,也不会直接看见漏掉的1个故障。他们眼前只有198条告警:99条来自真故障,99条来自健康窗口。
现在的问题是“告警中真故障占多少”,所以先把全部告警圈出来,再在这个集合里数真故障:
告警中的真故障比例=99÷(99+99)=99÷198=50%。
这个量在机器学习中叫精确率,在检测语境中也叫阳性预测值。1 本章说“告警可信度”时,专指这张台账里的这个比例。
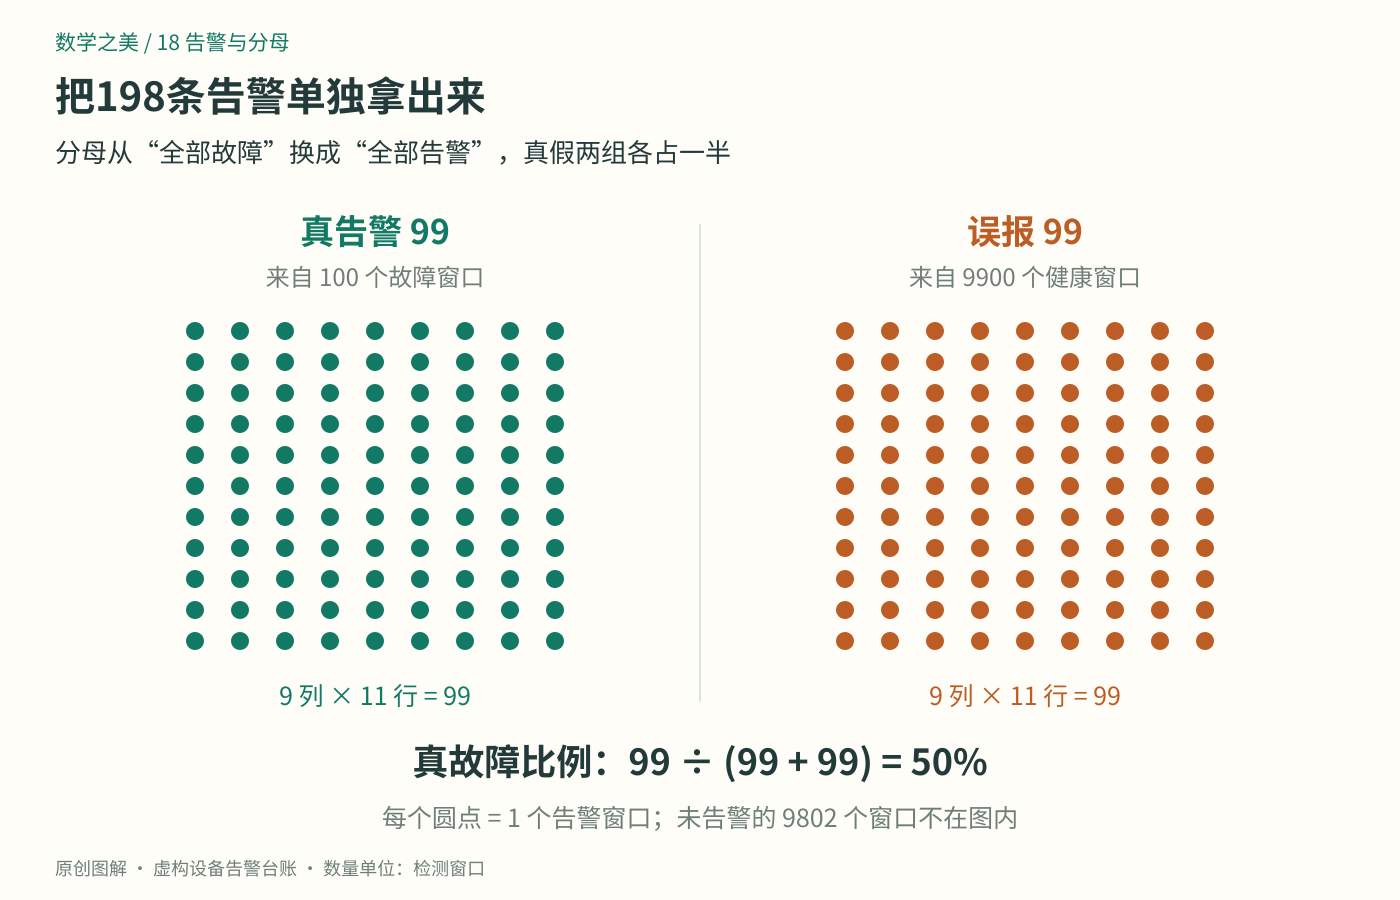
图2:每个圆点代表一条告警窗口记录。两组都是99个,所以各占这张告警列表的一半。
这里没有复杂运算,只发生了观察范围的变化。算检出比例时,漏报的1个故障在分母里,99个误报不在;算告警可信度时,99个误报进入分母,漏报的1个反而退出。
这也说明,50%不能读成“告警完全没提供信息”。整张台账只有100÷10000=1%的窗口有故障;筛选到告警这198个窗口后,真故障占了一半。告警确实把值得核查的范围大幅缩小了,只是仍留下许多假消息。
同样,台账也没有说列表里真假严格交替。连续几条都误报,或连续几条都是真故障,都不与总数冲突。一个分组比例没有交代记录出现的顺序。
换一张台账,检测表现先保持相同
接着构造第二张10000窗口的台账,让故障窗口增加到1000,健康窗口变成9000。为了单独看清分组数量的影响,我们规定故障检出比例仍为99%,健康误报比例仍为1%。
于是,故障组检出1000×99%=990个,漏掉10个;健康组误报9000×1%=90个,剩下8910个未告警。
| 事后核查状态 | 发出告警 | 未发出告警 | 合计 |
|---|---|---|---|
| 确有故障 | 990 | 10 | 1000 |
| 健康 | 90 | 8910 | 9000 |
| 合计 | 1080 | 8920 | 10000 |
告警共990+90=1080个,其中真故障比例为:
990÷1080=11/12,约为91.67%。
两张台账中,故障窗口占全部窗口的比例分别为1%和10%。我们把这个尚未按告警筛选的比例,叫作故障的基准比例。保持组内检测表现不变,只改变基准比例,告警可信度就从50%变成了约91.67%。检测领域同样需要区分这两层比例。2
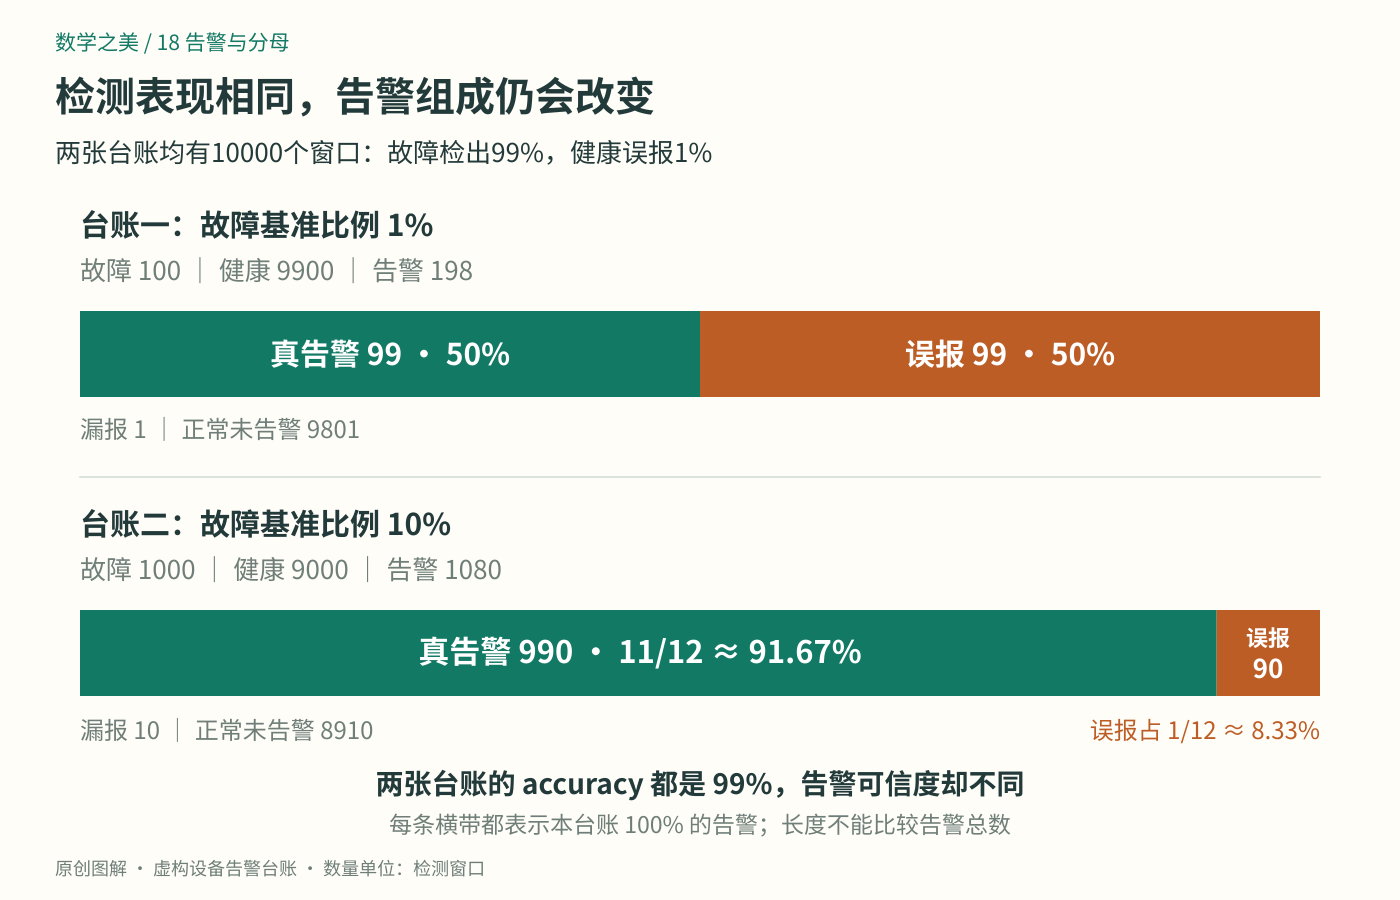
图3:两条横带各表示本台账的全部告警,长度都归一化为100%。它们比较组成,不能用总长度比较198与1080的数量。
这次对照没有给检测器升级。我们固定了两个组内比例,改变的是进入系统的窗口构成。反过来,只看到告警可信度下降,也不能立刻认定模型退化;要分别检查基准比例和两个组内的表现。
真实部署未必满足“组内表现保持不变”。换一批设备,故障类型、传感器噪声都可能改变。这个假定让本例能单独研究基准比例的作用,并不承诺换场景后检测能力自动稳定。
为什么两边的准确率都是99%
如果把所有判断正确的窗口一起数,便得到整体正确比例,通常称为准确率,英文是accuracy:
第一张:准确率=(99+9801)÷10000=99%;
第二张:准确率=(990+8910)÷10000=99%。
两张台账的准确率完全相同,告警可信度却很不同。在这个特定构造里,故障组判对99%,健康组也判对99%,所以无论两组怎样搭配,整体正确比例仍是99%。一般情况下,两组正确比例不同,改变构成也会改变accuracy。
因此,孤零零的“准确率99%”信息太少。如果它确指accuracy,分母就是全部检测窗口;绝不能将它改写成“收到的告警99%为真”。1
还可以作一个更尖锐的检查:对第一张台账,一个永远不告警的规则,也能把9900个健康窗口全部判对,accuracy同样是99%。可它一个故障也没找到,故障检出比例为0。由于告警数为0,“告警中真故障比例”的除法分母也是0,这个比例没有定义,不能夸成100%。
总体判对很多次,未必完成了“找出罕见故障”这个任务。一个总分把四格压缩后,会隐藏我们真正关心的差别。
从算对账,到用好告警
这些数字都是固定台账的描述。它们不保证明天恰好每100个故障检出99个,更不保证未来198条告警仍有99条为真。要讨论未来,需要说明新窗口怎样产生、记录是否有代表性,以及比例会不会变化。第19至23章将逐步补上这些工具。
实际计数还必须是整数。若只有1个故障窗口,它要么被检出,要么被漏掉,单次台账中的检出比例只能是100%或0%。不能硬套99%,写出“检出0.99个故障”。小规模记录、长期表现与模型中的概率,必须分清。
把这套方法用于AI缺陷识别、异常日志检测或垃圾邮件过滤,首先要约定正类是什么、每条记录怎样计数。其次要保留四格及其行列合计,防止把精确率与准确率混叫成一个“准确”。最后应检查评测数据的构成:刻意收集许多故障样本有助于观察检出情况,但其中算出的告警可信度,不能直接搬到故障稀少的日常流量里。
核查范围也要覆盖未告警窗口。如果只检查响过的告警,可以数出其中多少为真,却无从知道安静的窗口漏了多少故障。漏报可能只是没有被看见,而非不存在。
至于收到告警该不该立刻停机,仅靠50%还不能决定。一次漏掉严重故障的损失,与一次误报后短暂检查的成本可能相差很大;故障严重度、复核方式和处理成本都会影响安排。本章先把证据算清,暂不替这些工程判断制定规则。
回到开头,告警很灵而假消息仍多,并不矛盾:健康窗口基数大,少量误报比例也能积累出很多消息。下次见到一个漂亮的百分数,先问一句“在哪一组里,数了什么?”往往就能把问题重新看清。
顺手试一下
题目1: 在另一张虚构台账里共有20000个窗口,故障200个,健康19800个。保持故障检出99%、健康误报1%,写出四格、告警总数、准确率和告警可信度。记录总数翻倍后,为什么告警可信度没有提高?
**提示:**分别在故障组、健康组内计算,再把两个告警格子相加。
**参考答案:**TP=198,FN=2,FP=198,TN=19602。告警396个;准确率=(198+19602)÷20000=99%;告警可信度=198÷396=50%。四格都恰是第一张台账的两倍,故障基准比例仍是1%,所用检测比例也未变,因此这个固定构造中的告警组成没有改变。这里不能把“数量更多”直接理解成“每条告警更可信”。
题目2: 用第一张台账,分别求“全部健康窗口中误报占比”“全部告警中误报占比”“全部窗口中误报占比”。一位同事说:“既然误报占1%,198条告警里大约只有2条误报。”错在哪里?
**提示:**三个问题的分子都是99,但分母分别对应三个集合。
**参考答案:**三个比例依次为99÷9900=1%、99÷198=50%、99÷10000=0.99%。同事把以健康窗口为分母的1%,拿去乘告警数198,换错了分组。台账中的误报已有精确计数99条,无须用错置的百分数重新猜测。
参考与延伸
1 Google官方《Machine Learning Crash Course》,Classification: Accuracy, recall, precision, and related metrics。核对accuracy、recall、false positive rate、precision的分母,以及类别不均衡时整体准确率的局限。
2 宾夕法尼亚州立大学统计系,STAT 507课程讲义,第11章第11.3节 Sensitivity, Specificity, Positive Predictive Value, and Negative Predictive Value。核对灵敏度、阳性预测值与基准比例之间的区别。本文的设备场景及整数台账独立构造,不引用该课的医学算例。
本文台账、练习与图解均为原创教学构造,不是实测记录;参考资料只用于核对概念。
作者:Jiancheng Wang · 数学之美(独立原创)