先修:19 有限概率模型;21 期望;22 抽样平均与误差;24 前缀码;25 信息量与对数;26 熵与编码下界
上一章找到了一张平均长度最短的码表。但“最短”有一个前提:符号确实按指定的概率出现。若把常见的当成少见的,把少见的当成常见的,码表仍然可以无损解码,却可能让我们多付出许多位。
这份额外账单能不能准确算出来?沿着同一组四符号数据,我们会得到交叉熵和KL散度。它们不仅能说明编码为什么变长,也能解释:一个预测即使猜中了结果,它给出的概率仍然值得检查。
数据没变,收费表变了
继续假设符号只有A、B、C、D,真实发生概率依次为
p=(1/2,1/4,1/8,1/8)。
这里的“真实”指教学模型的设定,并不意味着从几次观测就能知道现实中的精确概率。按p设计的码表是A用0、B用10、C用110、D用111,长度为1、2、3、3,平均每符号需要7/4=1.75位。
现在编码者误以为分布是
q=(1/8,1/8,1/4,1/2)。
于是把最短码给D:A用110、B用111、C用10、D用0,长度为3、3、2、1。它同样是合法前缀码,接收者也共用这张新表。错误发生在概率判断上,解码规则并没有坏。
算新账时,到底用p还是q来加权?用p,因为数据仍然由p产生。A实际占一半,如今每次要付3位,因此它对平均账单的贡献是(1/2)×3=3/2位。不能因为编码者相信A很少见,就把实际出现的A少算几次。
四项加起来,新平均码长为
(1/2)×3+(1/4)×3+(1/8)×2+(1/8)×1=21/8=2.625位。
比原来多了21/8−7/4=7/8=0.875位/符号。
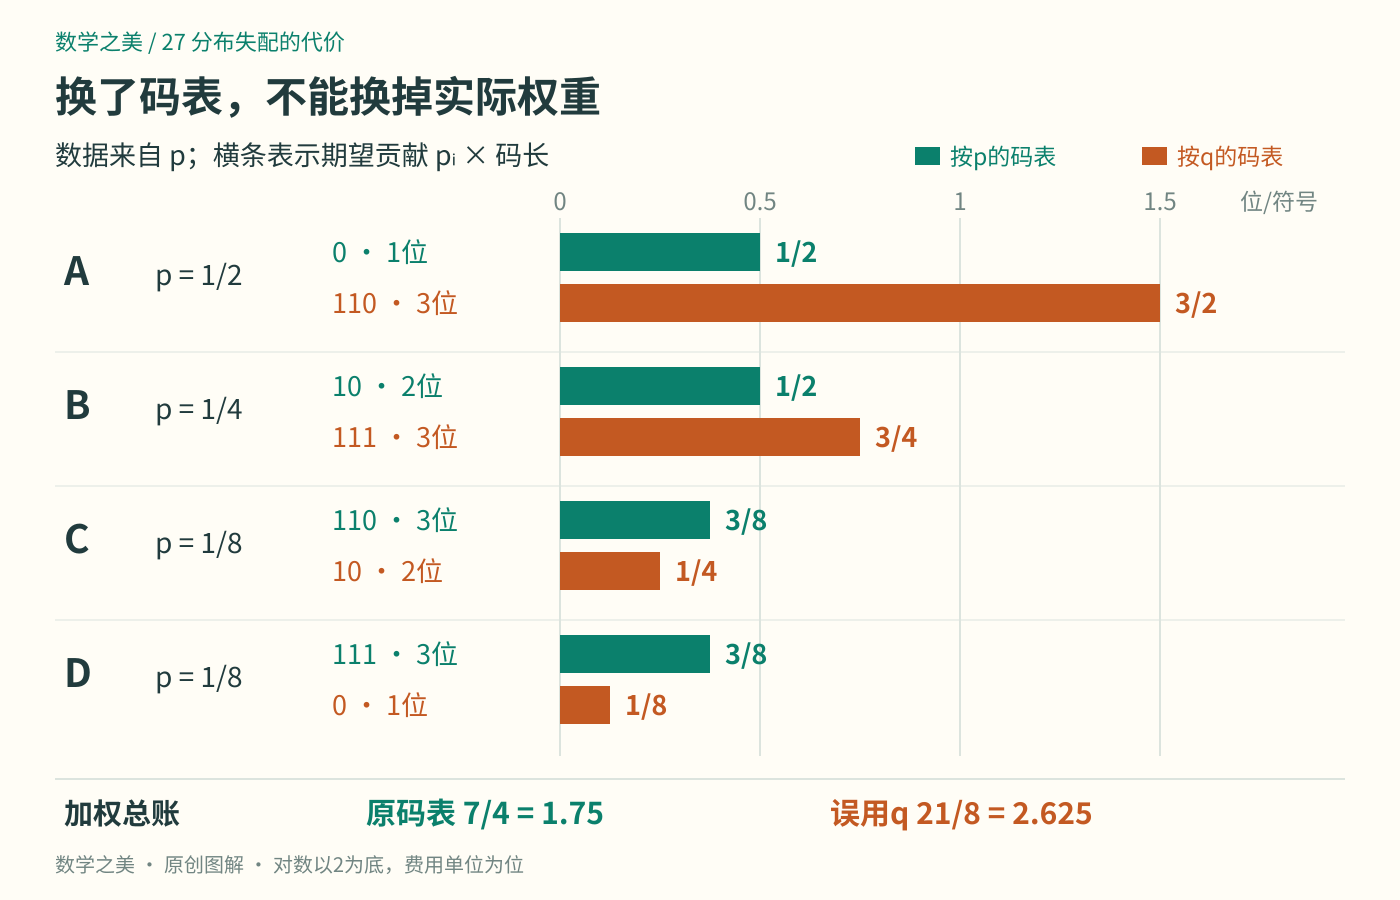
图1:两组横条都按真实概率p加权,宽度使用同一尺度。C、D确实省了位数,但省下的不足以抵消A、B的增加。
对第24章的具体消息AAAABBCD,新码表需要4×3+2×3+2+1=21位,旧表只需14位,恰好多7位。这条消息的比例恰好等于p,不能据此说任意八符号消息都多7位。例如消息只有D时,新表反而更短。我们接下来证明的是平均账单的规律。
这里求单符号的期望,并不要求前后符号独立。若一段消息有n个位置,每个位置的边际分布都是p,始终使用这张逐符号码表,那么由期望的线性性,总长度的期望就是n倍单符号期望。但若符号之间存在可利用的关联,改用整段编码还可能继续节省;那是改变编码方式后的另一个问题。
两个分布,各管一件事
第25章把−log₂qᵢ解释为按模型q计算的单次信息量。在刚才的例子中,q的各项是2的负整数次幂,所以它们恰好对应码长3、3、2、1。
若真实分布是p,选用模型是q,便把这份费用按p取期望,定义交叉熵:
H(p,q)=−Σᵢpᵢlog₂qᵢ。
Σᵢ表示遍历同一有限符号表后求和。pᵢ负责“这种结果实际占多大权重”,qᵢ负责“看到这种结果时收取多少费用”。只有分清两者,才不会把H(p,q)误算成−Σᵢqᵢlog₂qᵢ;后者是q自身的熵H(q)。
事实上,本例p与q只是把概率重新排列,所以H(p)与H(q)都等于1.75。两个分布的熵相同,完全不妨碍用错码表后平均花费2.625。这份损失取决于概率有没有分给正确的符号。
定义时先假定:凡pᵢ>0的地方,qᵢ也大于0。pᵢ=0的项约定贡献为0,即使qᵢ也为0,也不实际计算那个对数。这样做是在有限期望中忽略永不发生的结果。正概率结果被q判成0的情形,稍后单独处理。1
还有一条重要边界:一般的−log₂qᵢ未必是整数,不能直接声称每个符号真的用了这么多二进制位。此时它是理想码长,也可以直接作为对数损失。沿用上一章的向上取整构造,在q全正时可取ℓᵢ=⌈−log₂qᵢ⌉,存在对应前缀码,而且
H(p,q) ≤ Σᵢpᵢℓᵢ < H(p,q)+1。
这里多出来的是取整余量。本章的四符号例子不需要取整,交叉熵才与给出的实际平均码长精确相等。码表说明、消息边界等格式费用,仍须另算。
从总账中减掉必要的一笔
已知p时,它自身的熵是H(p)=−Σᵢpᵢlog₂pᵢ。现在把这笔基准费用从交叉熵中减去:
H(p,q)−H(p)
=Σᵢpᵢ(log₂pᵢ−log₂qᵢ)
=Σᵢpᵢlog₂(pᵢ/qᵢ)。
最后这个量叫KL散度,也叫相对熵,记作D(p∥q)。符号“∥”用于分隔两个有顺序的分布,不表示除法。于是得到
H(p,q)=H(p)+D(p∥q)。
左边是按q收费、按p结算的总账。右边第一项只由真实分布决定,第二项衡量选用q所增加的理想平均代价。它不是两个熵相减H(q)−H(p)。1
把本例逐项代入,四个概率比是4、2、1/2、1/4,对数分别为2、1、−1、−2。因此
D(p∥q)=(1/2)×2+(1/4)×1−(1/8)×1−(1/8)×2=7/8。
有些单项是负数,表示这种结果在q下收费更低。非负性若成立,只能是各项加权之后的整体结论,不能说每个符号都受罚。
分解还提醒我们保持比较口径。如果真实分布固定,只改变预测模型,那么交叉熵减少多少,失配代价就减少多少,因为基准H(p)没有变。但若换了一批性质不同的数据,真实分布也变了,较低的交叉熵可能只是来源本来更容易预测。脱离数据来源,把两个分数直接排成“模型优劣榜”,会混淆来源的不确定性与模型的失配。
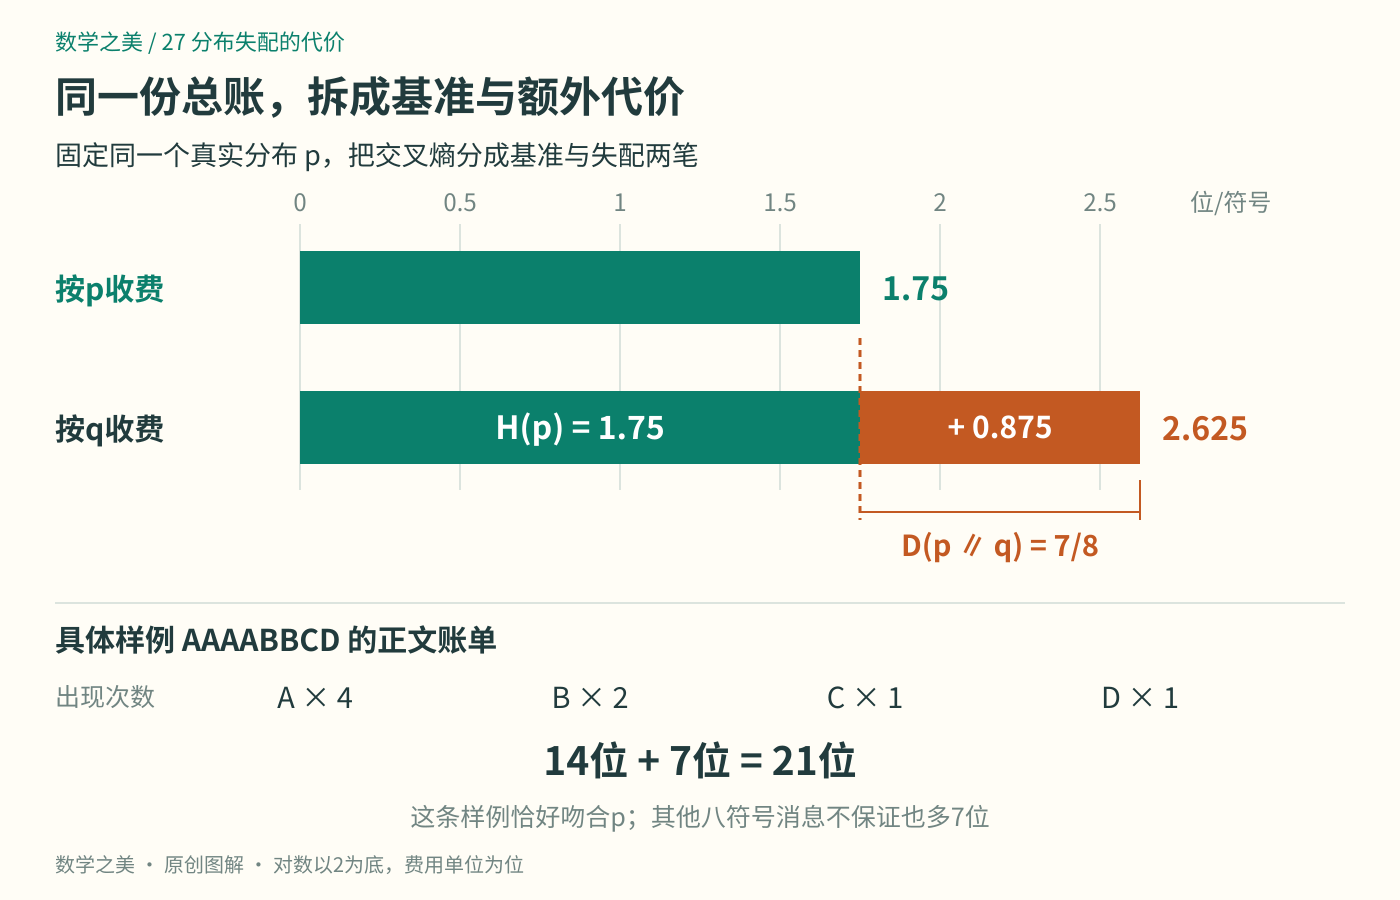
图2:绿色部分H(p)保持不变,橙色部分是D(p∥q)。这里两张码表都恰好实现各自的理想码长,所以分解能直接解释实际正文长度。
为什么平均不会越错越省
代数把差额命名了,还没有证明它一定非负。我们用上一章已经铺好的加权算术—几何平均不等式来完成这一步。
先假设所有pᵢ、qᵢ都为正,令aᵢ=qᵢ/pᵢ。以pᵢ为权重,权重之和为1,而且
Σᵢpᵢaᵢ=Σᵢqᵢ=1。
因此,加权几何平均不超过1:
∏ᵢ(qᵢ/pᵢ)^(pᵢ) ≤ 1。
取以2为底的对数,它保持大小关系,并把乘积变成和,得到Σᵢpᵢlog₂(qᵢ/pᵢ)≤0。乘以−1反向,正好就是
D(p∥q) ≥ 0。
若有些pᵢ为0,只在集合S={i:pᵢ>0}上做同样的运算。S叫p的支持集,意思是可能真正发生的符号集合。在S上,p的权重仍然加起来等于1,但
Σᵢ∈S pᵢ(qᵢ/pᵢ)=Σᵢ∈S qᵢ ≤ 1。
几何平均仍不超过1,结论保留。q若把一些概率分给S之外,就使这里的和小于1,并不会给证明制造漏洞。
何时恰好多付0?要让最终等号成立,上面两次不等式必须都取等号:S上的q概率总和须为1,而且qᵢ/pᵢ必须相同。这个共同值只能是1,所以S内qᵢ=pᵢ;S外则没有剩余概率,qᵢ也为0。反过来,p=q显然使D=0。因此
D(p∥q)=0,当且仅当p=q。1
这就解释了对数收费的一项好性质:在所有概率分布中,真实分布使期望费用唯一最小。若我们能用的模型范围不包含p,最优模型当然可能仍有正的失配代价。
这里的“概率分布”是不可省掉的限制。若把每个qᵢ都填成1,似乎每种结果的费用都变成0了,但多个1相加超过1,已经不是合法分布。提高一种结果的预测概率,就要从其他地方让出概率。证明正是借助这笔总量固定的预算,说明局部省下的费用不能凭空消除整体失配。
不能把不可能随便写进模型
如果某个pᵢ>0,而qᵢ=0,前面的有限费用假设就失效了。当qᵢ从正数越来越接近0,−log₂qᵢ会无限增大;把它严格设为0,就把该结果的对数损失记为正无穷。因此H(p,q)与D(p∥q)都为正无穷。1
这不是声称真实电脑会写出无限长的文件,而是说这种理想编码模型根本没有为该结果留下可用表示。真实系统需要转义码、后备方案,或重新分配概率;加入这些办法后,实际使用的模型和码长也随之改变。
尤其要区分“这个模型规定不可能”和“这批样本没见过”。后者不足以推出前者。把有限样本的零频数直接当作未来的零概率,可能让一次未见事件带来极大的损失。
有方向的代价,不是对称距离
D(p∥q)问的是“数据来自p,却用q解释”。交换两者之后,数据来源也交换了,因此一般不会得到相同答案。
为了看清差别,另取两个符号的分布r=(1/2,1/2)、s=(3/4,1/4)。直接计算:
D(r∥s)=(1/2)log₂(2/3)+(1/2)log₂2≈0.207519;
D(s∥r)=(3/4)log₂(3/2)+(1/4)log₂(1/2)≈0.188722。
两者都非负,却不相等。KL因此不能当作通常意义的对称距离。1
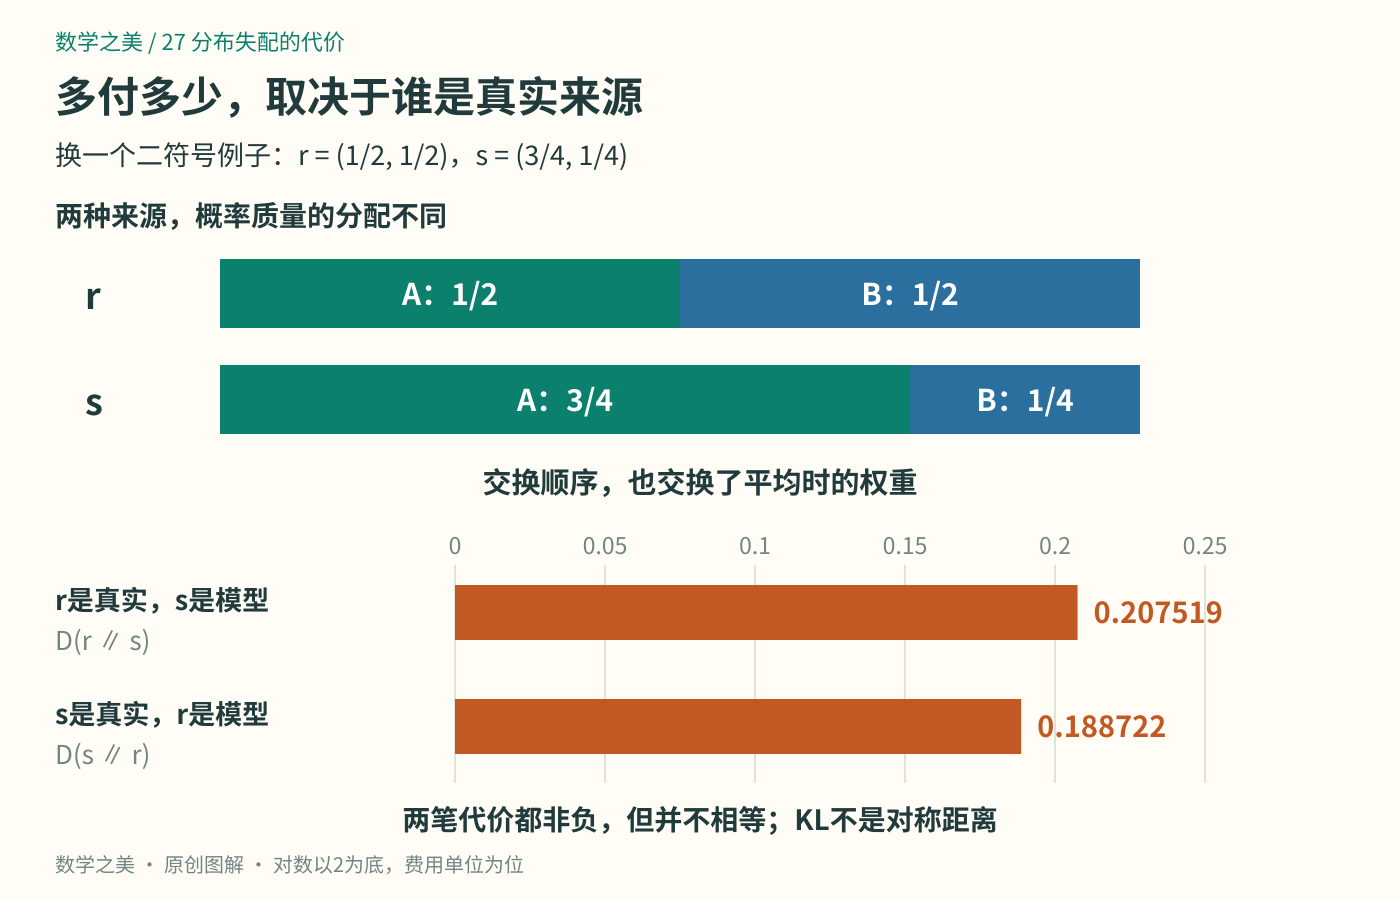
图3:交换模型与真实来源,会连平均时的权重一起交换。图中下方横条从同一零点出发,按同一尺度绘制。
从码表,回到概率预测
即使完全不生成比特串,也可以这样评价一次预测:结果i出现,就记录−log₂qᵢ。这叫对数损失;在真实分布p下,它的期望就是H(p,q)。刚才的证明说明,想长期降低这项期望,应该尽量准确地报告概率。2
例如二分类中,真实结果为A。两个模型都把A排第一,一个给A的概率是0.9,另一个是0.51。它们这次都“猜对了”,损失却分别约为0.152和0.971位。如果模型给A只有0.001,却仍遇到了A,损失约为9.966位。错误且极度自信,会受到很重的惩罚。
反过来,也不能只看一次结果就宣布某个概率准确。一个真正概率为0.9的事件,仍然有0.1的机会不发生。概率预测需要在恰当的样本与比较条件下评价,不能把每次未命中都当作概率模型被推翻。
例如明确设真实的二分类概率为0.9和0.1。照实报告时,期望损失约为0.469位;若把它夸大成0.99和0.01,期望损失反而约为0.677位。夸大模型在常见结果上每次省一点,却在少见结果上付得更多。所谓“鼓励准确的概率”,是把全部可能结果都结算后的结论,并不是鼓励每次都报一个更接近1的数字。
若固定q,并获得独立同分布、来自p的样本Y₁到Yₙ,样本平均损失是−(1/n)Σₜlog₂q(Yₜ)。在本章有限符号、支持内q为正的条件下,每项损失有限,可以用第22章的平均规律理解它对H(p,q)的估计。但训练数据既用于选择q,又用于报告低分,就不自动提供同样的未来保证。独立评估与分布变化仍要另查。
也可以把样本中各符号的实际比例记作经验分布p̂。无论抽样方式如何,上述样本平均都恰好等于H(p̂,q),这只是按出现次数整理求和。把它进一步用来说明真实期望H(p,q),才需要样本是否有代表性等依据。代数恒等式与统计判断在这里各有自己的职责。
对数损失有这些性质,也不代表它是所有任务唯一合适的损失。任务可能关心不同误判的实际成本;平方型概率评分等其他规则也有各自用途。2 我们得到的是一个具体问题的准确答案:固定真实分布,按对数收费,用错概率额外付出的理想平均代价,恰好是KL散度。
下一章还要进一步问:预测之前若知道额外线索,真实的不确定性本身能减少多少?那时需要分清“增加了信息”与“只是换了模型”。
顺手试一下
题目1:不偏不倚也有代价
真实分布仍为p=(1/2,1/4,1/8,1/8),预测模型改为u=(1/4,1/4,1/4,1/4)。求H(p,u)和D(p∥u)。使用固定两位码时,这次理想费用能否直接等于实际平均码长?
**提示:**四个−log₂uᵢ都相同,再减去H(p)。
**参考答案:**H(p,u)=2Σᵢpᵢ=2,D(p∥u)=2−7/4=1/4位。码字00、01、10、11每个恰好两位,因此实际平均正文码长就是2,没有取整余量;格式开销仍未计入。
题目2:没有发生的结果,能否忽略
另设r=(1,0),s=(1/2,1/2)。分别计算D(r∥s)与D(s∥r)。有人说:“r的第二项权重为0,所以双方的第二项都可以删掉。”这句话错在哪里?
**提示:**每个方向都重新检查哪个分布负责加权,哪个分布进入分母。
**参考答案:**D(r∥s)=log₂2=1位,第二项确实按r的零权重记0。反向时,第二种结果在s下有1/2的概率,r却给它概率0,因此D(s∥r)=+∞。不能把一个方向中可忽略的零权重,搬到另一个方向中继续忽略。
参考与延伸
1 Yury Polyanskiy、Yihong Wu,MIT 6.441 信息论讲义,§1.2、§2.1,第15—16、20页。核对KL定义、零概率约定、方向性和非负性;本文沿用上一章的加权均值不等式,独立展开有限情形的证明。
2 Tilmann Gneiting、Adrian E. Raftery,Strictly Proper Scoring Rules, Prediction, and Estimation,JASA 102(477),2007,§3例1—3及§8讨论。核对对数评分、KL联系、其他适当评分及极低预测概率的重罚。论文采用分数越大越好的符号约定,本文取负号写成损失越小越好,并统一使用以2为底的对数。
本章数据、练习与图解为本系列的独立教学编排。p、q和两张四符号码表与第24—28章共享,数值用于推导,不代表真实模型的评测结果。
作者:Jiancheng Wang · 数学之美(独立原创)