先修:17 最小二乘与投影;35 浮点表示;36 条件性;37 算法稳定性
第17章给三条虚构读数(0,1)、(1,2)、(2,2)找到了最佳直线:ŷ=x/2+7/6。今天让程序计算,它可能交回a=0.5000000000000002、b=1.1666666666666663。多出来的数字应当相信吗?若程序还报告残差平方和约为0.1667,是计算不够准确吗?
这两个疑问不能只靠增加显示位数解决。第36章区分了问题对数据的敏感程度,第37章区分了算法额外引入的误差。现在把它们接回同一个模型:先问数据能确定什么,再选择计算路径,最后用原问题独立检查结果。
先问数据能把参数钉得多牢
仍记X=[x u],u=(1,1,1),参数θ=(a,b),预测Xθ=ax+bu。原来的x=(0,1,2),三个位置彼此分开。另造一组教学数据,把位置挤到1附近:
x=(1,1+ε,1−ε),y=(1,2,0),ε=10⁻⁸。
这里先把这些数当作精确实数。第一条记录要求a+b=1;第二条减第一条,得到aε=1。因此a=1/ε=10⁸,b=1−1/ε;第三条也满足,精确残差为0。
可是,参数并没有因此变得可靠。把参数改成(a+t,b−t),三个预测只改变
X(t,−t)=(0,tε,−tε)。
t=1时,两个参数都改变了1,预测却只改变10⁻⁸。两列接近重合,使相反的参数改动几乎互相抵消;从输出反推参数就很敏感。这是第16章“相关列有零方向”的近似版本:这里没有真正的零方向,却有几乎看不见的方向。
再把间距ε改成1.01ε,保持y不变。只有两个输入各移动10⁻¹⁰,精确斜率却变成10⁸/1.01,约下降0.99%。若原始位置的不确定程度已经有10⁻¹⁰,就不能凭一次计算报出的长小数,把斜率承诺到十几位。增加计算精度也不能补回没有测准的输入。
单看参数很大,并不足以判定问题敏感;更换单位也能产生大数字。这里的根据是明确比较了输入改动与答案改动。谈“误差很大”时也要说清尺度:误差100对一个一亿的参数只是百万分之一的相对误差,却足以否定“绝对误差小于百万分之一”的承诺。
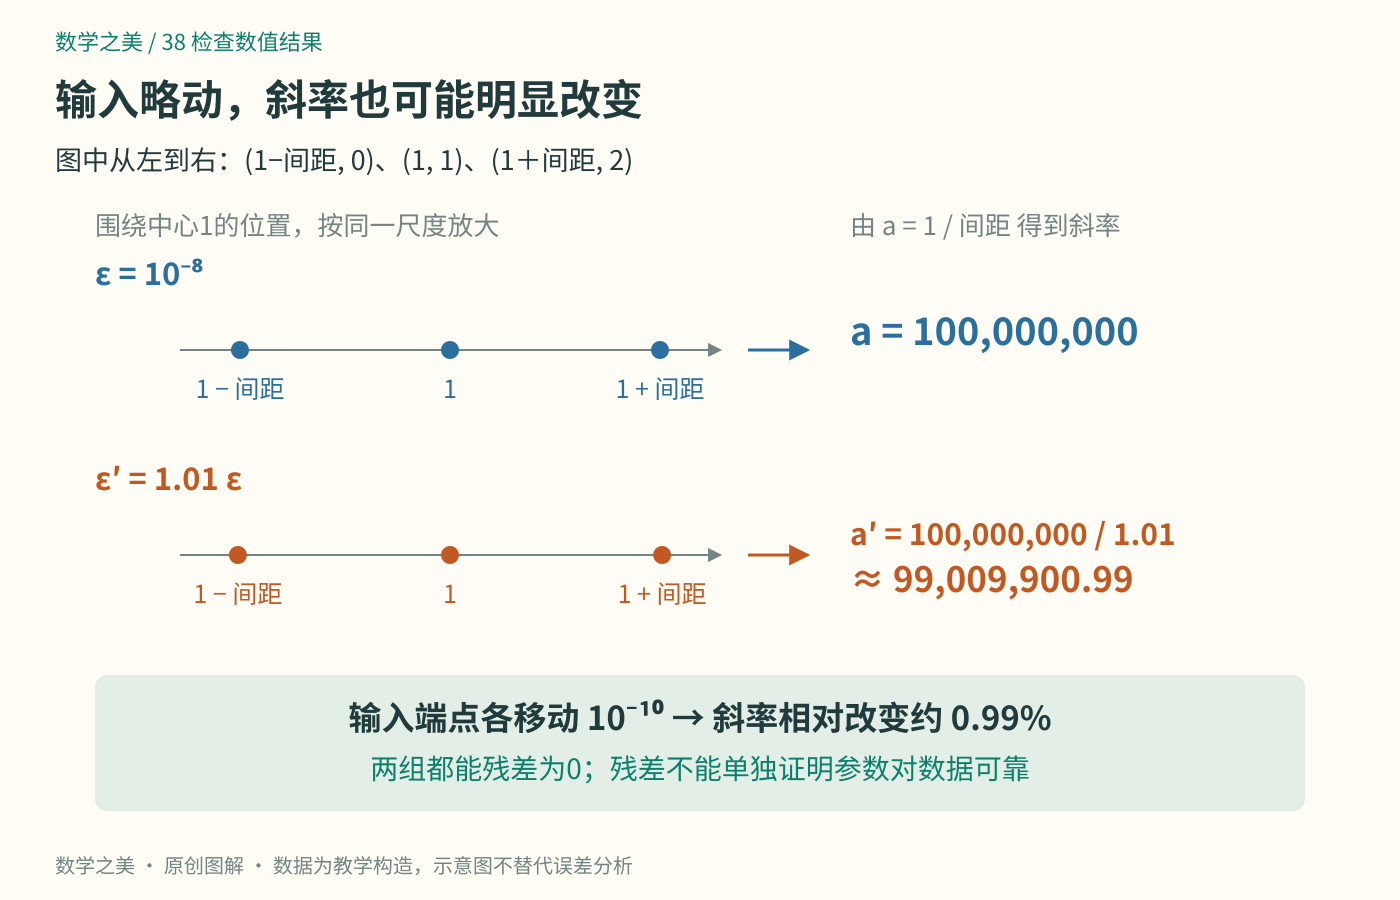
图1:两组数据各自都能被直线精确拟合。图中把相对中心1的微小间距放大展示;斜率变化由a=1/ε直接推出。
因此,“预测贴住这几个点”和“参数可信”是两件事。对于这个例子,靠近1的预测可能仍有用,远处的外推却可能剧烈变化。可靠程度还取决于我们最终要报告参数、局部预测,还是远处预测。
这种区分也能帮助我们改进采样。如果任务确实关心斜率,把三次测量都挤在几乎同一个位置,便很难看清“随位置变化”的效果。在允许的实验范围内增加位置的分散程度,可能比打印更多数字更有用。不过,扩大范围也可能暴露原直线模型的不足;改善参数辨识与检查模型是否适用,仍须一起进行。
再问计算路径有没有丢掉信息
第17章从正交条件得到XᵀXθ=Xᵀy。推导在实数中成立,却没有要求程序必须先形成XᵀX。
对刚才的近共线数据,精确的XᵀX两行是(3+2ε²,3)与(3,3)。区别藏在2ε²=2×10⁻¹⁶里。把它加到3附近,binary64可能已经留不住:原矩阵中还能分开的列,经过点积后可能被算成完全重合的行。随后再精确地解这个已改变的方程,也找不回丢掉的信息。
有没有沿着投影思想、直接处理原矩阵的路?回到原来的x=(0,1,2)、y=(1,2,2)。第17章不能把y分别投影到x与u再相加,是因为x·u=3,两条方向不正交。我们先在同一个平面里换两条互相垂直的单位方向。
先取q₁=x/√5。u沿q₁的投影是(u·q₁)q₁=3x/5,把它去掉,剩下
v=u−3x/5=(1,2/5,−1/5)。
它与x的点积为2/5−2/5=0,长度为√(6/5)。再除以长度,得到q₂=(5,2,−1)/√30。于是q₁、q₂彼此正交、各长1,而且仍张成原来的预测平面。
把它们排成Q=[q₁ q₂],原来的两列便能写成
x=√5 q₁,u=(3/√5)q₁+√(6/5)q₂。
这就是X=QR,其中R的第一行为(√5,3/√5),第二行为(0,√(6/5))。R记录旧方向在新方向下的坐标;左下角为0,所以它是上三角矩阵。
这里没有添加新的模型能力。新方向与旧方向张成同一个平面,每套原有预测仍能表示,平面外的观测也没有被悄悄搬进来。换坐标的作用是让两个方向互不干扰,方便把“找到最近预测”和“读回原参数”分成两个明确步骤。
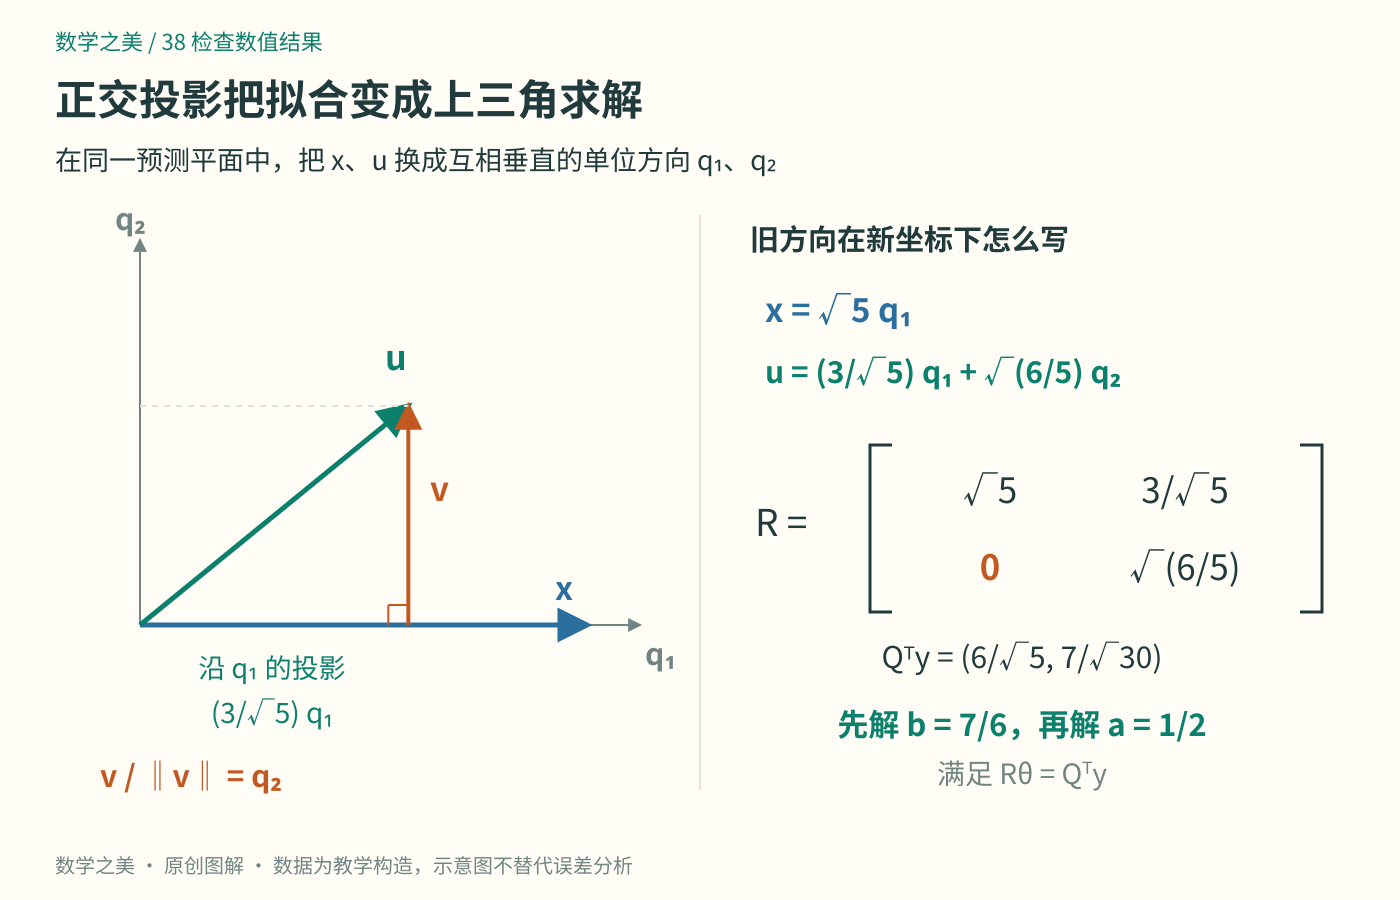
图2:左侧在原预测平面内画出方向,右侧记录坐标变换。这里的两个坐标轴是q₁、q₂,不是原始输入、输出轴。
新方向互不干扰,y的投影坐标可以分别计算:
c=Qᵀy=(6/√5,7/√30)。
为什么解Rθ=c就能完成拟合?令p=Qc。由于y−p垂直于Q的两列,而Q保持二维坐标向量的长度,我们有
‖y−QRθ‖²=‖y−p‖²+‖c−Rθ‖²。
第一项不随θ变化,第二项是非负数,令它为0就得到最小值。这个勾股分解,正是第17章证明在新坐标中的写法。
从上三角方程的第二行先解:√(6/5)b=7/√30,所以b=7/6;代回第一行得5a+3b=6,因而a=1/2。我们找到了同一个答案,却无需先计算XᵀX。[1]
这段手算用减投影说明QR的几何含义,不是推荐照抄朴素经典Gram–Schmidt作为稳健实现。有限精度中,它可能丢失列之间的正交性。成熟库采用经过分析的分解方法;例如LAPACK提供使用QR的最小二乘求解器,也提供其他适用于秩不足情况的求解器。[1][2] 数学分解、实现该分解的算法、调用哪个库接口,不能混为一谈。
用原问题检查程序交回的答案
下面直接调用NumPy的lstsq求最小二乘解,再从原始X、y重新计算残差。[3] 同一段代码也复跑近共线例;输出环境信息,便于比较。
import platform
import numpy as np

print(platform.python_version(), np.__version__, platform.machine())
np.set_printoptions(precision=17)
X = np.column_stack(([0., 1., 2.], np.ones(3)))
y = np.array([1., 2., 2.])
theta, _, rank, _ = np.linalg.lstsq(X, y, rcond=None)
r = y - X @ theta
print("theta, rank:", theta, rank)
print("SSE, XTr:", r @ r, X.T @ r)

eps = 1e-8
A = np.column_stack(([1., 1. + eps, 1. - eps], np.ones(3)))
z = np.array([1., 2., 0.])
print("Gram:", A.T @ A)
try:
    print("normal:", np.linalg.solve(A.T @ A, A.T @ z))
except np.linalg.LinAlgError as error:
    print(type(error).__name__, str(error))
t, _, rank, _ = np.linalg.lstsq(A, z, rcond=None)
print("lstsq, rank:", t, rank)
print("residual norm:", np.linalg.norm(z - A @ t))
本文在Linux x86_64、Python 3.12.14、NumPy 2.3.5的float64环境实际运行。原三点数据的输出为a=0.5000000000000002、b=1.1666666666666663,SSE=0.16666666666666674;Xᵀr两项约为−4.44×10⁻¹⁶与2.22×10⁻¹⁶。它们支持结果接近已知最优解,不要求逐位等于0。
SSE没有接近0,恰恰符合数学结论。精确最优解的残差是r*=(−1/6,1/3,−1/6),SSE=1/6。它是选定直线模型对这三条记录的拟合残差;可能涉及读数波动、取整或模型限制,不能全部记到机器舍入的账上。
设程序参数与精确最优参数相差Δθ。如果暂用精确算术重新代回,那么
y−X(θ*+Δθ)=r*−XΔθ,
SSE(θ*+Δθ)=1/6+‖XΔθ‖²。
r*是原问题已经留下的差,XΔθ是参数计算偏差造成的预测位移。程序实际计算残差与平方和时还会舍入,所以这条精确恒等式是解释和核对的依据,不是浮点输出必须逐位满足的断言。
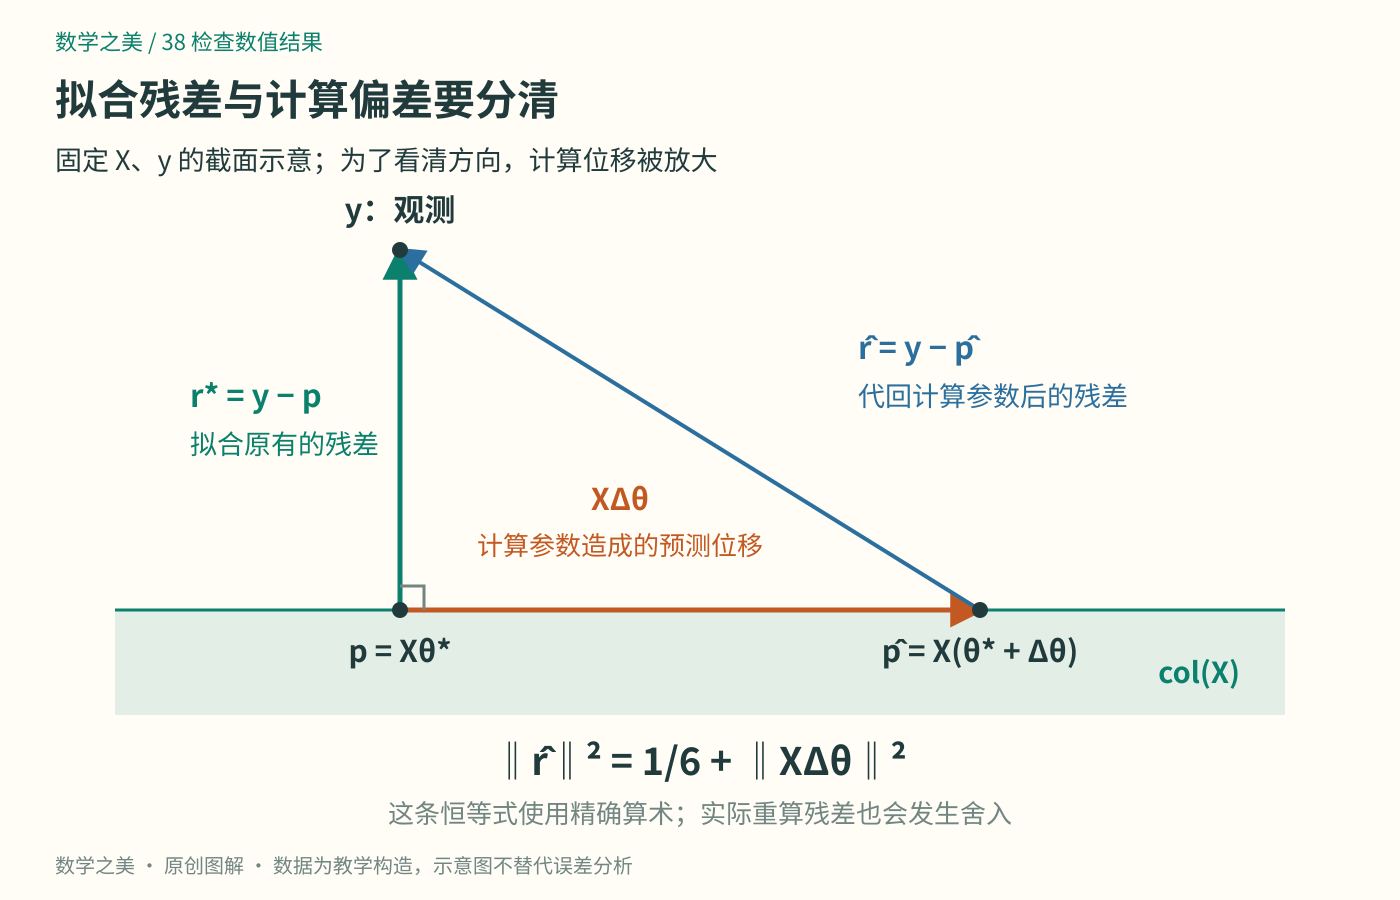
图3:对固定X、y,最优预测与计算预测都在列空间中。图中为了看清方向放大了计算位移;它不表示本次误差的真实比例。
检查Xᵀr是在问:残差是否还明显指向模型能调整的方向?它接近0支持最优性;要求r本身接近0,却可能是在要求模型完成不可能的拟合。即使前者通过,也尚未证明参数对输入可靠。
独立检查还要保留原来的问题。若只把算出的参数代回已经形成的Gram矩阵,所检查的是那组经过舍入的新方程;形成矩阵时丢掉的区别可能被一起掩盖。重新用原X计算预测和残差,至少让这一步没有重复依赖同一个中间结果。它仍在浮点环境里进行,不能当成精确证明;本例还有手算分数可作另一条核验路径。
近共线例把这一点显出来:本次运行得到全3的Gram矩阵,正规方程求解报“Singular matrix”;lstsq仍判定数值秩为2,得到a约100000000.58、b约−99999999.58,重新计算的残差范数约2.13×10⁻⁸。小残差与很大的参数可以同时出现,且参数仍承受前面证明的输入敏感性。
这些末位和报错是本环境的观察,不保证各平台完全一致。尤其1±10⁻⁸在输入时已转换成浮点数,程序实际处理的数据与纸上的精确十进制数据略有区别;不能把两者参数之差全部归因于求解器。这次实验展示一种可能的失败路径,普遍性的理由来自前面的精确推导。
库返回的rank也需要这样读:它是按数值阈值作出的判断,不是测量仪器精度的报告。默认阈值与机器精度和矩阵大小有关;判为满秩,并不表示现实数据已经足以精确确定参数。[3] 同样,前面的平方和恒等式限制的是预测位移XΔθ;如果X能把较大的参数变化压成很小的预测变化,它就不能单独给出强的参数误差保证。
可信到几位要落实到误差范围
对原三点模型,可以亲手算出一份输入误差预算。假定输入位置0、1、2厘米精确不变;输入、输出都按厘米取数值,每个输出误差的数值绝对值不超过h。将输出数值写成任意的(y₁,y₂,y₃),由同一组正规方程消元可得
a=(y₃−y₁)/2,b=(5y₁+2y₂−y₃)/6。
若输出分别改变e₁、e₂、e₃,且每个|eᵢ|≤h,由三角不等式得到
|Δa|≤h,|Δb|≤4h/3。
例如每个输出允许误差为0.01厘米,即h=0.01,那么斜率的不确定范围至多为0.50±0.01,截距至多为(7/6±0.01334)厘米。这是对所有允许输出改动的上界,不是只试几个随机扰动后的印象。它说明输入只测到这个程度时,打印十几位没有对应的证据。若输入位置本身也不确定,还要分析它们的影响,不能沿用这份只允许输出变化的预算。
这些范围描述的是:在允许的数据变化下,每次重新求出的最佳拟合参数可能在哪里。它们既不是未来读数必落入的区间,也不是对现实中某条“真正直线”的证明。第34章关于模型选择和新数据检验的问题,仍然存在。
若确实需要承诺四舍五入后的某一位,可以先建立可信的误差区间,再检查区间内所有值是否都会舍入成同一个结果。只看计算值离某个整齐小数很近是不够的,特别是在舍入边界附近。误差区间必须有来源,显示格式不会自动产生它。
检查的尺度也必须跟着问题走。原例输出以厘米计;若只把输出改记为毫米,y与残差扩大10倍,SSE扩大100倍,而模型的贴合程度没有因此变坏。Xᵀr各分量还受相应列的尺度影响,所以不能给所有数据统一规定“低于10⁻⁶就合格”。
对非零残差,可把每个点积与‖X的第j列‖‖r‖比较,得到无量纲的正交偏离;残差极小时,这种比例本身可能受舍入支配,还须考虑原数据、计算中间量的尺度与累加误差。容差来自这些分析和应用允许的误差,而不是屏幕小数点后有几位。
若要承诺某一位可靠,最终需要约束答案可能偏离多少。输入误差经条件性放大后的影响,与算法的计算误差,都要计入;靠近0的结果尤其应说明绝对误差。重新测量、改变合理范围内的数据,能检验前一部分;提高精度或换成熟求解路径,主要检验后一部分。一次成功的残差检查不能代替它们。
因此本章没有一个适用于所有数值结果的位数答案。对精确给定的三点教学题,分数答案和独立代回提供了强核验;对有限精度的真实读数,可信位数还受输入精度与条件性约束。数值计算做的是把这些边界交代清楚。下一章再问更根本的问题:如果允许足够时间,是否所有程序行为都能由另一段程序事先判断?
顺手试一下
题目1: 原三点拟合中,一个程序返回(a,b)=(1/2,7/6+1/100)。在精确算术下,求残差、Xᵀr与SSE。它的残差和很小,是否就已经最优?
**提示:**三个预测同时上移1/100;利用r*分别与x、u正交。
**参考答案:**残差为(−53/300,97/300,−53/300)。Xᵀr=(−3/100,−3/100),所以仍能通过整体下移改进,并非最优。SSE=1/6+3×(1/100)²=5009/30000。拟合本来就有非零残差;这里判断未到最优的依据,是残差还含有可行方向分量,而不是SSE没有降到0。
题目2: 对x=(1,1+ε,1−ε)、y=(1,2,0),把输出改为y′=(1,2+δ,−δ),输入保持不变。求新的精确参数与参数变化。ε=10⁻⁸、δ=10⁻⁶时,若新程序得到残差0,能据此说原参数可靠到小数点后六位吗?
**提示:**第一条记录仍给出a+b=1;第二条与第一条相减。
**参考答案:**新参数a′=(1+δ)/ε,b′=1−(1+δ)/ε,第三条也精确满足。因此Δa=δ/ε=100、Δb=−100。两个输出只变动10⁻⁶,参数却改变100;残差0只说明拟合了改变后的数据,不能保证原参数的绝对精度。是否可靠还要结合允许的数据误差和所关心的输出,显示六位小数没有提供这种保证。
参考与延伸
[1] David Bindel,康奈尔大学CS 6210课程讲义,Householder, Givens, and QR factorization,2025年9月29日。核对QR最小二乘分解、经典Gram–Schmidt的正交性问题与成熟正交分解算法的区别。
[2] LAPACK Users’ Guide,Linear Least Squares Problems。核对满秩求解器使用QR或LQ,以及针对可能秩不足问题的其他求解器;本文未把所有库接口说成同一种算法。
[3] NumPy官方文档,numpy.linalg.lstsq。核对最小二乘目标、返回值和数值秩阈值语义。本文保留完整复跑代码;具体实验版本为NumPy 2.3.5,文档的stable页面会随版本更新。
本章三幅图均为原创。近共线数据为专门构造的教学例,不是实际测量记录。
作者:Jiancheng Wang · 数学之美(独立原创)