先修:07 二进制串与乘法计数;08 鸽巢原理;09 二叉树与信息容量
把一个文件压缩一次,体积小了。如果再压缩一次,还能更小吗?倘若每次都能少一点,反复运行,最后是不是只用一个比特,就能保存一整座图书馆?
问题的关键是“每次都能”。从这一章起,我们研究信息怎样表示、怎样节省,以及节省的界限。先不用复杂算法:数清短串有多少,就足以否定一种过强的承诺;再给四个符号安排编号,就能看见实际压缩为何仍然有用。
先把“原样恢复”写清楚
把文件内容看成一个有限二进制串,也就是由有限个0、1依次排成的序列。一个二进制位叫一个比特,英文记作bit。00101有5位;前面的两个0也属于内容,不能像写整数那样随手删去。没有任何位的串叫空串,长度为0。
用s代表原串,E代表编码规则,D代表解码规则。E(s)是编码后的完整输出;D(E(s))表示再把它交给解码器。无损要求是:对每个允许的输入s,都有
D(E(s))=s。
这里的等号要求每一位完全相同。有损压缩则允许在规定的误差标准内改变内容,例如舍弃部分图像细节;它没有承诺这个等式,因此不能拿来反驳下面的结论。
等式马上带来一个限制:不同原串必须有不同编码。这种性质叫单射。证明很短:如果s与t不同,却有E(s)=E(t),同一个解码器收到同一输出,只能给出同一结果,不可能同时恢复s和t。于是无损要求不成立。1
这也接上了第08章的摘要碰撞:两个文件有同一个摘要,尚可接受它们“同号”;两个文件有同一个完整压缩表示,却无法都原样恢复。要保留的区别不同,对编码的要求也不同。
短串的座位已经数得出来
现在固定一个正整数n,问:能否把所有长度恰为n的串,都无损编码成少于n位?
按第07章的计数,n个位置各有两个选择,共有2ⁿ种输入。输出允许长短不一;我们甚至把空串也算作一个可用位置,尽量给压缩器宽松条件。
长度为0的串有1种,为1的有2种,为2的有4种,直到长度n−1的有2ⁿ⁻¹种。不同长度的串彼此不同,所以可用输出总数为:
1+2+4+…+2ⁿ⁻¹=2ⁿ−1。
为什么正好少1?把左边总和记作S,乘2得到2S=2+4+…+2ⁿ。两式相减,中间项抵消,剩下S=2ⁿ−1。
输入有2ⁿ种,短输出只有2ⁿ−1种。若每个输入都分到一个短输出,鸽巢原理说明至少两种输入同号,与单射矛盾。因此,任何固定的无损编码,都不可能让所有n位输入严格变短。
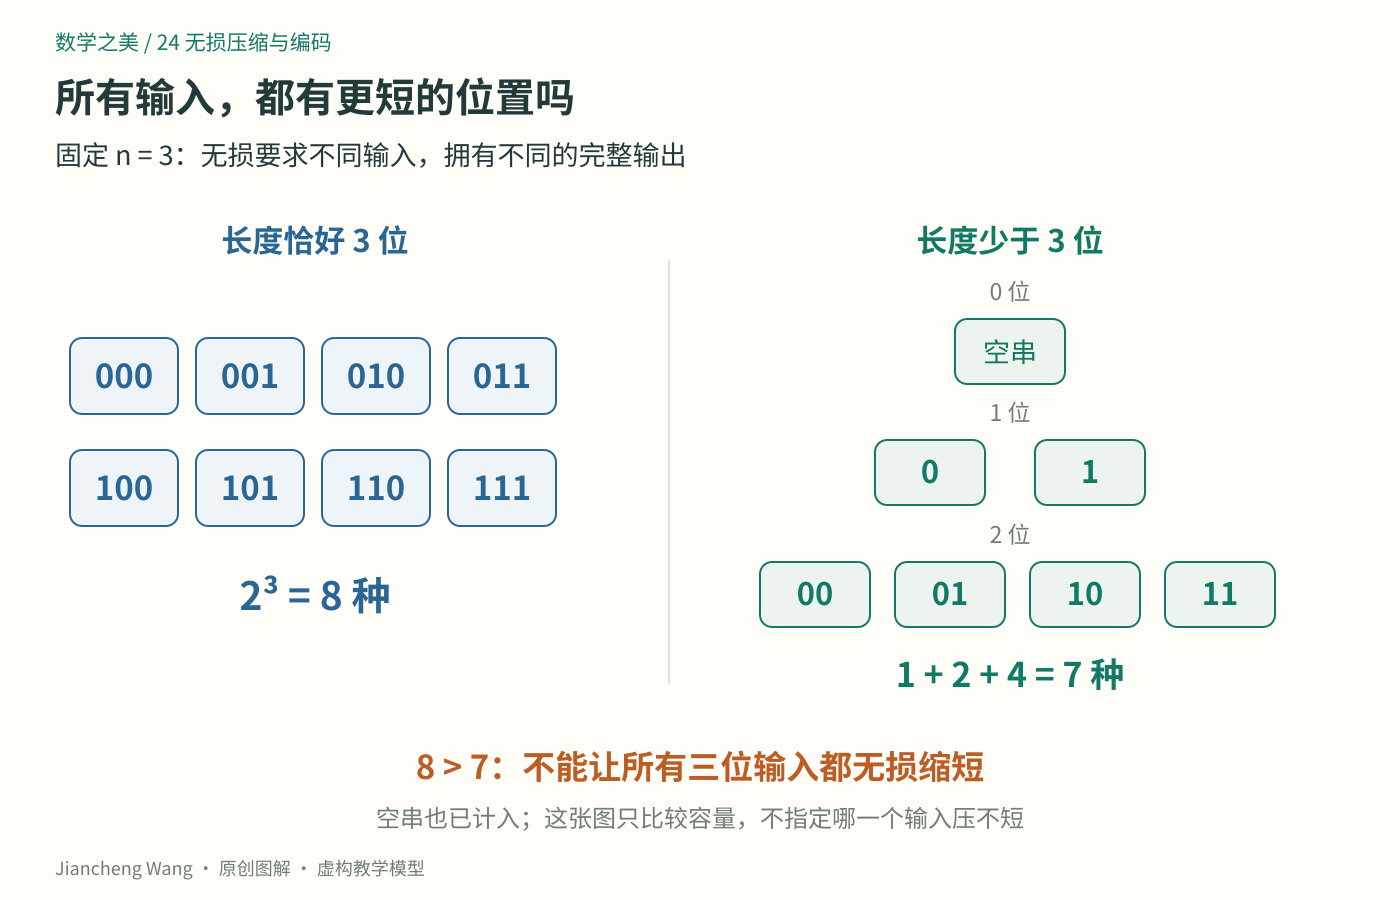
图1:n=3时,三位串有8种;零位、一位、两位串合起来只有1+2+4=7种。这是输出容量比较,没有指定某种压缩算法。
第09章数决策树叶子时,没有把所有深度的节点相加;这里为什么能加?因为此处先允许把任何完整短串当作独立输出,连“输出已结束”也视为可识别。这给出了最宽松的候选集合。实际格式若还要花位数表示结束位置,可用容量只会更受限制,不会因此多出一个座位。
证明没有断言每个文件压缩都无效,也没有点名哪一个文件一定压不短。它约束的是一套固定规则面对全部输入时的保证。即使某种方法对常见文件非常有效,也必须保留不能缩短的情形。2
把信息藏到旁边,不算省掉
有人提出:先把所有文件编成一本字典,每个文件只保存一个短编号。读取时查字典,不就恢复了吗?
字典若是双方预先共有、固定不变的规则,当然可以使用;但编号仍须区分字典里的候选。若允许为每个文件另做一本字典,再都编号为0,那么解码器必须知道“用哪本字典”。变化的字典、选择编号或其他必要信息,都属于恢复这次输入所需的信息,不能一边依赖它们,一边从总开销里删除。
所以本章的完整输出,包含在固定公共约定之外,为这次解码必须提供的全部数据。码表、原文长度、方法标记、文件边界,凡是确实需要传递的,都要算。码表若能由双方用同一规则从已解出的内容重建,就无需原样再发一份;需要的是交代恢复依据,而非机械地给每张表收费。
多轮压缩也要接受同样检查。有限次可逆步骤合起来,仍是一套无损编码;如果还要记录压了几轮、用了什么方法,这些记录也在账上。把完整输出的长度记成一个非负整数,每次严格减少,当然不可能无限进行。若最后许多原文件都落到同一个短结果,又没有额外信息区分,原样恢复就已经丢了。
给常见符号安排短位置
不能保证全部缩短,为什么还值得设计压缩?因为实际要处理的内容往往有偏重,我们可以让常出现的模式享用较短表示。
从这里起,改用一个虚构的四符号来源,只写A、B、C、D。为安排码长,先采用一组预设的出现比例p=(1/2,1/4,1/8,1/8)。p中的四个数依次对应A、B、C、D,加起来为1;它们不是对任何真实文本的测量,也不要求每八个符号恰好按这个比例出现。
最直观的表示是固定长度码,每个符号占2位。另一种安排让A较短,让C、D较长。一个符号对应的那段二进制串,叫作它的代码字;把对应关系列起来,就是码表。
| 符号 | 预设出现比例 | 固定长度码 | 新代码字 | 新码长 |
|---|---|---|---|---|
| A | 1/2 | 00 | 0 | 1位 |
| B | 1/4 | 01 | 10 | 2位 |
| C | 1/8 | 10 | 110 | 3位 |
| D | 1/8 | 11 | 111 | 3位 |
取一条具体消息AAAABBCD。固定码的正文是:
00|00|00|00|01|01|10|11,共16位。
新码的正文是:
0|0|0|0|10|10|110|111,共14位。
去掉为了阅读加上的分隔线,实际比特串为00001010110111。四个A共省4位,两个B没有变化,C、D各多用1位,总共省2位。这条消息每符号实际平均占14/8=1.75位。这里没有计算整个来源的期望,也还没证明这张码表最优。
若消息换成DDDD,新码就用12位,固定码只用8位。短位置给了A,自然会有人付出更长的表示。常见符号用短码、少见符号用长码,是可变长度编码的一种基本思路。3
没有分隔线,怎样找到下一个符号
刚才的14位里没有保存“|”。接收方凭什么知道第一个0是完整的A,而不是某个长代码字的开头?
关键在码表的结构。一个串的前缀,是从它最前面连续取出的一段。例如11是110的前缀。若码表中没有任何一个代码字是另一个代码字的前缀,就叫前缀码。
0、10、110、111满足这个条件:0之后不再延伸出其他代码字,10之后也没有;110和111长度相同且互不相同。把0、1分别画成二叉树的分支,四个符号都放在叶子上。
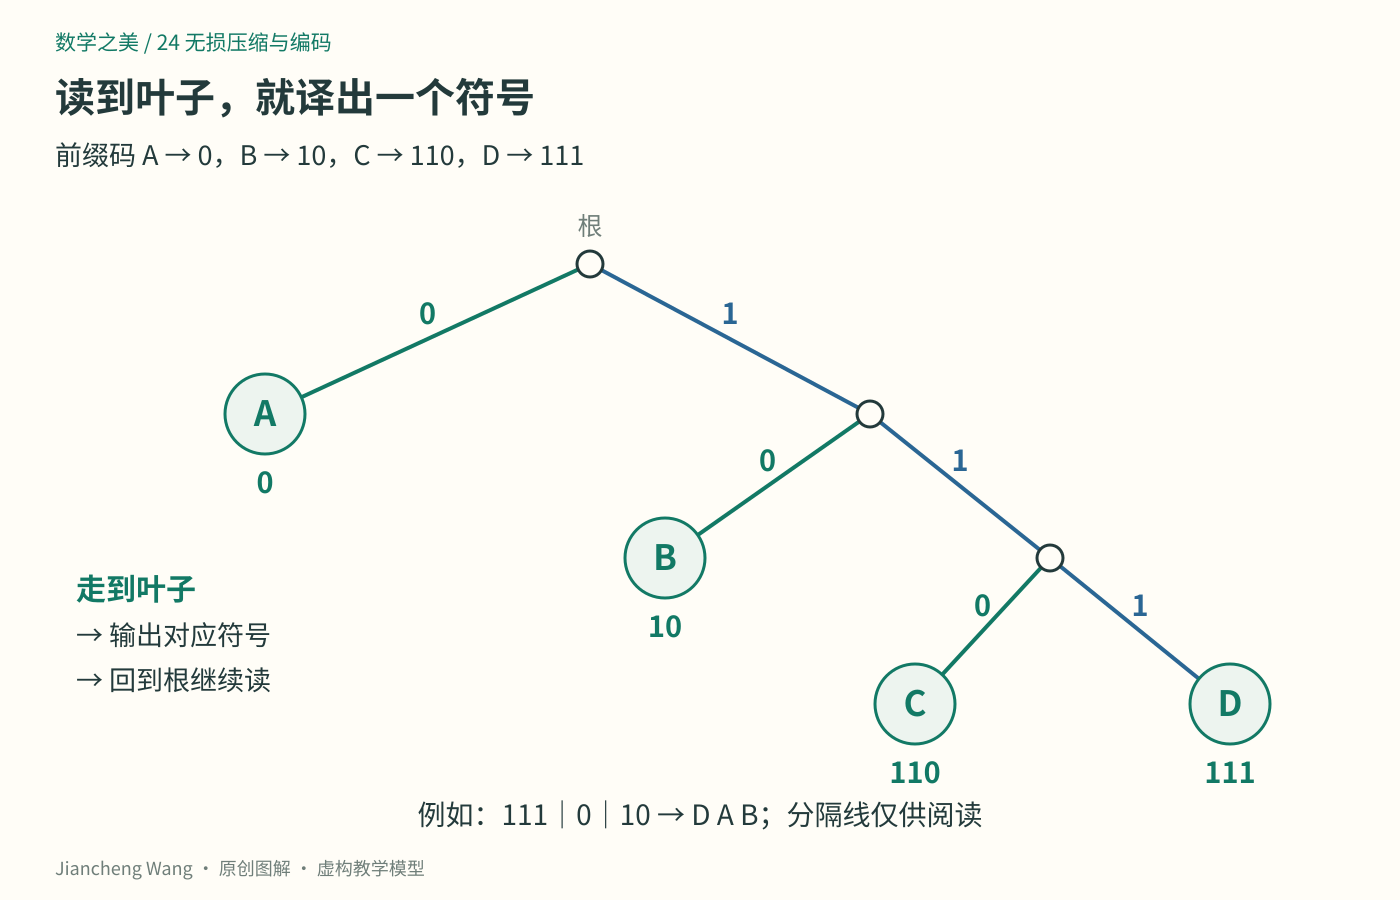
图2:读111时,依次沿1、1、1到D,输出D后回到根。每个代码字的结尾都在叶子上,不会同时成为另一个代码字的中途。
解码时从根出发,每读一位走一条边;走到叶子就输出对应符号,返回根继续。对00001010110111,前四个0各到一次A,接着两次10到B,最后110到C、111到D。
为什么不会存在第二种合法切法?假设两种切法的第一个代码字不同,它们都从同一比特串开头出发,较短的那个必是较长的前缀,违反定义。因此第一个符号只能相同;删去相同的第一段,对剩余部分重复这一步,整条有限消息的切分便唯一。
试试另一张表:A用0,B用01,C用10,D用1。每个单独的编号都不同,拼接却出了问题:01既可能表示B,也可能表示AD。可见单个符号不同号,还不足以保证任意消息拼接后不同号。
不过,不能把这个反例扩大成“非前缀码都无法唯一译回”。有些非前缀码仍可唯一译回,只是可能需要等后续位或读到消息结尾。本章用前缀条件,是因为它提供一个容易检验、能够即时逐符号解码的充分条件。1
符号边界解决了,整条消息的结束仍要约定。接收方要知道有效比特在哪里结束,或者原文有多少符号,或者识别专门的结束标记。例如把14位补0凑成两个字节,若不说明最后两个0只是填充,按这张码表就会多读出两个A。
正文省了两位,文件未必变小
实际文件可能还要记录码表和有效长度。设这些附加数据总共占h位,h只表示本例所需开销,尚未指定某个真实格式。那么14位正文加上这些数据,占14+h位;固定码方案若也有附加开销,则要与它的完整长度比较。
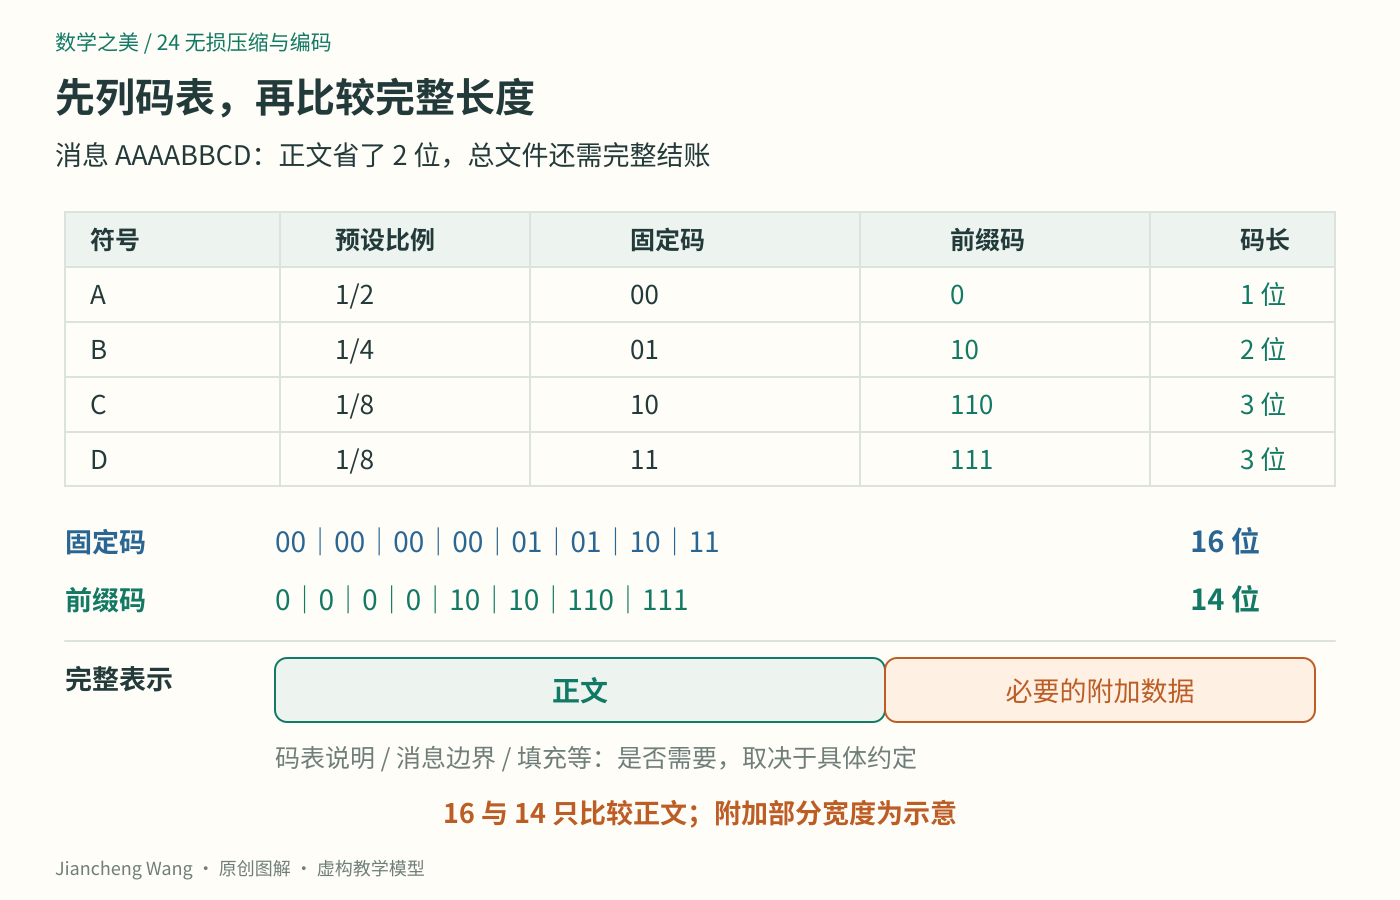
图3:上方列全两套码表,下方的16与14只比较正文。附加部分宽度是示意,不代表真实格式的固定费用。
短消息只省2位,额外说明很容易抵消这点收益;同一张码表供许多消息共用时,说明费用又可能分摊。究竟省多少,需要明确比较对象与共享条件。DEFLATE的格式规范也分别规定编码树、数据块和结束信息,工程实现不能只保留“看起来变短”的那一段。2
在AI文本处理中,同样可以问:把一段文字改写为一串编号之后,编号怎样存储,词表是否已经共享,能否逐字恢复?这些问题不由“编号数量更少”自动回答。若只保留概括性的摘要,追求的恢复目标也已经变了。
本章得到两件可以直接检查的事:完整无损表示必须保留所有原有区别;安排长短代码字时,还得保证接收方能找到边界。接下来才轮到更精细的问题:出现比例究竟该怎样影响码长?平均还能压到多短?第25章会先从“排除了多少可能”出发,重新认识对数。
顺手试一下
题目1:至少少两位的承诺
一种固定的无损编码接受全部8位串。最多能有多少种输入被编码成不超过6位?能否保证全部输入都至少少两位?输出允许空串,并已包含必要的附加信息。
**提示:**把长度0到6的输出都数进来,再与8位输入总数比较。
**参考答案:**可用短输出有1+2+4+…+64=127种,8位输入有256种。单射要求每种输入独占一个输出,因此至多127种能缩到不超过6位,至少129种做不到,不能作出普遍保证。这个上限只作容量约束,并未说明某个实际格式能用满127个位置。
题目2:先译回,再结账
使用本章前缀码,011011110表示什么消息?正文比固定2位码少几位?某教学封装在两种方案中都用相同的边界说明,但可变码额外需要3位码表选择标记;忽略字节填充,此时完整表示还更短吗?
**提示:**每到一个叶子就回到根;比较总长时,共有费用可以抵消。
**参考答案:**唯一切分为0|110|111|10,译回ACDB,共9位。固定码为00|10|11|01,共8位,因此可变码正文已多1位;再加额外3位,完整表示比固定码多4位。前缀条件保证可恢复,不保证每条消息都节省空间。
参考与延伸
1 MIT 6.441,Yury Polyanskiy,第6章 Variable-Length Lossless Compression,§6.1、§6.2:无损与单射、唯一可译码与前缀码的区别。后面的熵界不在本章使用。
2 P. Deutsch,RFC 1951:DEFLATE Compressed Data Format Specification version 1.3,§1.1、§2、§3.2.1、§3.2.3:计数限制、前缀解码树与完整格式中的控制信息。本文没有用其历史压缩率描述作性能承诺。
3 MIT 6.02,Lecture 22:Source Coding: Lossless Compression,§22.1:固定长度与可变长度编码的取舍。
本文采用常见的四符号前缀码结构,样例消息、练习和图解由本系列独立编排;后续章节沿用同一组虚构教学数据,不把它当作真实文件格式或压缩效果评测。
作者:Jiancheng Wang · 数学之美(独立原创)