先修:30 导数与局部直线;35 浮点表示与舍入;36 问题的条件性;平方差公式
同一个输入、同一个数学函数,只改一下公式的写法,答案会从0变成约0.000000005。这不是把一道题换成另一道题,而是有限位数的计算过程发生了变化。
本章研究一个简单函数:
f(x)=√(x+1)−√x,x≥0。
两个根号下的数只差1;x越大,开方后的差越小。直接写出“先开两次方,再相减”,很自然,却未必是可靠的计算安排。第35章解释了每一步怎样落到有限格点,第36章区分了问题自身的敏感程度。现在把镜头移到两者之间:算法怎样把已有的信息带到答案里?
等号两边,安排了不同的工作
令a=√(x+1)、b=√x。利用平方差公式,
(a−b)(a+b)=a²−b²=(x+1)−x=1。
因为x≥0,所以a≥1、b≥0,a+b始终为正。两边除以它,得到
f(x)=1/[√(x+1)+√x]。
这一步叫有理化,使用了与a−b配对的a+b。它对本章整个定义域成立,包含x=0;没有使用“大数时差不多相等”的近似。
但两种写法要求机器做的事不同。直接式先算两个接近的大数,再取差;有理化式把它们相加,最后用原问题中已知的1去除。数学函数没有变,途中要保存的量和舍入的位置变了。
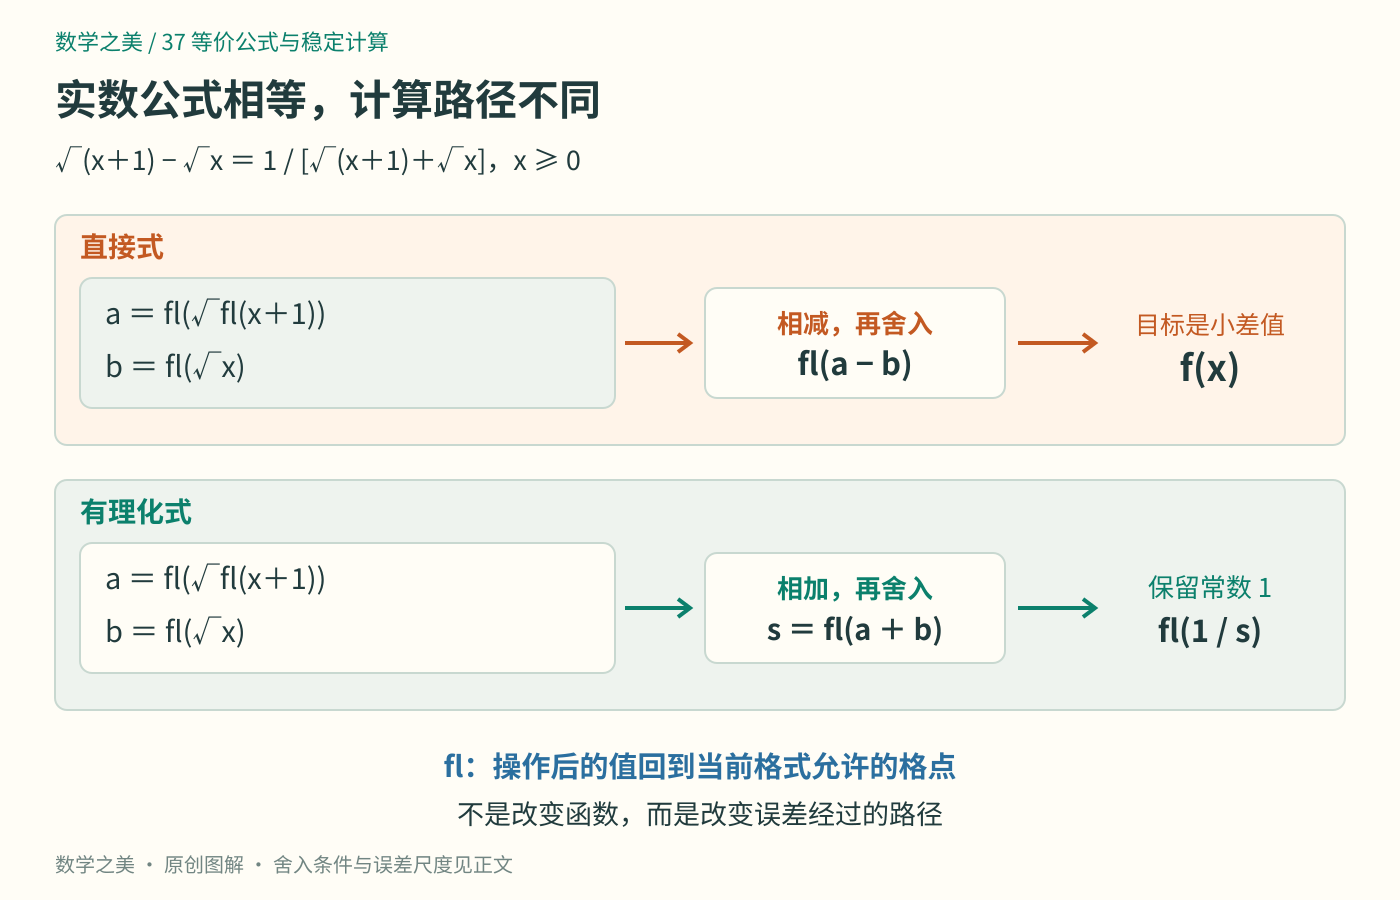
图1:fl表示一次操作后舍入回当前浮点格式。等价的是实数公式;带有fl的计算路径不能仅凭代数等号认定逐位相同。
代数课常把“化简”理解为写得短,数值计算还要问:这个写法会让微小的信息与多大的量挤在一起?长度不是唯一标准,运算次数也不是准确度的保证。
先让实验把差异摆出来
下面的实验固定输入x=10¹⁶。这个整数本身可以被本次使用的二进制浮点格式精确保存,因此先不混入测量误差或输入转换误差。
import math
import sys
from decimal import Decimal, localcontext

x = 1e16
values = {
    "direct": math.sqrt(x + 1) - math.sqrt(x),
    "rationalized": 1 / (math.sqrt(x + 1) + math.sqrt(x)),
}
print(sys.version.split()[0])
print(sys.float_info.radix, sys.float_info.mant_dig)
print(math.ulp(x), x + 1 == x)

with localcontext() as ctx:
    ctx.prec = 80
    X = Decimal("10000000000000000")
    ref = 1 / ((X + 1).sqrt() + X.sqrt())
    for name, value in values.items():
        actual = Decimal.from_float(value)
        relative_error = abs(actual - ref) / abs(ref)
        print(name, repr(value), f"{relative_error:.6E}")
本章独立运行得到:Python 3.12.14,底数2,有效精度53位;math.ulp(x)为2.0,x+1与x的浮点比较为True。最后两行是:
direct 0.0 1.000000E+0
rationalized 5e-09 4.592256E-17
高精度参考值约为
4.99999999999999987500000000000000625 × 10⁻⁹。
相对误差的定义是|计算值−真值|/|真值|。这里用80位十进制计算作参考估计,又把精度提高到120位,并用高精度的直接差式交叉复核,上述展示位保持一致。它不是宣称参考计算拥有无限位数,而是让参考误差远小于正在比较的差异。
构造X时从字符串开始,保留指定的十进制整数;检查输出时,反而特意用Decimal.from_float读出float实际保存的值。[2] 若把显示文本“5e−09”直接当作精确的5×10⁻⁹,就会漏掉输出自身的二进制表示误差。直接式的相对误差为1,即100%;有理化式约为4.59×10⁻¹⁷。
这是一组明确环境、明确输入下的可重复实验,不是“所有机器、所有公式都如此”的证明。解释还得回到中间步骤。
那个1究竟丢在哪里
10¹⁶位于[2⁵³,2⁵⁴)内。第35章的格点间距公式告诉我们:53个有效二进制位在这里相邻间隔为2。x、x+2能保存,精确的x+1却恰在中点。
按最近舍入、中点取偶的规则,这次相加被舍回x。这里“取偶”指有效整数的末位:x/2=5×10¹⁵为偶数,因此选择x对应的格点。程序还没开方,原本根号下相差1的两个数就已经相同了。
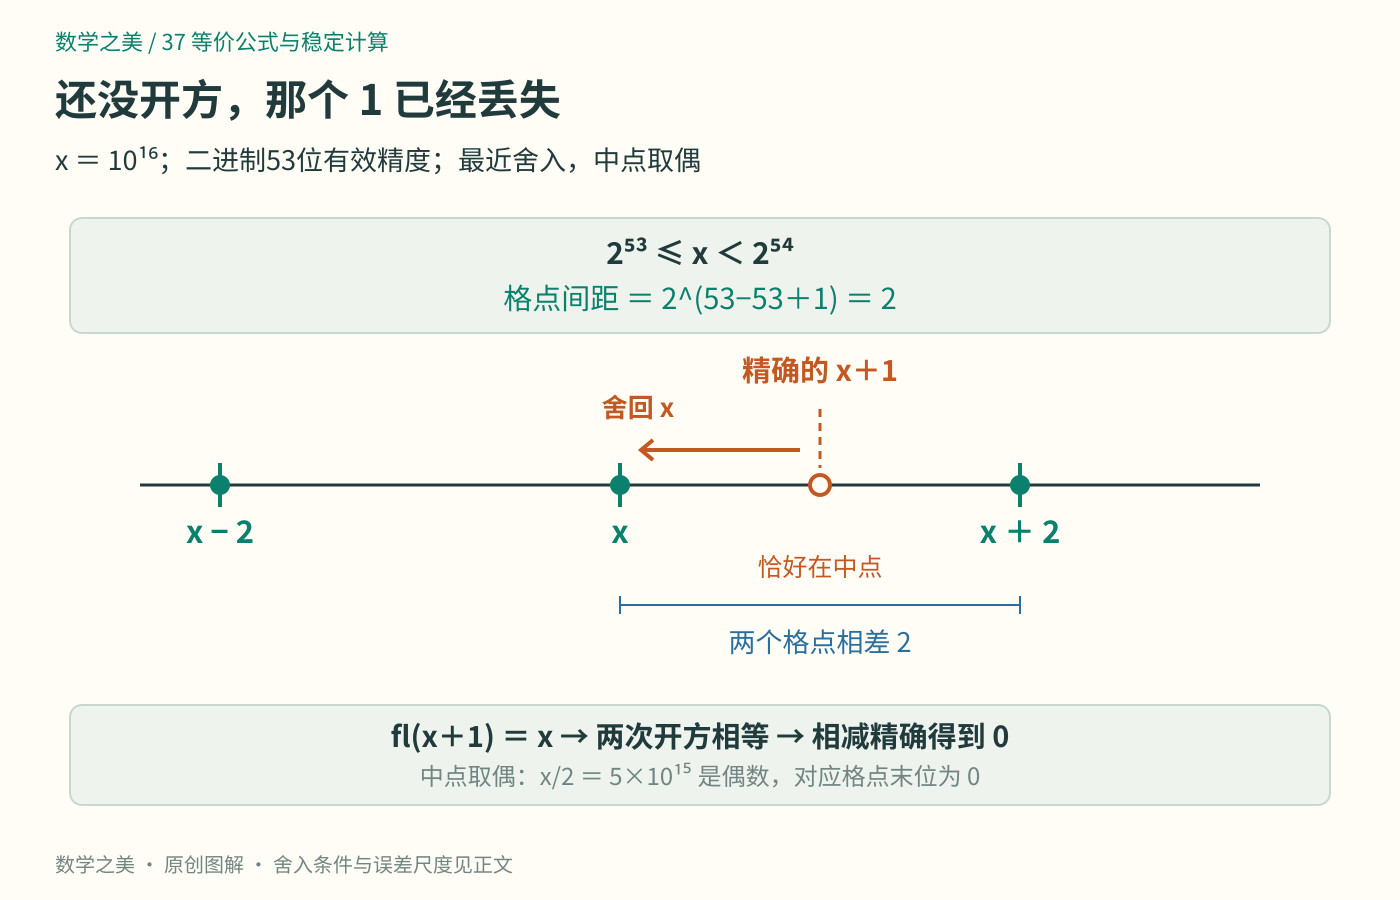
图2:这是输入附近真实的格点间距,横轴标签以x为基准。math.ulp与math.nextafter可分别检查间距和下一个格点。[3]
于是直接式实际执行的是√x−√x,两个开方结果都是10⁸,最后得到0。特别要注意:这次最后的减法完全精确。错误不是它把两个不同的存储值减错了,而是到它接手时,该保留的区别已经不在操作数中。
有理化式也会遇到x+1舍回x,为什么还好?因为它不再靠两个近似根号的差来携带那个1。分子1由代数恒等式提前保留下来,分母只需近似√(x+1)+√x。把后者算成2×10⁸,相对影响很小,取倒数后便得到接近正确的小量。
还可以故意写一个貌似忠于推导的版本:把分子也交给机器算成(x+1)−x,再除以两个根号之和。在本次环境里,分子会先变成0,结果照样错误。纸上把分子约成1与程序执行加减后碰巧得到1,并不是同一件事。代数化简的价值恰在于省掉那个本来会丢信息的中间表示。
这绝不是从已经损坏的差值0里“找回”信息。若先算坏了0,再把它搬进另一种写法,信息仍然丢失。改写必须发生在计算之前,并且利用原问题中确实已知的关系。
消去放大的,常是先前的误差
把理想的两个中间量记为a、b,机器得到a+e₁和b+e₂。即使最后减法精确,所得结果也只是
(a−b)+(e₁−e₂)。
因此,当a≠b时,这部分误差相对于目标差值的大小为
|e₁−e₂|/|a−b| ≤ (|e₁|+|e₂|)/|a−b|。
a和b很大而a−b很小时,对操作数很小的误差,相对于答案却可能很大。这就是为什么许多相近量相减的问题,被称为严重消去:相同的大部分消失了,先前误差却可能留在剩下的部分里。[1]
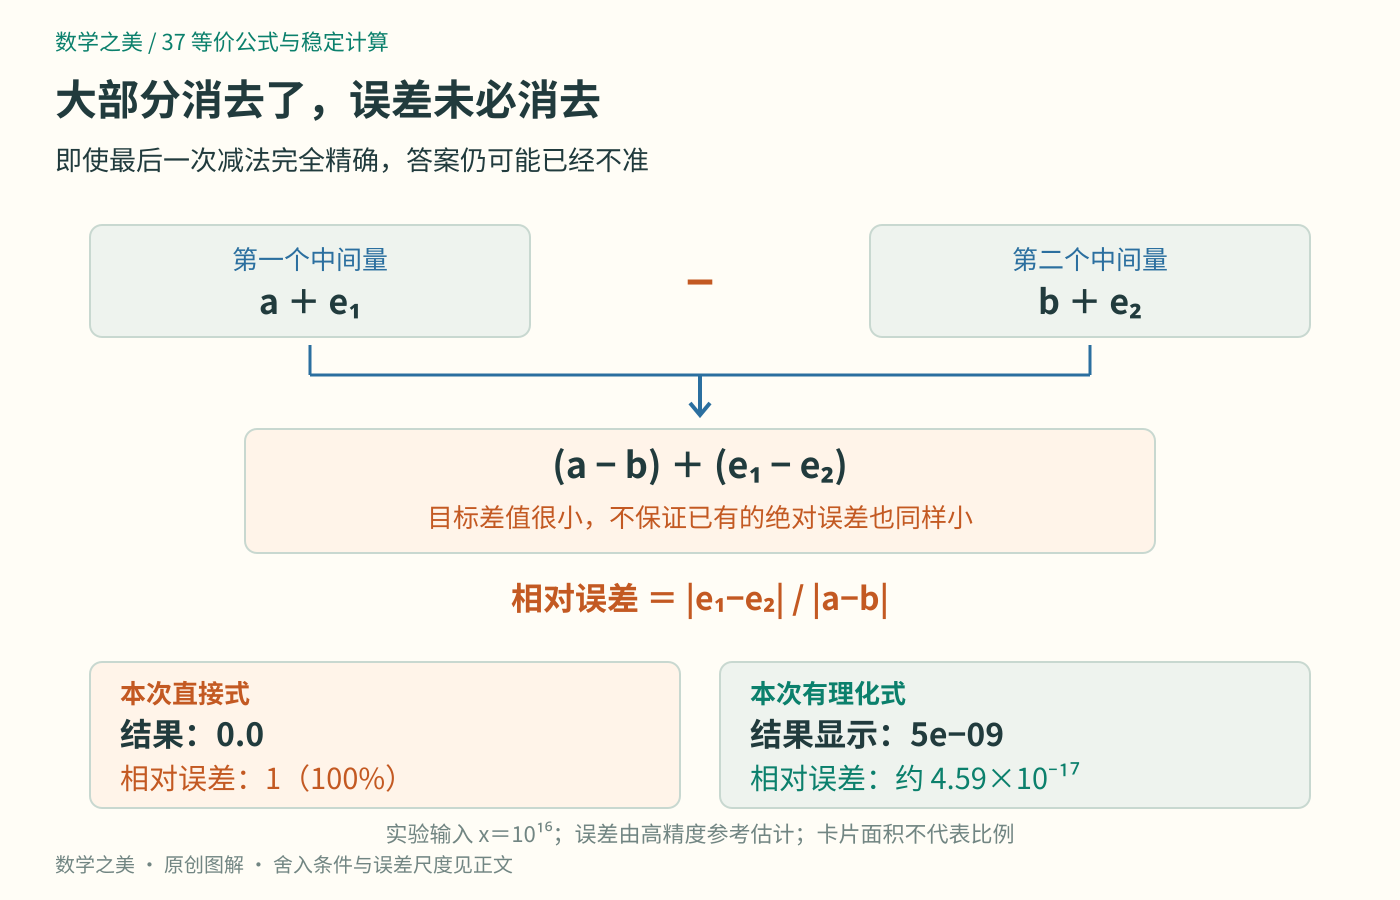
图3:上方等式假定最后的减法精确,已足以说明误差放大。下方数字来自本章实验;两个结果卡片的面积不表示误差比例。
所以不能把规则粗暴写成“接近的数禁止相减”。例如两个可表示的正浮点数满足b/2≤a≤2b,在正确舍入且差值未受下溢丢失影响时,其差可以精确表示并计算;这类结论称为Sterbenz引理。[1] 是否危险,还要追问这些浮点数在成为操作数之前,是否已偏离我们真正需要的量。
反过来,也不能保证两个误差一定同向累积。e₁与e₂可能部分抵消;上式给的是可能放大的通道与上界,不是每个输入都会达到的灾难程度。
有理化式为什么没有同样的放大因子,也能直接算清。设正确分母为s>0,算出的分母为s(1+η),且|η|<1。暂时不计最后除法的舍入,输出与1/s之间的相对误差恰为
|[1/(s(1+η))−1/s]/(1/s)|=|η|/|1+η|
≤|η|/(1−|η|)。
若分母的相对误差很小,倒数的相对误差也很小;最后除法仍会再贡献一次舍入。这不是完整覆盖所有边界的误差定理,却解释了这条路径的优势:误差没有再除以两个大数之间那个微小的差。我们关注的始终是误差相对于所需答案的比例,不只是输出的小数点后有多少个零。
好题目,也可能被差的路径算坏
第36章用条件数衡量数学问题对输入的局部敏感程度。它与刚才的中间误差不能混为一谈。对x>0,本章函数的相对条件数实际上小于1/2。
先补上开方的导数。对t>0,在h≠0且t+h≥0时,有理化差商得到
[√(t+h)−√t]/h=1/[√(t+h)+√t]。
因为|√(t+h)−√t|≤|h|/√t,开方值随h趋于0而趋于√t。因此右边趋于1/(2√t),所以(√t)′=1/(2√t)。由此
f′(x)=1/[2√(x+1)]−1/(2√x)
=−f(x)/[2√x√(x+1)]。
沿用上一章的局部相对条件数定义,
κ(x)=|xf′(x)/f(x)|
=x/[2√x√(x+1)]=(1/2)√[x/(x+1)]<1/2。
这要求x>0,并讨论足够小的输入扰动;x=0不能机械代入这个相对定义。结果说明,对这里的x输入而言,原函数并不高度敏感。10¹⁶处算出0,主要是运算安排造成的,不是题目注定难算。
这里没有与“相近数相减可能敏感”矛盾。若把两个根号的值当成彼此独立、各带误差的输入,它们的差当然可能很难确定;本章原题却只有一个输入x,另一个根号严格来自x+1。两者受同一关系约束,不允许各自任意飘动。问题的输入是谁、哪些关系精确已知,直接决定条件数在回答什么。
同理,若现实任务拿到的是两个独立测量值u与v,只因它们的名义读数看起来差1,就把√u−√v改成1/(√u+√v),那已不是等价变换。真正的分子应该是u−v;测量能否确定这份差异,要回到数据本身判断。稳定算法使用已知结构,不能制造未经保证的结构。
直接式把问题拆成两个大根号,再要求它们保留极小差值。有理化式改变了这条路线。通常把避免不必要地放大舍入影响的性质称为数值稳定性;这里只分析了这一个机制,没有给任何改写颁发“永远稳定”的通行证。不同定义域、溢出下溢与计算成本仍要分别检查。
本章比较的是准确度,也没有测量速度。有理化式多了一次除法,真实耗时还受实现与硬件影响,不能从答案更准推断程序更快。若改写引入新的极大乘积、极小分母或无定义操作,还可能产生另一类风险。先核对等价范围,再分析每一步的数值尺度,才是可迁移的方法。
稳定的路径也不会自动修复病态的原始数据。若上一章的测量本身无法确定,换公式不能替实验补出未知的小数;提高运算精度同样不能创造缺失的测量信息。
连括号,也属于算法
同一环境中,还能得到
a, b, c = 1e16, -1e16, 1.0
print((a + b) + c)  # 1.0
print(a + (b + c))  # 0.0
三个float在这里代表固定、精确的输入值。第一条路径先让正负大数精确抵消,再加1;第二条路径先计算−10¹⁶+1并舍回−10¹⁶,随后得到0。改变的是逐步舍入的路线,实数加法的结合律没有被数学推翻,却不能原样当作浮点程序重排的保证。
我们不必因此把所有公式都改一遍。值得先问的是:答案来自哪些小差别?这些差别何时会与大数合并?是否存在经证明等价、又更好保存相关信息的写法?下一章把这些问题带回最小二乘,检查一个实际数值结果,究竟需要怎样的证据。
顺手试一下
题目1: 造一台只保留3位十进制有效数字的玩具机器。输入x=100和常数1都精确;每次加、减、除和开平方后,按最近值舍入,恰在中点时末位取偶;指数范围暂不限。分别计算√(x+1)−√x及1/[√(x+1)+√x]。哪一步丢失差异?用参考值0.04987562112估计两者的相对误差。
提示:√101≈10.0498756。3位有效数字不是保留3位小数;每一步都执行舍入。
**参考答案:**x+1=101能精确保存。√101舍为10.0,√100也为10.0,所以直接式得到0,相对误差为1。有理化式的分母是20.0,倒数为0.0500,相对误差约0.00249378,即0.2494%。这里差异丢在开方结果的舍入,最后的10.0−10.0没有新增误差;它与正文中先丢在x+1的例子有所不同。
题目2: 对h≥−1,把g(h)=√(1+h)−1有理化,检查h=−1与h=0是否适用。再证明g(h)与h/2之差恰为−h²/[2(√(1+h)+1)²]。这能否说明任意h都可以放心用h/2?
**提示:**有理化后的分母始终至少为1;计算g(h)−h/2时,再利用一次√(1+h)−1的改写。
**参考答案:**g(h)=h/[√(1+h)+1],分母≥1,因此整个h≥−1的范围成立。h=−1给−1,h=0给0。通分并有理化得
g(h)−h/2=h[1−√(1+h)]/[2(√(1+h)+1)]
=−h²/[2(√(1+h)+1)²]。
当h≠0,余项绝对值除以|h|至多为|h|/2,随h趋于0而趋于0,因此h/2是局部一阶近似。它不等于精确改写,也不保证远处准确:h=−1时近似为−1/2,真值为−1。若原输入保留了小h,有理化式还可避免先算√(1+h)再减1的消去;但h自身已未知或被丢失时,这个公式不能恢复它。
参考与延伸
[1] David Goldberg,What Every Computer Scientist Should Know About Floating-Point Arithmetic,1991年论文,Oracle经授权收录的编辑重印版。参见Cancellation及Theorem 11:消去可能暴露先前误差,接近的浮点数之差也可能精确。正文函数的恒等式、误差传递与条件数在文中独立推导。
[2] Python官方文档,decimal — Decimal fixed-point and floating-point arithmetic。核对字符串构造、from_float、精度上下文与平方根计算。本章参考实验使用80位精度,并以120位复核。
[3] Python官方文档,math — Mathematical functions。核对sqrt、ulp与nextafter的含义。文中浮点输出来自Python 3.12.14环境的独立运行,不是生产系统的性能或准确度测试。
本文三幅图为原创机制图;三位十进制算例是明确规定舍入规则的教学模型。
作者:Jiancheng Wang · 数学之美(独立原创)