先修:19 有限概率模型;21 期望、方差与协方差;平方根
审核一条告警,常常比生成一条告警费时。需要查日志、回看设备状态,才能判断它是否真有故障。若每天收到很多告警,只审核其中一部分,得到的比例能有多可信?
设一次抽查了40条,其中23条确有故障,样本里的真故障比例就是23/40=0.575。这个数算得再精确,也没有回答另一个问题:换一批告警抽查,结果会偏离多少?
本章要把“样本多一些会更稳”变成一条带条件、可计算的结论。我们会得到一种保守保证:在独立同分布的模型中,要把误差尺度减半,样本量需要变成四倍。但先得说清楚,这些样本究竟从哪里来。
先确定我们正在估计谁
前面的虚构台账里,198条告警中有99条真故障,因此告警内的真故障比例为1/2。那张完整台账已经知道所有标签,无须再用抽样猜它。现在换成需要审核的新告警来源,目标是估计:
p=P(D|E),即告警集合中的真故障比例。
D仍表示故障,E仍表示告警。这里要求P(E)>0,才能定义这个条件概率。这里的p与第21章末尾的总体告警率P(E)不同:本章的分母只包括告警,不能把它解释为全部检测窗口中的故障率或告警率。
先规定同一套检测器、设备范围和运行条件,再作一个明确的模型假设:每次选到的告警,以固定概率p对应真故障,各次结果相互独立。这个p未知,却不随本章的抽样批次变化。未来是否能沿用同一个p,必须另有依据;设备老化、策略调整或负载变化,都可能使固定模型失效。
第i条告警若确有故障,记Xᵢ=1,否则记Xᵢ=0。每个Xᵢ都是伯努利变量,满足P(Xᵢ=1)=p。这些变量相互独立、分布相同,简称独立同分布,常写作i.i.d.。本章暂把事后标签视为准确;审核本身若会出错,还要另行研究标签误差。
可以用一张已知台账搭建严格满足条件的教学实验:每次从198条告警中均匀抽一条,记下标签后放回,再独立重抽。此时p=99/198=1/2,同一行可以再次出现,但每次抽取的随机选择相互独立。这个构造只是说明假设怎样实现;它没有替真实的新告警证明独立性。也正因为允许放回,抽取次数可以超过台账行数。
取正整数n。由n条告警得到的估计量是样本均值:
p̂=X̄=(X₁+…+Xₙ)/n。
p̂读作“p帽”,用来提醒我们它是对p的估计。抽样前,它随可能的样本变化,是随机变量;审核完一批后,得到的0.575则是它的一次观测值。未知的模型参数p,与已经算出的样本比例,不能混为一谈。1
平均为何能降低波动
第21章已经证明,伯努利变量有EXᵢ=p、Var(Xᵢ)=p(1−p)。期望的线性性给出:
Ep̂=(EX₁+…+EXₙ)/n=np/n=p。
这叫无偏:在同一个模型下,估计量的期望等于目标值。它没有承诺这次样本恰好等于p。即使真实p=1/2,40条里出现23条真故障,也完全可能。
再看方差。把和的平方展开,各成对协方差因独立而为0,因此
Var(p̂)=Var(X₁+…+Xₙ)/n²
=Var(X₁)+…+Var(Xₙ)/n²
=np(1−p)/n²=p(1−p)/n。
求期望时不需要独立,去掉协方差时才用了它。这一步决定了增加样本到底有没有带来更多信息。1
为什么除以n后会出现n²?若总数偏离其期望的量是d,均值的偏离就是d/n,平方后便是d²/n²。总数的方差随着n增加到n倍,分母却增加到n²,最后留下1/n。正是这两种增长速度的差别,让平均值比单次结果更稳定。
p还未知,右边怎么办?配一个平方就有:
p(1−p)=1/4−(p−1/2)²≤1/4。
这里没有把观测到的p̂偷偷代回未知的p。上界1/4对所有0≤p≤1同时成立,所以即使还不知道p,也能用它作统一保证。
于是Var(p̂)≤1/(4n)。取平方根,样本均值的标准差为√p(1−p)/n,至多1/(2√n)。在固定p的模型中,它按1/√n缩小。比如p=1/2时,n分别为25、100、400,标准差依次为0.1、0.05、0.025。
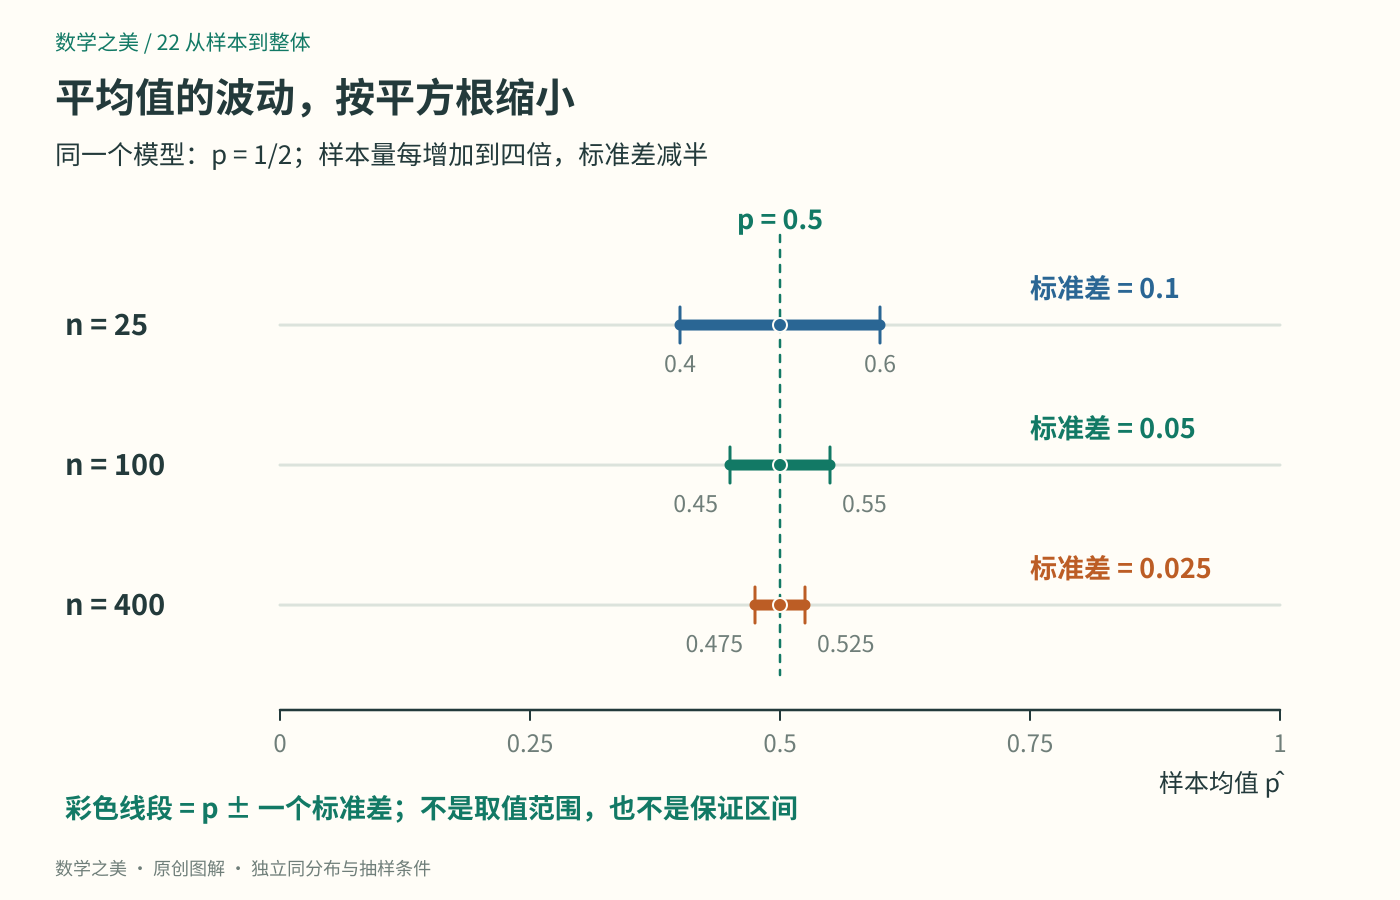
图1:彩色线段表示p左右各一个标准差,不是样本均值的取值范围,也没有声称某个覆盖概率。三个样本量下,全0或全1都仍可能发生。
标准差衡量整体波动,却不能直接回答“误差达到5个百分点的概率有多大”。为回答这个问题,我们需要把平方偏离的平均,变成超过阈值的概率上界。
从非负数的平均得到一道界限
先研究任意一个非负随机变量Z。沿用有限模型,结果记作ω,结果概率记作q(ω)。取正阈值a,令A包含所有满足Z(ω)≥a的结果。
期望可以分成A内、A外两部分:
EZ=∑ω∈A Z(ω)q(ω)+∑ω∉A Z(ω)q(ω)。
因为Z和q都非负,删去第二部分,数值不会增加。在第一部分里,每个Z(ω)至少为a;逐项把它换成a,数值也不会增加。所以
EZ≥∑ω∈A Z(ω)q(ω)
≥∑ω∈A a q(ω)=a P(A)。
除以正数a,便得到马尔可夫不等式:
P(Z≥a)≤EZ/a,条件是Z≥0、a>0。2
这段证明只用了有限和与非负性。直观地说,达到阈值的每一份概率,至少给期望贡献a倍的分量;若总期望不大,达到阈值的概率就不能太大。若Z允许负值,外部负项可能抵消这份贡献,刚才“删去后不会增加”的理由就不成立。
例如,让Z以相同概率取−100和100,便有EZ=0,但P(Z≥50)=1/2。若忽略非负条件,右边会算成0,立即出错。定理中看似不起眼的条件,正对应证明不能缺少的那一步。
现在专门取Z=(p̂−p)²,它必定非负;再取a=ε²,其中ε>0。因为Ep̂=p,所以EZ=Var(p̂)。同时,“平方偏差至少ε²”恰好等价于“绝对偏差至少ε”。代进去:
P(|p̂−p|≥ε)=P((p̂−p)²≥ε²)
≤Var(p̂)/ε²=p(1−p)/(nε²)
≤1/(4nε²)。
中间这一步就是切比雪夫不等式在样本均值上的应用。2 我们没有假定样本均值呈钟形,也没有借用正态近似;对固定n,所有0、1样本序列构成有限模型,前面的逐项证明足够使用。
把误差要求换算成样本量
取ε>0、0<δ<1。ε表示能容忍的误差幅度,δ表示允许“误差达到ε”的概率上界。比如要求ε=0.05、δ=0.05,就是要求偏差达到5个百分点的概率至多为5%。注意这里是百分点:0.50与0.55相差0.05,并不是相对误差5%。
只要让1/(4nε²)≤δ,便足以满足要求。整理得到:
n≥1/(4ε²δ)。
代入本例,n≥1/4×0.05²×0.05=2000。因此,在上述独立同分布、标签准确的模型下,取2000条样本,就能用这条不等式保证:
P(|p̂−p|≥0.05)≤0.05。
等价地,误差小于0.05的概率至少为0.95。这是抽样方法在固定模型下的保证;它不意味着实际重复100批时,恰有95批合格,也不意味着每一批都能合格。
例如,若一批2000条中审核出1120条真故障,观测比例就是0.56。公式没有直接告诉我们这批误差多少,因为p未知。假如模型的真实p恰为0.50,这批误差就是0.06,属于允许出现、但总概率受限制的事件。概率保证并不会在看到一批不理想样本时被自动推翻。
2000是充分的保守样本量,不是最小样本量。这条界先用方差限制尾部,再用1/4替代未知的p(1−p),留下了余量。更细地利用分布信息,可能得到更紧的界;仅凭这里的推导,不能反过来断言1999条一定不够。3
开头只有40条时,这条界在ε=0.05处给出1/(4×40×0.05²)=2.5。概率当然不会超过1,因此可把上界截为min{1,2.5}=1。它表达的是这条界没有给出有用限制,不是说失败概率达到250%。
若固定δ,反过来把误差阈值写成n的函数,得到:
εₙ=1/(2√(nδ))。
因此固定这份概率保证,要让误差界减半,n也要变为四倍。标准差与这个保守误差界都有1/√n的尺度,但它们是不同的量;δ越小,要求越严格,同一样本量给出的误差界就越宽。
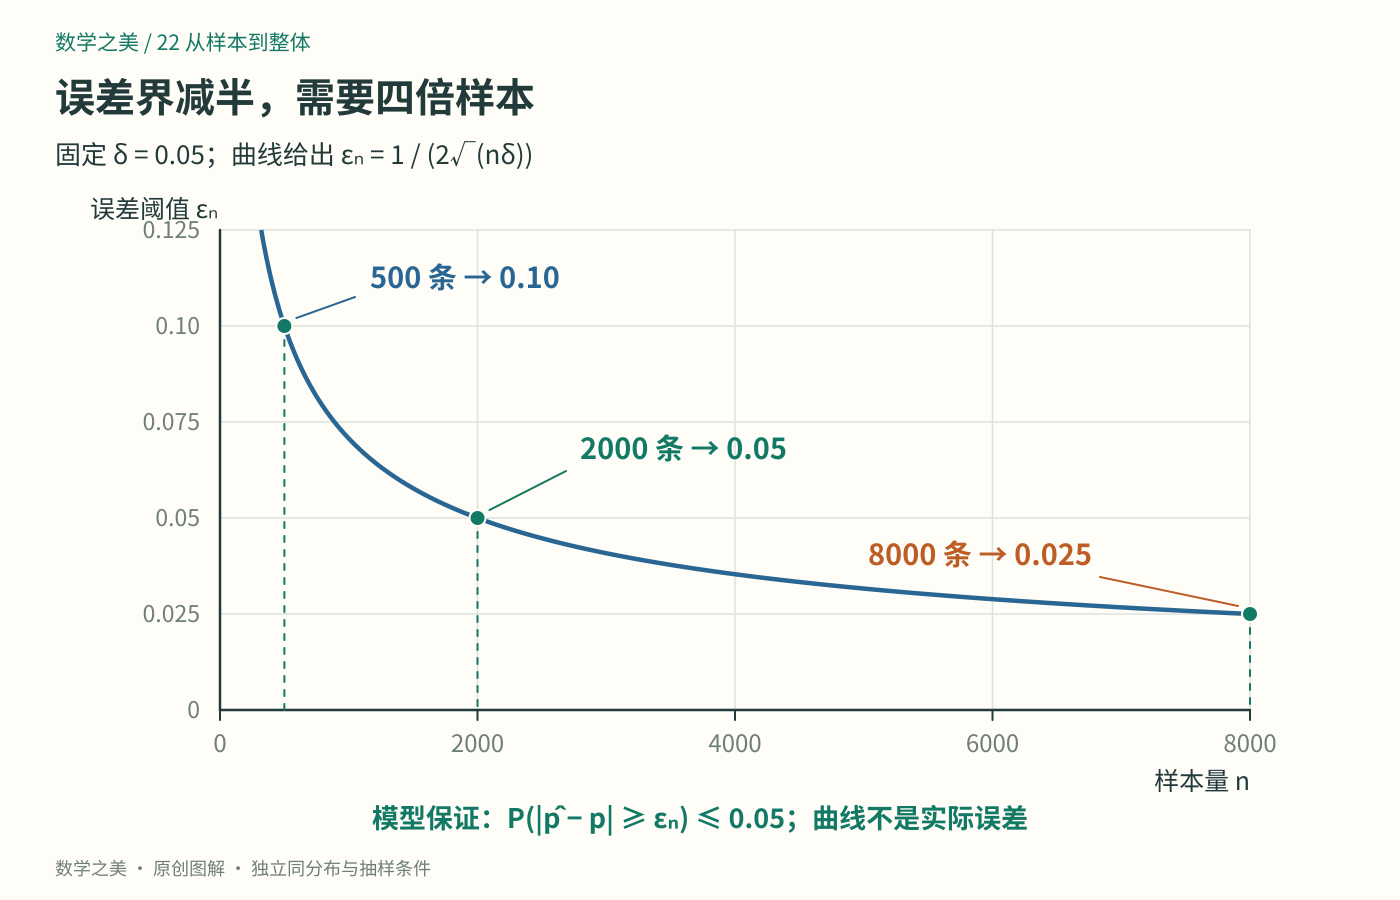
图2:曲线是由不等式计算的误差阈值,不是一批样本实际误差的轨迹。n变成四倍,阈值才减半;2000和8000都只是相应要求下的充分样本量。
还要留意概率说的是谁在变化:在这里p固定,尚未抽取的样本随机。观察到具体p̂以后,不能把刚才的结论改读为“p有95%的概率落在这次估计附近”。本章没有为p本身设定概率分布。
若固定ε>0而让n不断增大,上界1/(4nε²)趋于0,便得到伯努利情形的弱大数定律:样本比例偏离p达到指定幅度的概率趋于0。3 它不要求每增加一条样本,实际误差都比上一刻小;一条相反标签,完全可能把暂时很准的比例推远一点。
有些问题不会被更多行数解决
设只抽到一个伯努利变量Z,却把它复制n次,令X₁=…=Xₙ=Z。每个Xᵢ单独看仍以概率p取1,分布完全相同,但它们并不独立。此时
p̂=(nZ)/n=Z,Var(p̂)=p(1−p)。
方差一点也没缩小。特别是p=1/2时,p̂永远是0或1,误差永远为1/2。对照一下真正独立的p=1/2模型:连续n条都为0的概率为(1/2)ⁿ,会随n迅速减小;复制模型中,所有记录为0的概率始终为1/2。两边每行的分布相同,整批记录的联合分布却不同。
把同一条告警复制一万次,不能代替审核一万条独立告警。真实系统中同一次故障触发的一串记录,也需要警惕共同来源。
另一种失效发生在抽样入口。假如只挑白天、平时运行稳定的设备告警,目标却是全部时段、全部设备的告警,样本可能来自另一个真故障比例为q的群体。即使在这个窄群体内独立抽取,Ep̂也等于q。增加n可以降低围绕q的波动,却不会自动消除q与目标p之间的差别。这就是选择偏差。比如目标群体的p为0.5,所选子群的q为0.2,更多审核只会使子群的0.2被估得更稳定。一个数字看起来越来越稳定,仍可能没有回答原来的问题。扩大覆盖、重新设计抽样入口,比单纯增加这个子群的条数更要紧。
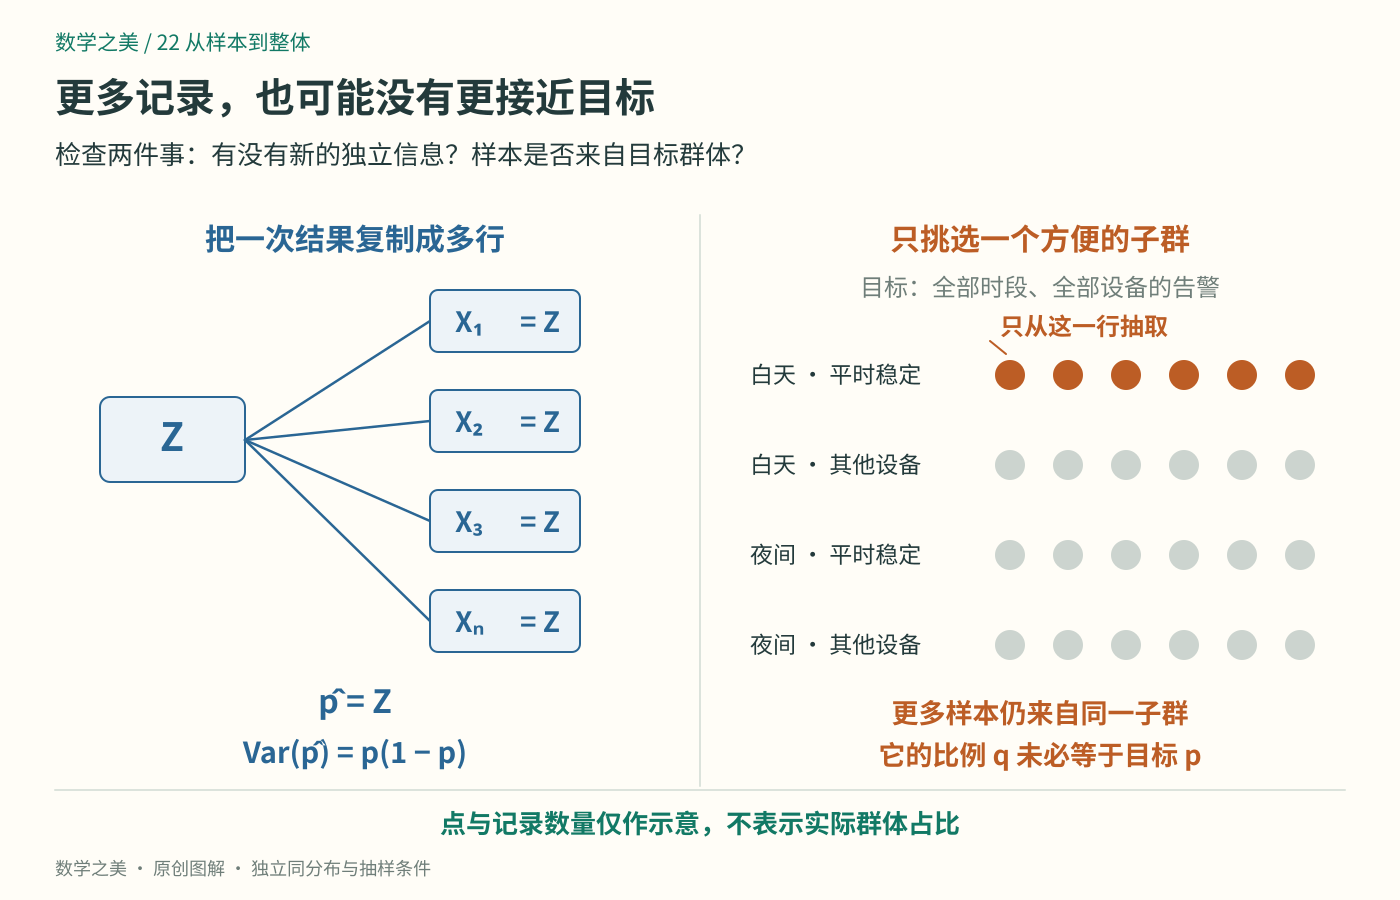
图3:左边缺少新的独立信息,右边缺少对目标群体的覆盖。图中记录和群体数量仅作示意,不代表真实系统的比例。
还有一种不同情况:从固定台账中均匀、不放回地抽取。抽走一条后,剩余标签组成会改变,抽样之间存在相关性;相应方差要考虑有限总体修正,不能直接把本章i.i.d.公式当作等式照搬。若把台账全部审核完,台账比例自然没有抽样误差;这也不等于未来比例已经被精确知道。
所以,准备增加审核预算时,应先问:目标告警集合是否清楚?采样是否覆盖它?记录间是否共享故障来源?运行条件是否稳定?这些条件可靠以后,1/√n才是一把能帮助规划工作的尺子。下一章将回到检测器评估,检查怎样让用于报告的数字真正回答我们想问的问题。
顺手试一下
题目1: 沿用本章独立同分布模型,希望误差达到2.5个百分点的概率至多为5%。用本章的保守界,需要多少条样本?若取8000条,观察到4400条真故障,p̂是多少?能否由此断言p恰好等于0.55,或少于8000条必定不满足要求?
提示: 先把百分点化为ε=0.025,再代入n≥1/(4ε²δ)。区分样本观测值、固定参数与充分条件。
参考答案: n≥1/4×0.025²×0.05=8000。此时Var(p̂)≤1/32000,失败概率上界为(1/32000)/0.025²=0.05。观测值p̂=4400/8000=0.55;p仍未知,不能断言等于0.55。8000是这条保守界给出的充分样本量,不能据此证明更少样本一定不满足要求。相较2000条、5个百分点的要求,误差阈值减半,样本量变为四倍。
题目2: 先独立审核2000条告警,真实标签Y₁,…,Y₂₀₀₀独立同分布于Bernoulli(p)。然后每条复制4次,得到8000行。对8000行求均值,期望和方差分别是多少?在ε=0.025处,本章的保守失败概率上界是多少?若要让该上界降到0.05,应增加原始审核,还是再复制?
提示: 先约掉每个Yⱼ前面的4。独立来源的数量只有2000。
参考答案: 均值为4∑ⱼYⱼ/8000=(∑ⱼYⱼ)/2000,期望为p,方差为p(1−p)/2000≤1/8000。故失败概率上界为1/(4×2000×0.025²)=0.2,而非按8000独立样本算出的0.05。这里0.2也只是上界。应让独立同分布的原始审核达到8000条,即再增加6000条符合模型的新样本;复制次数再多,也不改变这个均值的方差。
参考与延伸
1 Hossein Pishro-Nik,《Introduction to Probability, Statistics, and Random Processes》,7.1.1 Law of Large Numbers。核对独立同分布样本均值的定义、期望与方差推导。
2 同教材,6.2.2 Markov and Chebyshev Inequalities。核对非负性、正阈值条件,以及对平方偏差应用马尔可夫不等式的推导。
3 Charles M. Grinstead、J. Laurie Snell,Introduction to Probability,第8.1节,书内第305—309页。核对离散情形的切比雪夫不等式、弱大数定律,以及界限可能保守的说明。
本文告警审核情境、样本数值和图解均为原创教学构造;前文台账也是虚构数据,并非真实系统评测。以上教材用于核对数学结论。
作者:Jiancheng Wang · 数学之美(独立原创)