先修:12 数据与损失;17 最小二乘投影;21 期望、方差与相关性;23 可信评估;29—33 损失、导数、梯度与优化
沿着这一部走来,我们先写清目标,再计算变化率,最后研究怎样调整参数、确认最优。现在回到最初的玩具:如果把已有读数拟合得更好,预测就一定更好吗?
答案是否定的。优化证明可以毫无漏洞,交到实际使用中的预测仍可能令人失望。问题不在于数学失效,而在于“把训练目标降到最低”与“把未来误差降到最低”,本来就是两件事。本章把这道缝隙算出来,再用第21章的工具解释其中的波动。
同样三个点,两份不同的成绩单
仍用虚构滑杆读数(0,1)、(1,2)、(2,2),输入与输出均以厘米计。第17章证明,在所有直线中,候选C:
C(x)=x/2+7/6
使训练残差平方和SSE达到全局最小值1/6平方厘米。任何斜率或截距的改动,都不能在这三条记录上胜过它。
现在扩大模型,允许二次项。取
q(x)=−x²/2+3x/2+1。
这里及下文的多项式都按固定厘米坐标的数值计算。代入0、1、2,分别得到1、2、2,三个点全部穿过,训练SSE降到了0。平方和不能为负,所以这也是一个全局最小值。C的证明没有被推翻:允许的预测集合变了,二次曲线原本就不在直线族里。
在这次教学构造中,两条规则只由上述三点确定;另设两条未用于拟合或选择规则的新读数:
(1/2,3/2)、(3/2,2)。
逐点代入,C给出17/12、23/12厘米;q给出13/8、17/8厘米。沿用第12章的残差“观测−预测”,C的两次残差均为1/12厘米,q的两次残差均为−1/8厘米。因此,新点上的测试平方和为
SSE新(C)=2×(1/12)²=1/72,
SSE新(q)=2×(1/8)²=1/32。
两者单位都是平方厘米。训练时q胜出,在这两个新点上却是C胜出。
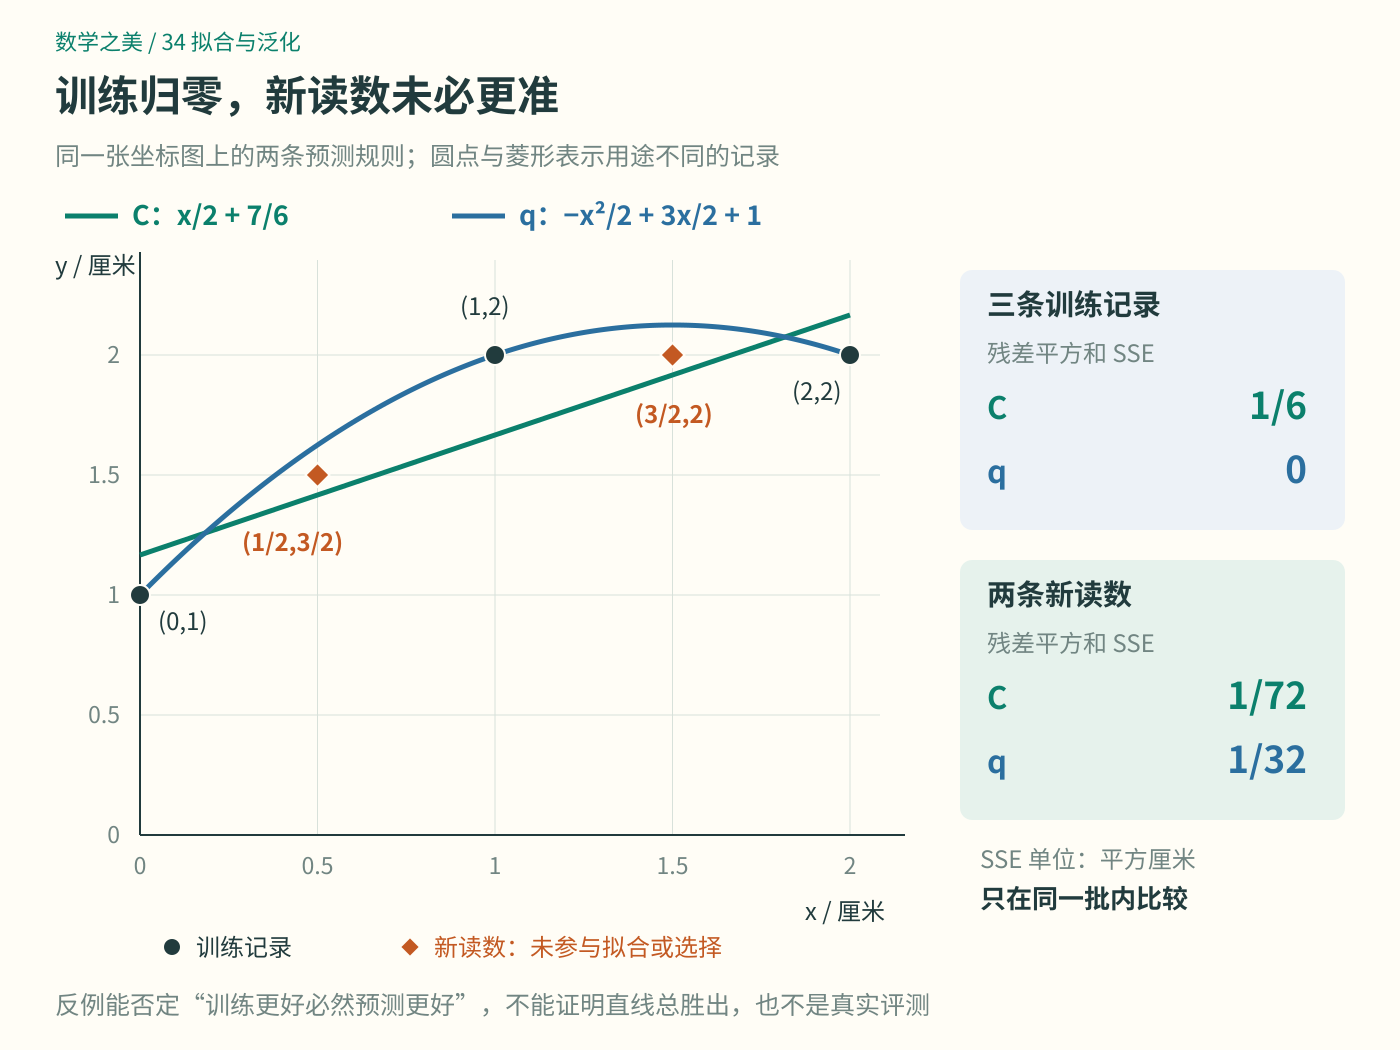
图1:曲线与全部点按所标坐标绘制。只在同一批记录内比较两条规则;训练有三个点,新点有两个,不能拿两批SSE的数值直接判断改善幅度。
这只是一个精确反例,足以推翻“训练更好必然预测更好”,不是真实评测,也没有证明直线总胜过二次式。若另两次新读数恰好落在q上,排序就可能相反。两条教学记录更不足以估计某个真实装置的长期表现。
拟合的是规律,还是这一次的偶然
旧数据上的参数本来就是照着旧数据选的,成绩因而有天然的优势。若一次偏高的读数来自不会重复的扰动,模型为了贴近它而弯曲,可能把这次偶然也带进预测。通常所说的过拟合,正是模型过度适应训练记录中的细节,未能把这种优势带到未见数据上。
但不能一见曲线弯曲,就诊断为过拟合。如果真实关系确有弯曲,执意只用直线,也可能遗漏重要结构。欠拟合强调模型或训练过程没有充分捕捉有用关系;仅凭一条线的外形,同样不能完成诊断。
有一条范围明确的结论:若两个模型族有包含关系,较大的模型族包含较小者,使用同一训练数据和损失,而且都达到全局最小值,扩大候选集合不会使最小训练损失上升,因为原来的候选仍可选择。未来误差没有由此获得同样的单调性。
参数数量也不直接等于自由程度。第17章给模型加上重复列,多了参数,却没有扩大可行预测集合。数据量、结构、训练方法和约束都会影响结果,不能机械地说“大模型必定过拟合”或“小模型一定泛化好”。
固定一个位置,想象重新训练许多次
要把“偶然”说得更精确,需要明确随机的是什么。[1]
先固定一个输入x。在该位置,设新读数遵循模型
Y=f*(x)+ε,E[ε]=0,Var(ε)=σ²。
f*(x)是这个位置的真实平均读数,不是我们已经知道的拟合曲线;ε描述围绕它的测试读数波动。这里没有要求噪声一定服从正态分布。
再按同一个抽样机制取得训练数据D,用固定的训练规则得到预测
T=f̂_D(x)。
D若重抽,T可能改变。因此T也是随机变量。我们假设测试噪声ε独立于训练数据D,预测只由D和已固定的规则产生;并假设T、ε都有有限二阶矩,即平方的期望有限。若训练过程还使用随机数,也应把那份随机性纳入D,并要求扩充后的D与测试噪声独立。
现在要算的是E[(T−Y)²]:既平均不同训练数据产生的预测,也平均新读数的噪声。它不是拿到某一份训练集后,算出的那一个训练SSE。为沿用第21章,可以先把D、ε想成有限种可能;有限二阶矩的条件则让同样的期望运算适用于更一般的模型。
三项误差,从一次平方展开中出现
令m=E[T],把预测误差拆成
T−Y=(T−m)+(m−f*(x))−ε。
其中T−m是每次预测偏离平均预测的量,m−f*(x)是平均预测与真实均值的固定差。记δ=T−m、c=m−f*(x),平方展开为
(T−Y)²=δ²+c²+ε²+2cδ−2δε−2cε。
逐项取期望,不能只说“交叉项自然消失”,要检查依据:
- E[δ]=E[T]−m=0,所以E[2cδ]=2cE[δ]=0
- E[ε]=0,所以E[−2cε]=−2cE[ε]=0
- ε独立于D,因而独立于由D确定的δ;第21章的乘积规则给出E[δε]=E[δ]E[ε]=0
剩下的三项中,E[δ²]=Var(T);c是常数,E[c²]=c²;噪声均值为0,所以E[ε²]=Var(ε)=σ²。于是得到
E[(T−Y)²]=(E[T]−f*(x))²+Var(T)+σ²。
这就是平方风险的偏差—方差—噪声分解。偏差是平均预测离真实均值有多远;方差是同一位置的预测随着训练数据更换而有多大波动;噪声方差是新读数自身围绕真实均值的波动。三项都以输出单位的平方计,合在一起才是这里的期望平方误差。
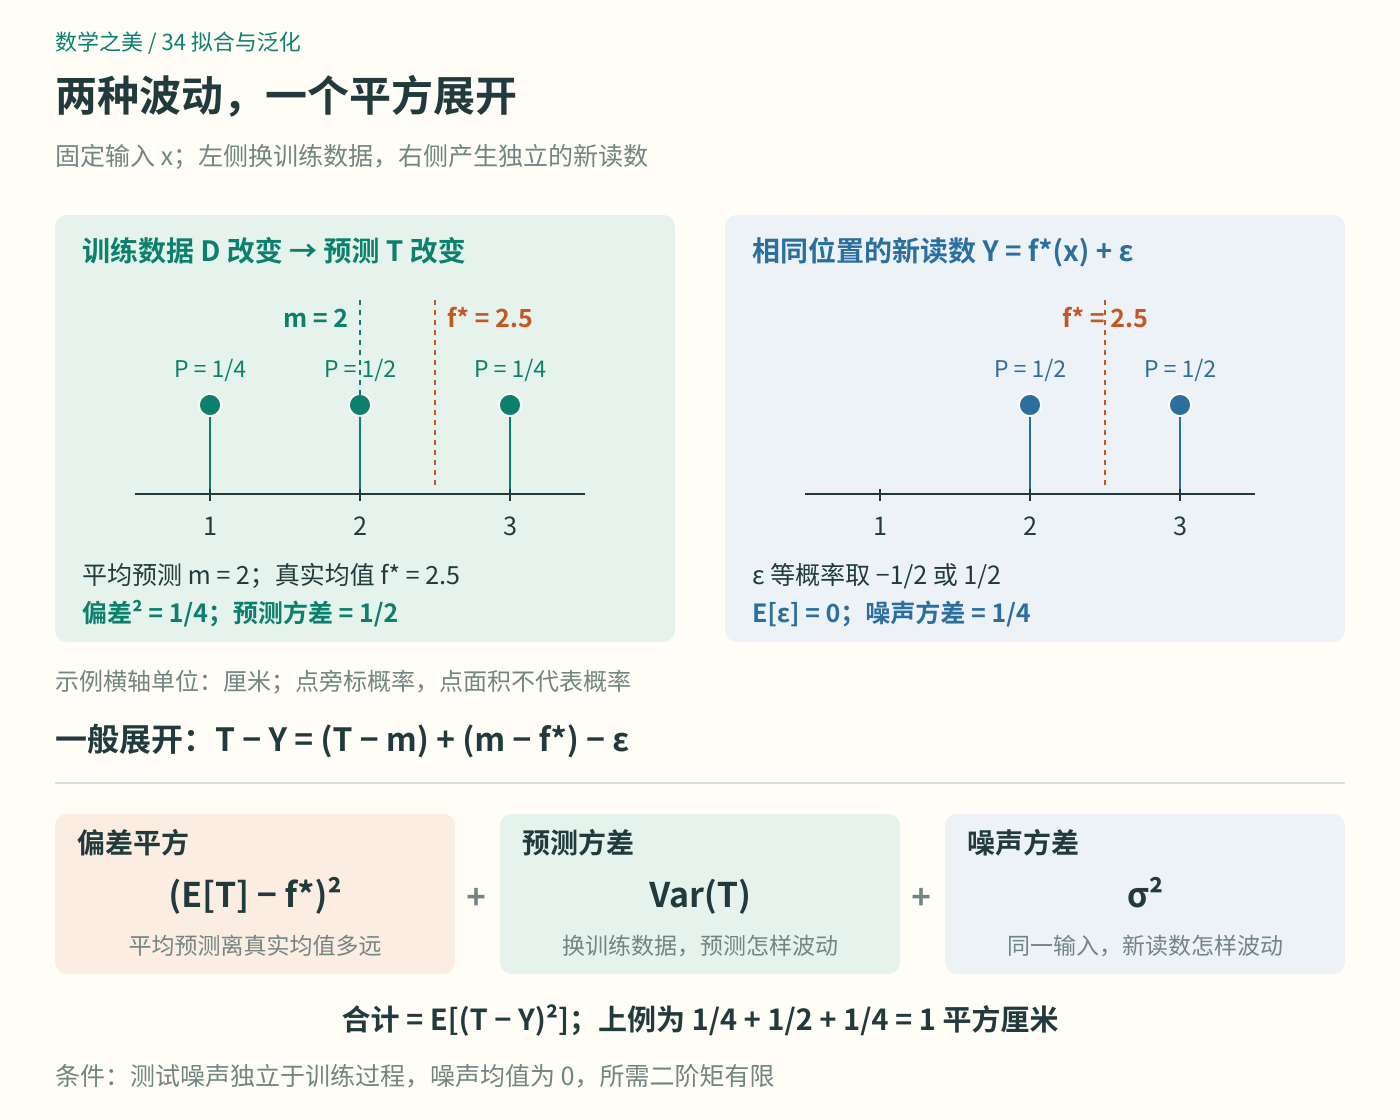
图2:上半幅用一个另设的有限概率例子区分两种波动,不是三点拟合的重复实验。点旁给出概率,横向位置表示读数;下半幅对应正文的一般恒等式。
同样从展开式可知,若已知道f*(x),直接预测它,前两项就都为0,只剩σ²。这是在当前输入信息、读数机制和平方损失下的基准,不是在宣布任何增加传感器或改善测量的办法都无法减少噪声。
这条公式也没有说偏差与方差必定此消彼长,更没有规定测试误差必须画成某种固定形状。它只是把给定学习过程的风险拆清楚,如何变化仍取决于具体模型。
尤其不能从一份数据的训练误差和测试误差,直接读出准确的偏差、方差。我们通常既不知道f*(x),也没有拿到所有可能训练集的预测。若测试噪声与训练数据相关,E[δε]就不能照上面消去;若换了抽样机制或目标环境,也要重新检查假设。对所有输入的总体风险,还须按目标输入分布把这些逐点风险再平均。
正则化,是重新写清愿意怎样拟合
为了抑制某些参数过度追随数据,可以给它们加代价。这叫正则化。它改变优化题目,不能被理解为原目标没求准。
回到三点直线,只惩罚斜率a,不惩罚截距b,考虑[2]
Jλ(a,b)=SSE(a,b)+λa²,λ≥0。
以下按固定厘米坐标做数值运算。固定a时,使SSE最小的截距为b=5/3−a,因为平均预测应等于平均观测。代入并配方,原平方和化成
SSE(a,5/3−a)=2(a−1/2)²+1/6。
加上惩罚后,对a求导:4(a−1/2)+2λa=0。二次项系数2+λ>0,故唯一最优解是
a=1/(2+λ),b=5/3−a。
λ=0时回到C;λ=2时,a=1/4、b=17/12。斜率缩小了,直线更平,但“更平”本身不是更准确的证据。它的训练SSE为7/24,比C的1/6更大。这是新目标愿意付出的拟合代价,未来能否受益还需评估。
单位不能在这里消失。SSE以平方厘米计,a是输出厘米与输入厘米之比;把物理量直接相加时,λ必须携带相应尺度,使λa²也具有平方厘米单位。“λ=2”指上述固定坐标下的数值。改单位、缩放特征,或把SSE改成MSE,都必须相应处理惩罚权重,不能原封不动照搬这个2。
正则化有机会减少训练扰动引起的预测波动,也可能把有用关系压得太平。任何λ都改善泛化,并不是定理。该用多强的限制,需要在未拿来求这次参数的证据上比较;最终测试数据不能兼任挑选λ的工具。
给训练、验证和测试各留一份工作
第23章已经区分“没参与选择”与“样本彼此独立”。现在把它落到拟合流程上:[3]
- 先约定目标使用范围、损失、单位与数据来源,再按任务特点划分数据
- 用训练集求参数;用验证集比较模型族、λ及其他开发选择
- 固定最终模型和处理流程后,用独立保留的测试集估计目标分布上的表现
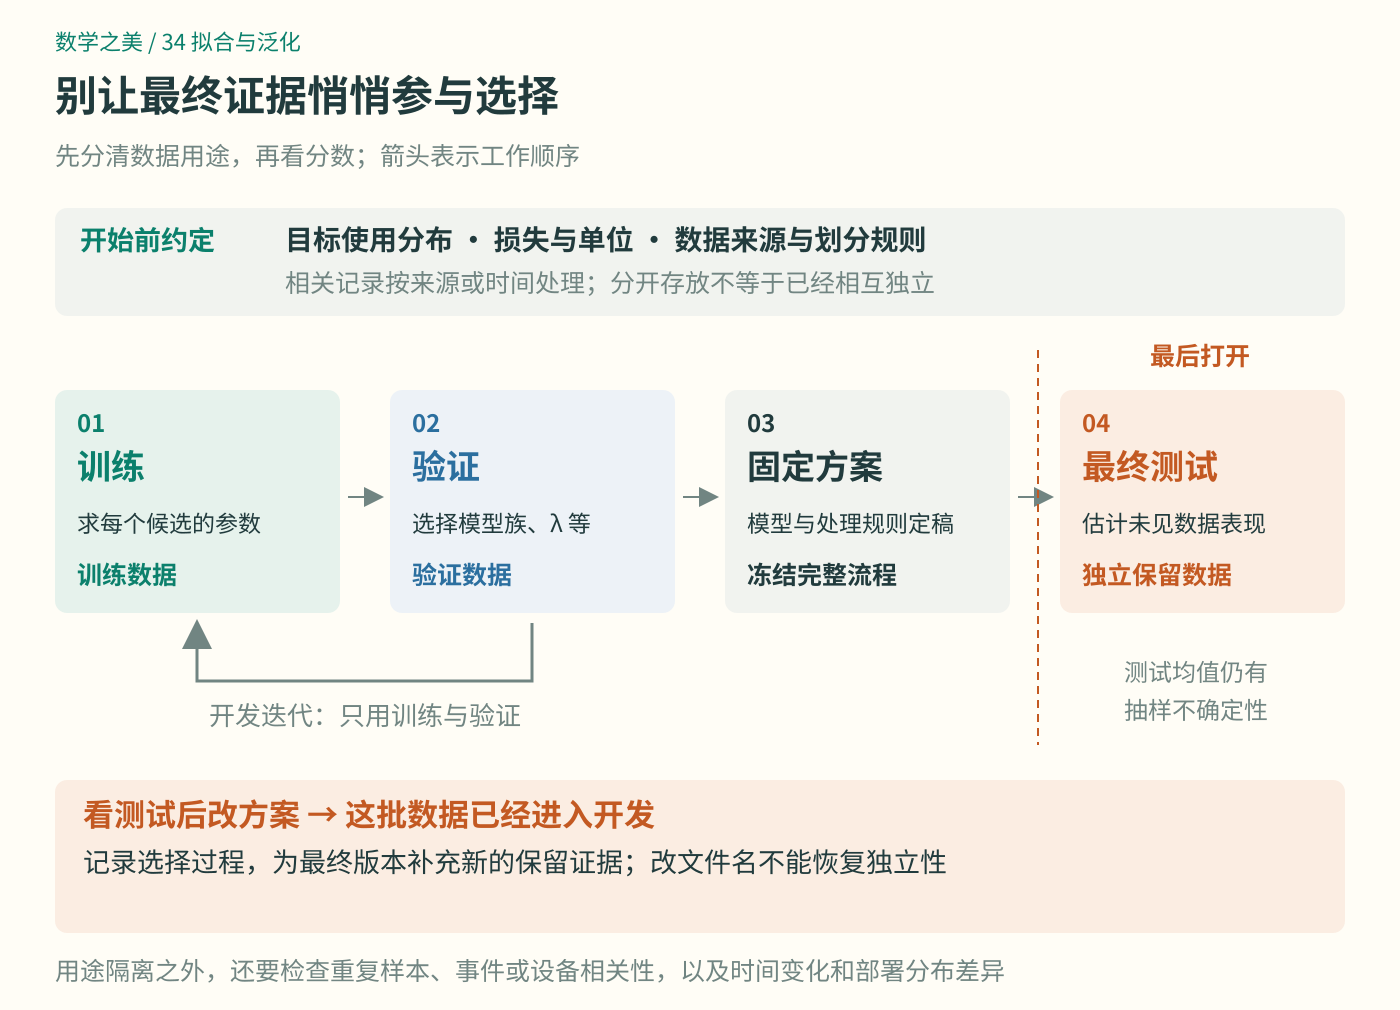
图3:这是数据用途的时间线,不是必须采用某个百分比分割的规定。训练与验证之间可以迭代;最终测试要与这些选择隔离。
隔离应覆盖整条流程。例如用数据求标准化所需的均值时,应在相应训练部分求出,再原样用于验证和测试,不能先看全部数据确定处理规则,随后才声称“测试从未用过”。
如果反复看测试分数,再改模型、改λ,甚至只改报告哪个指标,这批数据就参与了选择,不再是对最终方案未使用过的证据。换个文件名不能恢复独立性,应记录开发过程,为新版本保留新的评估证据。验证集被反复尝试同样可能受到过度适应,不能无限试到满意就止步。
即使用途分开,仍须检查重复记录、同一设备或事件造成的相关性,以及随时间变化的分布。预测未来时,按时间保留后段数据往往更贴近任务,但不自动消除相邻记录的联系。测试均值也只是有抽样不确定性的估计;若部署环境不同,漂亮的旧分数不能替新环境作保证。
优化完成以后,还有两道核查
这一部从“怎样定义错误”出发,经由变化率与梯度,走到了怎样找到目标的好解。现在回到三点,我们知道训练全局最优只对选定数据、模型和目标负责;是否适用于未来,需要概率模型与独立证据接着回答。
还有一道问题尚未处理:这些推导默认在实数中精确计算。计算机却用有限位存数,1/6、7/6这样的量怎样表示,微小误差又会怎样传递?第35章将进入有限精度,让已经清楚的数学问题接受计算过程的检验。
顺手试一下
题目1:有偏就一定更差吗? 固定某个x,设f*(x)=2厘米,测试噪声等概率取−1/2、1/2厘米。学习方法A在重抽训练集后,等概率预测1或3厘米,且预测与测试噪声独立;方法B始终预测3/2厘米。分别求两者的偏差、方差和期望平方误差。
**提示:**先求E[T],再使用三项分解;也可以列出所有预测与读数的组合。
**参考答案:**A的均值为2,偏差0,方差1平方厘米,噪声方差1/4,风险为5/4平方厘米。B的偏差为−1/2厘米,偏差平方1/4,方差0,风险为1/2平方厘米。因此在这个模型中,有偏的B反而风险更小。零偏差没有同时保证低方差。
题目2:正则化后的“最佳”,是哪一道题的最佳? 对三点模型取λ=2,核算新解与C的训练SSE和J₂。若有人看测试结果后反复改λ,最终报告最小测试分数,是否仍可视为未参与选择的评估?
**提示:**新解为(1/4,17/12);惩罚项为2a²,别把它漏掉。
**参考答案:**新解的SSE=7/24,惩罚为1/8,故J₂=5/12;C的SSE=1/6,惩罚为1/2,故J₂=2/3。新解训练拟合更差,却在新目标下更优,两者不矛盾。反复据测试改λ已使测试参与开发,最后的最低分不能冒充未用证据;应固定方案,再以新保留数据评估,并检查来源、相关性和目标分布。
参考与延伸
[1] Gareth James、Daniela Witten、Trevor Hastie、Robert Tibshirani,《An Introduction to Statistical Learning》,作者官网提供的第一版第七次印刷PDF,§2.2.2,书页33—36,式(2.7)。核对固定输入处、重复训练意义下的平方风险分解;正文用第21章的期望工具独立展开交叉项。
[2] 卡内基梅隆大学36-350课程,Lab 9,Part 2: Ridge Regression。核对平方和加斜率平方惩罚、截距不受惩罚的目标形式;尺度问题另核对上述教材§6.2.1,书页215—217。本文三点解另行推导。
[3] Google官方《Machine Learning Crash Course》,Datasets: Dividing the original dataset。核对训练、验证、测试的分工,反复使用测试数据、重复样本与真实使用分布改变的风险。
本文三点拟合、新读数、有限概率例、练习与图解均为原创教学编排,不是真实装置或学习系统的评测报告。
作者:Jiancheng Wang · 数学之美(独立原创)