先修:16 秩与零空间;30 导数与局部线性近似;35 有限位数与浮点表示
上一章解释了实数怎样落到有限的机器格点上。接下来很容易产生一个猜想:只要机器多保留一些位,答案就会可靠。可是,如果输入原本来自测量,计算机收到的数已经带着不确定性呢?即使后面每一步都按实数精确计算,答案仍可能对这点变化非常敏感。
本章先暂时拿走计算机,只用能手算的分数,研究“数据稍微变了,精确答案会变多少”。这叫问题的条件性。算法在有限精度中怎样完成计算,是另一层问题,第37章再展开。[1]
两个几乎挨在一起的读数
我们重新设计一组虚构教学数据,不把它当成真实实验。选定单位并把读数写成无量纲数,两个输入位置为x₁=1、x₂=1+ε,其中ε>0;对应读数为y₁=1、y₂=1+ε。这里ε表示观测位置的间距,与上一章机器格式中的epsilon无关。
要求直线y=ax+b精确经过这两点,就有
a+b=1, a(1+ε)+b=1+ε。
两式相减,εa=ε,所以a=1、b=0。这一次拟合恰好就是y=x。
现在固定两个输入位置和第一个读数,只把第二个读数增加δ。新斜率ã满足
ã=[(1+ε+δ)−1]/ε=1+δ/ε。
因此斜率的变化精确等于δ/ε,截距变为b̃=−δ/ε。取
ε=10⁻⁶,δ=10⁻⁸,
就得到ã=1.01、b̃=−0.01。第二个读数只从1.000001变成1.00000101,斜率却增加了1%。输入读数的相对变化约为一亿分之一,参数的相对变化达到百分之一。
这里所有有限小数都可以当作精确分数,等式中没有舍入。因而,“换一个不会舍入的程序”也会得到这两组不同参数。放大来自问题本身:我们试图用两个非常接近的位置,辨认直线的倾斜程度。
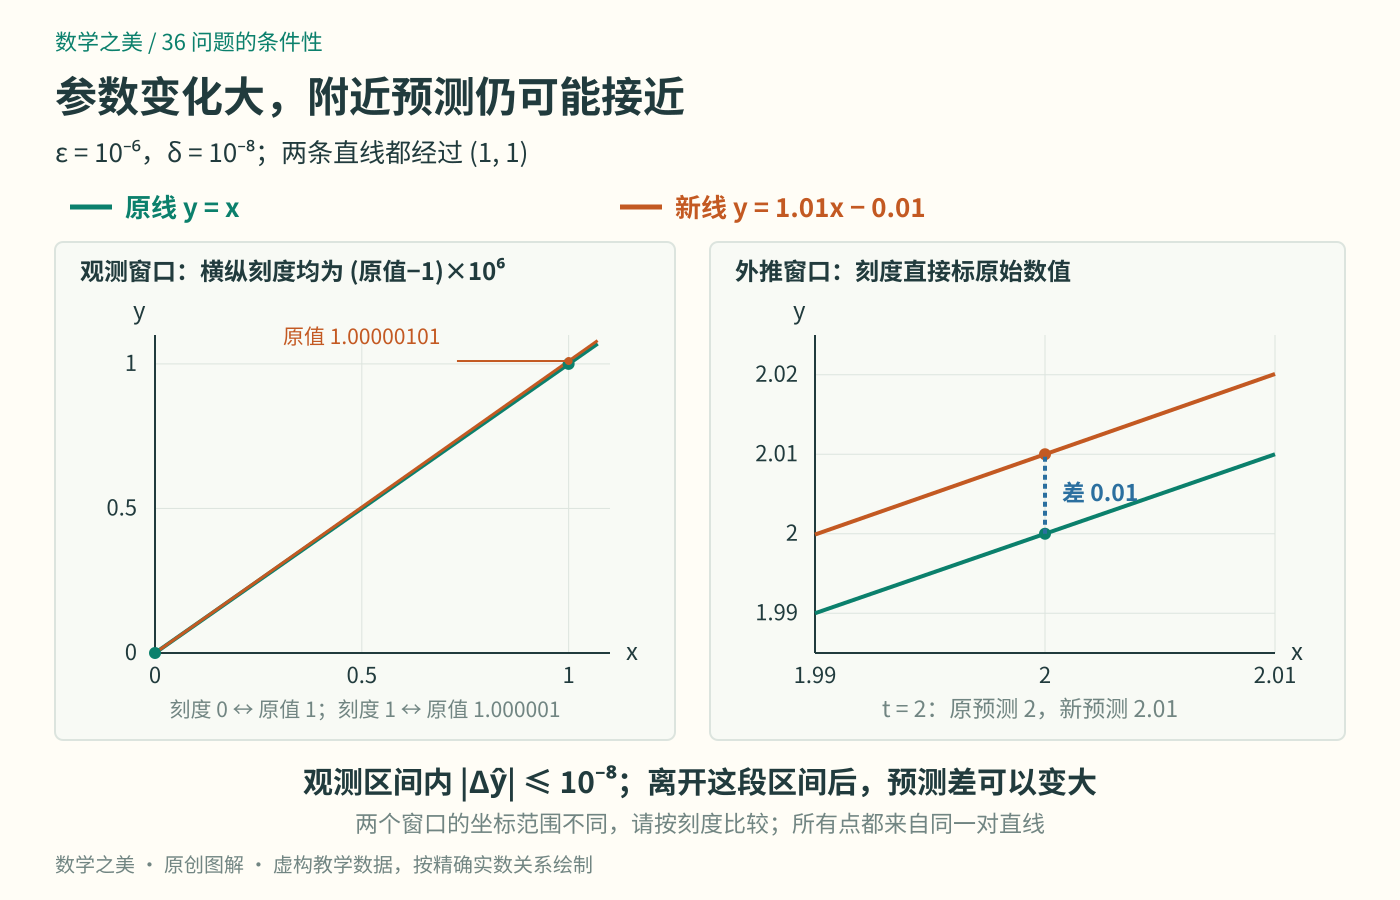
图1:两幅图的坐标范围不同。左图横纵刻度均为(原值−1)×10⁶,并标出与原始数值的换算;右图刻度直接使用原值。左图观测间距为10⁻⁶,右图查看距离第一个观测点约1的位置;右图不是把δ直接画大,而是画出相应的两条直线。
同一组参数变化,对不同用途的影响也不同。把预测位置另记为t,新旧预测之差是
Δŷ(t)=(δ/ε)t−δ/ε=δ(t−1)/ε。
在观测区间1≤t≤1+ε内,|Δŷ(t)|≤|δ|。虽然斜率变化了1%,这一小段内的预测最多只变10⁻⁸。到了t=2,差值就变成0.01;在离观测更远的地方还会继续增加。
所以,“斜率敏感”与“这段区间内的预测敏感”不是同一个问题。更不能据此保证外推符合真实世界:本例只比较两条假定的直线,没有证据证明真实关系在远处仍是直线。
接近退化,还没有退化
第16章讨论过精确的秩。这里设计矩阵的两列是(1,1+ε)和(1,1)。若它们的线性组合为零,就有
α+β=0,(1+ε)α+β=0。
相减得到εα=0。只要ε≠0,就必有α=β=0,两列仍然线性无关。对任意两个读数,公式a=(y₂−y₁)/ε、b=y₁−a都给出唯一的精确解。
当ε=0时,两个位置才真正重合。若两个读数都是1,只剩a+b=1,斜率与截距无法分别识别;若读数不同,则同一位置被要求同时具有两个值,没有精确解。
这条边界值得记牢:唯一解可以存在,却很难从有误差的数据中可靠确定。“几乎相同”不能直接套用“完全相同”的秩结论;反过来,满秩也没有承诺参数对扰动不敏感。
而且,并非每个方向的变化都会放大。如果两个读数同时增加δ,差y₂−y₁不变,斜率仍是1,只是截距增加δ。前面得到的1/ε,是固定位置与y₁、只改变y₂时,斜率绝对变化相对于该读数绝对变化的放大倍数。没有指定输入、输出、扰动方式和误差标尺,不能把它笼统叫作所有拟合问题的条件数。
先说明误差除以谁
设z是参考值,z̃是近似值。绝对误差定义为|z̃−z|;当z≠0时,相对误差定义为|z̃−z|/|z|。[2] 分母采用参考值,而不是悄悄换成近似值。若参考值未知,实际工作往往只能估计误差或给出范围,不能把无法知道的精确误差伪装成测得的数据。
绝对误差与原量具有相同单位,相对误差没有单位。它们回答不同的尺度问题。例如把长度从米改记为厘米,绝对误差的数字乘100,相对误差不变。不过,把数值的零点换掉会改变相对尺度,因而不能只凭一个百分比判断所有任务。
考虑固定常数1、只改变输入x的函数f(x)=x−1。它满足精确等式
f(x+h)−f(x)=h。
输出的绝对变化与输入一样大,绝对放大倍数始终为1。然而,取x=1.000001、h=0.00000001,原输出为0.000001,新输出为0.00000101。于是
输入相对变化=10⁻⁸/1.000001, 输出相对变化=10⁻⁸/10⁻⁶=0.01=1%。
没有额外产生一大块绝对误差;同一个10⁻⁸,被拿去与一个小得多的输出比较,所占比例就大了。
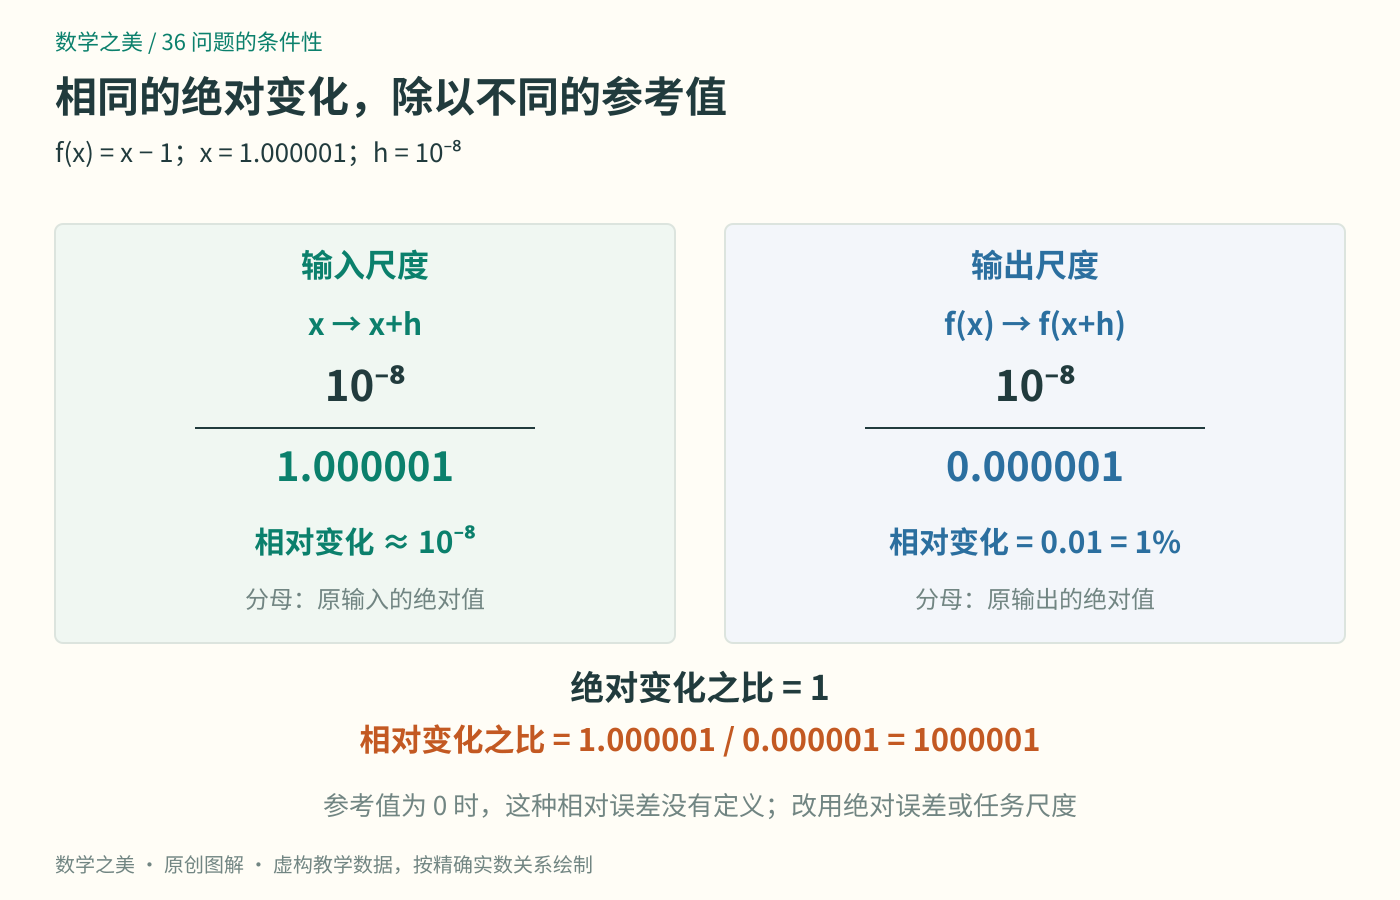
图2:两个相对变化的分子相同,分母不同。这里的1000001倍是两种相对变化之比,绝对变化的放大倍数仍然为1。
当x=1时,参考输出为0,以上相对输出误差没有定义,不能继续除以0。此时可以报告绝对变化,或按任务给出的非零尺度评估是否可接受。比如目标只是判断偏差是否小于某个容差,就应直接检验那项要求,而不是硬凑一个百分比。
用导数刻画局部的相对放大
上一章的ε或u描述机器表示的精度;现在需要一个描述数学问题的量。沿用第30章,若f在x附近有定义并在x处可微,就能写成
f(x+h)−f(x)=f′(x)h+r(h),
其中|r(h)|/|h|随h趋于0而趋于0。
再要求x≠0、f(x)≠0。对非零的小扰动h,输出相对变化除以输入相对变化为
[|f(x+h)−f(x)|/|f(x)|] ÷ [|h|/|x|]
=|x/f(x)| · |[f(x+h)−f(x)]/h|。
让h趋于0,差商趋于导数,于是得到本章使用的标量局部相对条件数
κ(x)=|x f′(x)/f(x)|。[3]
κ读作“卡帕”。它把输入和输出各自的参考尺度也纳入比较,刻画足够小的扰动在一阶上的相对放大。当κ很大时,常说这个问题在该输入处相对条件差;评价好坏还要结合输入精度与输出要求。
对刚才的f(x)=x−1,f′(x)=1,因此κ(x)=|x/(x−1)|。在x=1.000001处,κ=1000001。由于这个函数的余项恰为0,前面的相对变化之比精确等于这个数,不只是一阶近似。
一般函数却没有这个额外保证。κ是固定x、让扰动趋于0得到的局部量,不能自动当作任意大步的误差上界。如果扰动跨过了函数定义域的边界,甚至连新的函数值都未必存在。想要一整段区间的保证,需要另外控制那段范围内的变化。
κ也可以为0。例如g(x)=1+(x−1)²,在x=1处有g′(1)=0,且输入、输出都非零,所以κ(1)=0。但g(1+h)−g(1)=h²,只要h≠0,输出仍然变化。一阶项消失,只说明变化比|h|更快地缩小,并没有宣布对任何扰动都完全免疫。
把敏感性换成一个可用范围
前面比较两份数据时,“扰动”只是输入的改动,并不自动说明哪份是真值。只有指定可信的参考,才能把相应差异解释为误差。这在测量任务中尤其重要:屏幕多显示几个小数位,并不会替我们选出参考真值。
继续用ε=10⁻⁶。假设报告的读数为y₂=1.000001,且额外知道它与真实读数的绝对差不超过10⁻⁸;仍假定位置和第一个读数完全准确,直线模型完全成立。真实的第二个读数就可能落在
[1.00000099,1.00000101]。
把区间两端分别代入精确斜率公式,会得到0.99与1.01。因此所有与这份信息相容的斜率形成[0.99,1.01]。再准确的除法,也无法只凭现有信息排除其中任意一个值。报告中心值1并附上这段范围,比把1后面继续写零更符合已知证据。
这是一种信息限制:若两种真实情形都能产生同一份带有容差的记录,程序收到的输入相同,就无从凭计算判断真实世界采用了哪一种。增加有效位数可以更准确地处理这份记录,却不能区分记录没有区分的情形。
不过,上述区间依赖全部假设。如果位置也不确定,分母会跟着改变;如果两个读数都有误差,分子会包含两项变化;如果模型不再是直线,单靠两点公式就无法代表目标关系。条件分析的第一步,应当说明哪些量允许变化、它们能变多少,而不是先找一个很大的数来吓自己。
精确问题与数值求解要分两层检查
现在把计算机放回来。设理想输入为x,实际拿到的是x+h;对这份实际输入,精确答案是f(x+h),程序给出的结果记作q。便有精确拆分
q−f(x)=[f(x+h)−f(x)]+[q−f(x+h)]。
第一项比较两份不同数据的精确答案,属于问题的敏感性。第二项固定实际输入,比较计算结果与它应有的精确答案,需要检查算法及其实现。两项可能同号,也可能抵消,不能把绝对值直接写成两项绝对值之和。
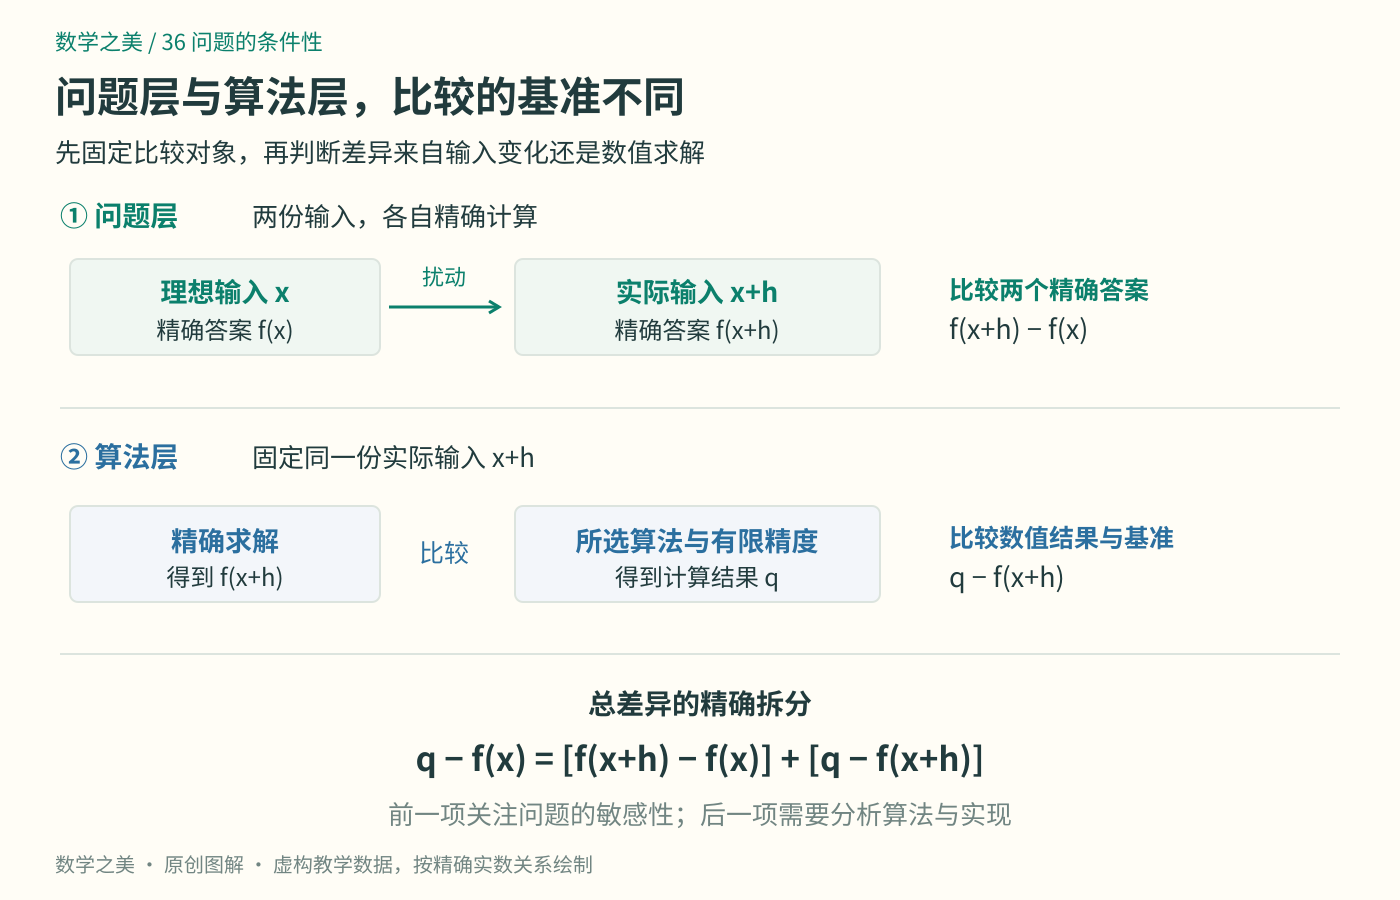
图3:先说清楚基准是谁,才能判断差异来自哪里。条件性与算法稳定性分别检查不同的关系;本章没有据此判定某个具体算法稳定。
真实输入可能包含仪器测量、采样以及上游估计带来的不确定性。提高计算精度,能够减少某些表示和运算误差,却无法凭空找回没有记录下来的真实读数。把1.00000101打印成更多位,不能告诉我们第二个观测原来究竟偏了多少。
在两读数模型中,如果已知只有y₂存在不超过η的误差,就可以直接报告斜率误差不超过η/ε。若模型在更宽范围仍然适用,拉开观测位置会减小这个特定放大倍数;若只能使用原位置,就应诚实保留参数的不确定范围。改写参数单位也许使数字更顺眼,但不会自动补回缺失的信息。
条件差本身不能证明程序有缺陷,条件好也不能保证随便写一种算法都算得可靠。下一章会用一个对输入相当温和的函数说明:即使数学问题本身不敏感,计算路径仍可能把答案弄坏。
顺手试一下
题目1: 两个位置为1和1.0001,原读数也分别为1和1.0001。仅给第二个读数增加2×10⁻⁸。求新斜率、截距,以及在t=1.00005和t=2处的预测变化。若两个读数都增加同样的量呢?
**提示:**ε=10⁻⁴;先求δ/ε,再用Δŷ(t)=δ(t−1)/ε。
**参考答案:**δ/ε=0.0002,所以新斜率为1.0002,截距为−0.0002。两个位置的预测变化分别为0.0002×0.00005=10⁻⁸和0.0002。如果两个读数同时增加2×10⁻⁸,斜率仍为1,截距变为2×10⁻⁸,任意t处预测都增加2×10⁻⁸。
题目2: 对f(x)=x−1,在x=1.01处施加h=0.0001。求输入、输出的绝对与相对变化,及κ(x)。为什么不能将相同的相对误差定义直接用于x=1?
**提示:**原输出为0.01;两个相对变化各用自己的原参考值作分母。
**参考答案:**输入、输出绝对变化均为0.0001。输入相对变化为0.0001/1.01=1/10100,输出相对变化为0.0001/0.01=1/100。二者之比为101,也等于κ(1.01)=1.01/0.01。x=1时输出为0,相对输出变化的分母为0,没有定义;绝对变化仍可直接计算为|h|。
参考与延伸
[1] Lloyd N. Trefethen、David Bau,《Numerical Linear Algebra》,Part III: Conditioning and Stability。SIAM公开摘要明确区分数学问题的条件性与算法的稳定性;本文只引用该公开定义,不声称读取付费正文。
[2] 康奈尔大学,David Bindel,CS 6210讲义,Matrix calculus, sensitivity, conditioning,2025年8月27日,“Absolute and relative error”与“Dimensions and scaling”节。核对误差的参考分母、零值边界和量纲要求。
[3] Tobin A. Driscoll、Richard J. Braun,《Fundamentals of Numerical Computation》,Problems and conditioning,1.2.1节。核对标量相对条件数的极限定义;本文用第30章的可微条件独立推导公式,并明确局部适用范围。
本文数据与三幅图均为原创教学构造,有限小数按精确有理数复算;未进行真实测量,也未把这些算例当成具体软件的误差测试。
作者:Jiancheng Wang · 数学之美(独立原创)