先修:19 条件概率;21 期望;23 可信评估;24—27 编码、熵、交叉熵与KL散度
前几章一直在给A、B、C、D编码。现在暂时收起码表,换一个问题:下一个符号还没出现,若已经拿到一条有用线索,我们的预测能改善多少?
“知道得更多”听起来总是好事。但更多线索究竟改变了什么?是每次都更确定,还是平均更确定?理论上可以利用,与实际模型已经利用好,又差多远?本章从同一组四符号出发,把这几句话逐一分开。
先收到一个标记
仍设Y取A、B、C、D,概率依次为1/2、1/4、1/8、1/8。第26章已算出H(Y)=1.75位。
现在假设预测之前,已有一个获准使用的分组标记X:X=0表示Y属于{A,B},X=1表示属于{C,D}。这里只把“提前得到标记”作为教学条件,不假装它免费,也不假装现实中总能获得。
一种可实现的情景是:发送方已经知道完整符号,先把所属组通知给接收方;接收方此时只知道组别,仍要预测组内是哪一个。这里减少的是接收方的不确定性。若改成预测一个尚未发生的结果,能否提前取得如此准确的组别,就需要新的实际依据。
两组概率分别为3/4与1/4。沿用第19章的重新归一化:已知X=0时,A、B的概率成为(1/2)/(3/4)=2/3与1/3;已知X=1时,C、D各占1/2。
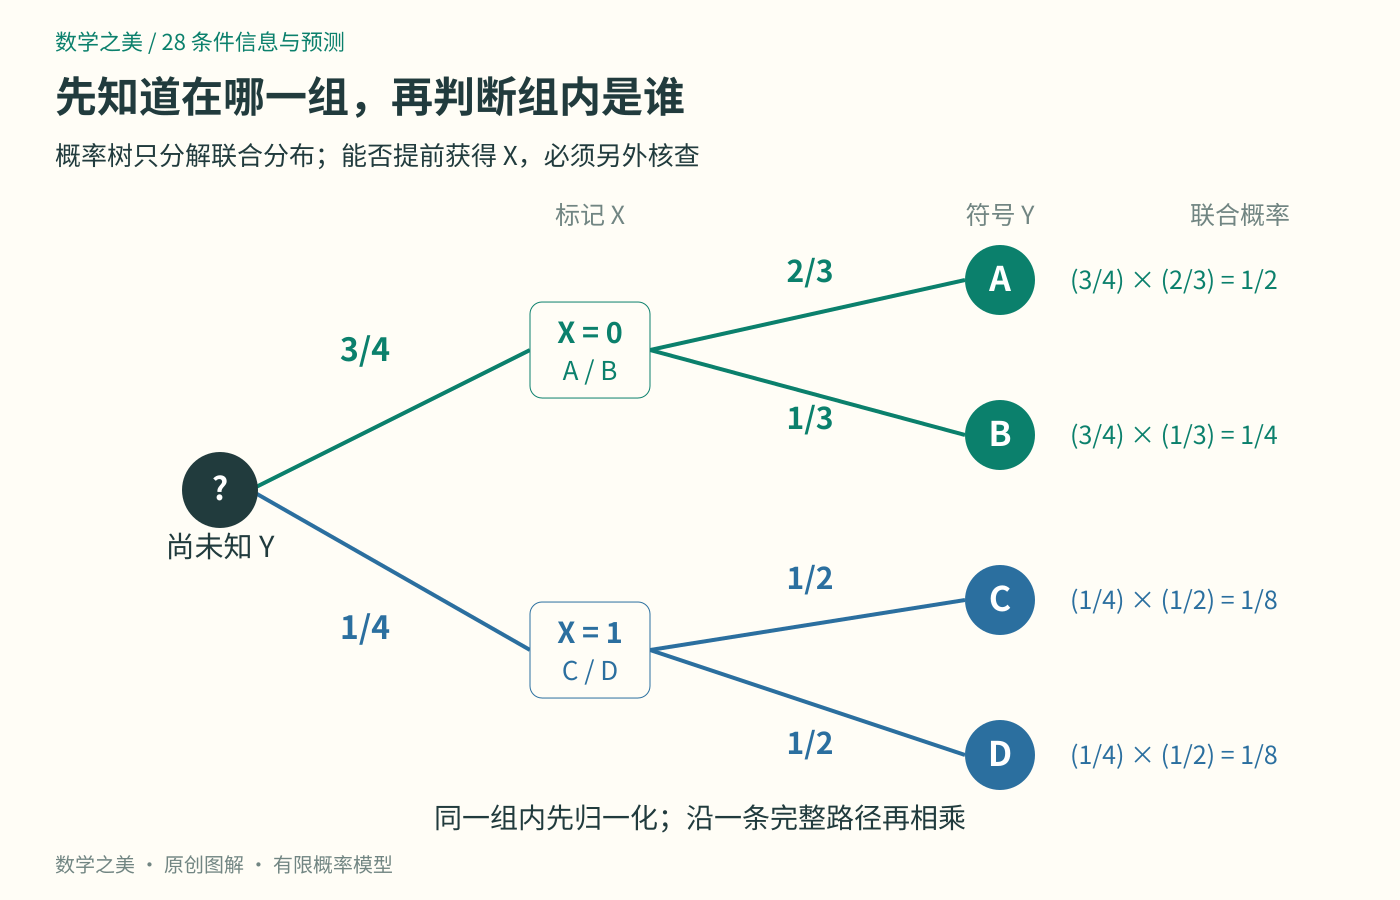
图1:第一层写标记概率,第二层写条件概率;叶子写两者乘积。箭头表示概率分解,不证明现实中的因果顺序或信息取得方式。
为什么要强调“提前”?如果先读到正确答案Y,再给它补上这个组别,把补写的X当成预测时的输入,就发生了标签泄漏。表上的联合概率依然可以完全正确,但被评估的已不是那个尚不知道答案的预测任务。必须另查X何时产生、当时能否取得。3
先在组内算熵,再平均
对每个P(X=x)>0的取值x,记pₓ=P(X=x),p(y|x)=P(Y=y|X=x)。先计算该组分布的熵:
H(Y|X=x)=−Σᵧp(y|x)log₂p(y|x)。
再按遇到各组的概率加权,定义条件熵:1
H(Y|X)=ΣₓpₓH(Y|X=x)。
这里外层只对pₓ>0的组求和,不给零概率条件硬做除法;内层的零项仍沿用前章约定。H(Y|X=x)是某一个条件下的熵,H(Y|X)则是所有条件的加权平均。少写一个“=x”,问的问题已经不同。
令h₂(t)=−tlog₂t−(1−t)log₂(1−t),其中0≤t≤1,零项沿用0log₂0=0的约定。它表示概率为t与1−t的二元熵。于是本例有
H(Y|X=0)=h₂(1/3)≈0.918296;
H(Y|X=1)=1;
H(Y|X)=(3/4)h₂(1/3)+(1/4)×1≈0.938722位。
第一组里,A的信息量是log₂(3/2),B的信息量是log₂3。乘上各自的条件概率再相加,才得到0.918296。虽然两组都剩两个候选,第一组偏向A,第二组完全均匀,所以它们的熵并不相同。只数“还剩几个选项”,仍会漏掉概率如何分配。
不能把两个组的熵直接各算一半:第一组出现三倍多,应该占三倍权重。与原来的1.75相比,平均剩余不确定性少了约0.811278位。
这也不是“猜对概率增加了81.1278%”。若每次只选概率最高的一个符号,不看X时总选A,猜对概率为1/2;看X后,在第一组选A,第二组选C或D,猜对概率为(3/4)×(2/3)+(1/4)×(1/2)=5/8。准确率提高了12.5个百分点,与用位计量的熵减少量是不同的数。
这里也没有把结果的“重要程度”编码进去。一次医疗判断与一次字母预测即使具有相同的概率表,也会得到相同的熵;后果和价值需要另外定义。这个数回答的是指定概率模型中的信息问题。
一起描述,与分两步描述
现在把(X,Y)当成一个联合结果,定义联合熵
H(X,Y)=−Σₓ,ᵧp(x,y)log₂p(x,y)。
第19章的乘法规则给出p(x,y)=pₓp(y|x)。在正概率项上,对数把乘积拆开,因此
H(X,Y)
=−Σₓ,ᵧp(x,y)log₂pₓ+log₂p(y|x)
=−ΣₓΣᵧp(x,y)log₂pₓ
−ΣₓpₓΣᵧp(y|x)log₂p(y|x)
=H(X)+H(Y|X)。
倒数第二步里,Σᵧp(x,y)=pₓ;第二部分则正是刚刚定义的条件熵。这叫熵的链式法则:联合的不确定性,可以拆成先描述X、再描述已知X后剩余的Y。1
可以先对单个联合结果理解这一步:要说清“落在哪组、组内是谁”,路径概率是两段概率的乘积,信息量便是两段负对数的和。再对全部路径加权,才得到上面的平均账。这与第21章期望的线性性一致,不能反过来把“可以相加”误当成已经证明独立。
它不要求X、Y独立,也不表示必须按这个时间顺序产生。交换两者,同样得到H(X,Y)=H(Y)+H(X|Y)。
本例知道Y就能确定所属组,所以H(X|Y)=0,H(X,Y)=H(Y)。而X的概率为3/4、1/4,H(X)≈0.811278。两个数相加:
0.811278+0.938722=1.75。
若完整传输还要包含标记,消失的那一部分就回到账上。原来关于Y的区别,一部分写在X里,一部分留在组内,并没有凭空少掉。
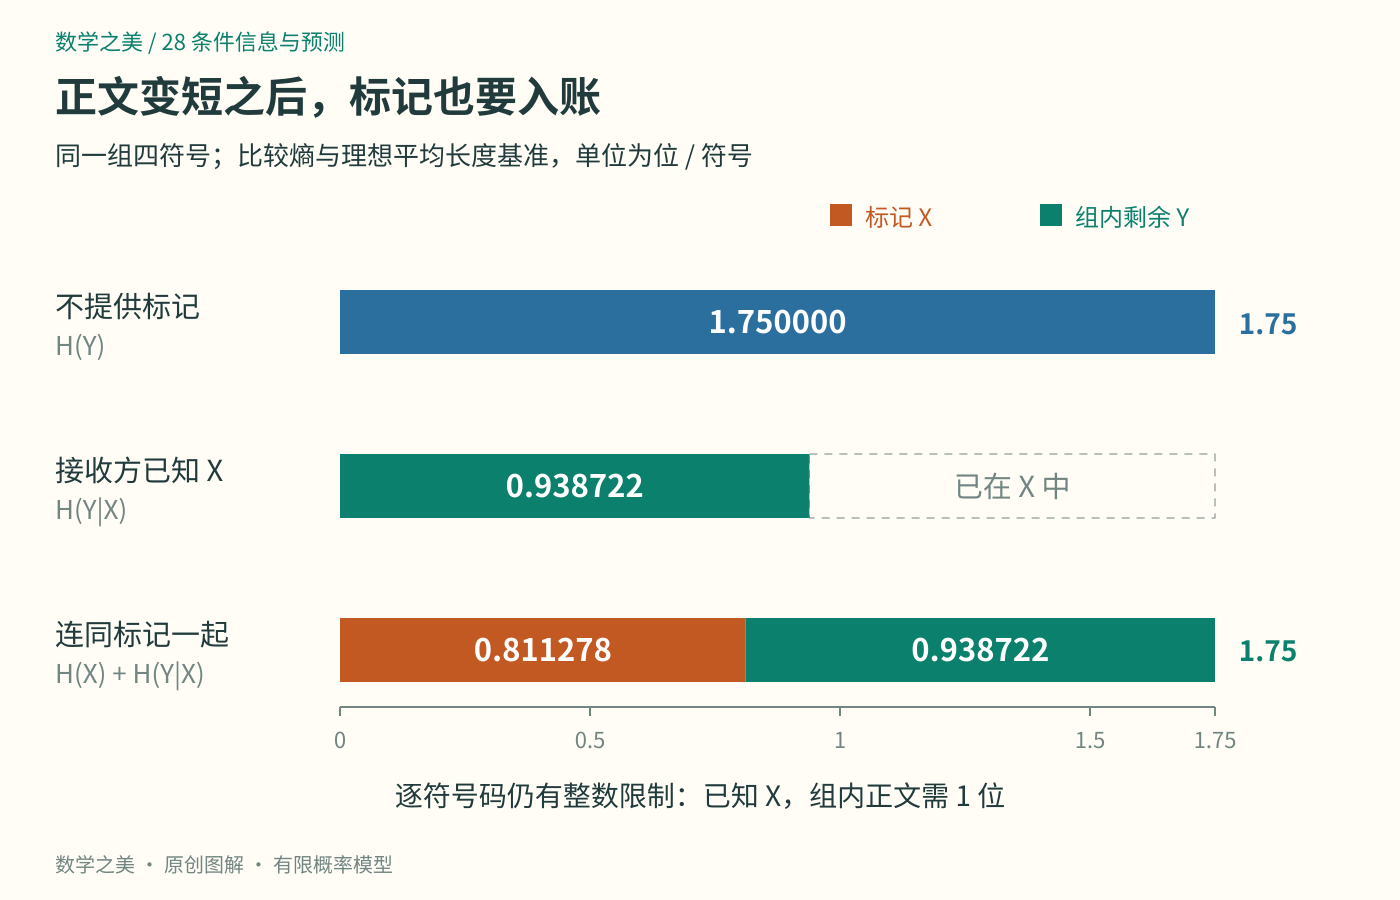
图2:条长按同一比例绘制,比较熵与理想平均长度基准,不是某段实际文件的位数。四符号例里X由Y确定,因此两部分恰好拼回H(Y)。
压缩时还得记住第26章的整数码长。若收发双方已知X,每组只剩两个正概率符号,用0、1区分即可,实际逐符号正文平均仍需1位,并非0.938722位。若标记也逐个用一位发送,总共就是2位,反而超过原码表的1.75位平均正文。
条件熵提示更充分编码时的基准;独立重复、分块编码等条件合适时,可以分摊整数余量。完整方案仍须计入标记、码表、边界与封装成本。“接收方已经知道”是一项共享条件,不能一边借用它省正文,一边忘掉建立它的费用。
平均减少为什么一定非负
我们把减少量定义为互信息:
I(X;Y)=H(Y)−H(Y|X)。
这里I(X;Y)有两个随机变量作为对象,不是第25章按一个事件概率计算的自信息I(p)。
先别凭直觉断言它非负。令pᵧ=P(Y=y),并用p表示这组边缘概率构成的分布。将H(Y)中的pᵧ写成Σₓpₓp(y|x),再把两个熵相减:
I(X;Y)
=ΣₓpₓΣᵧp(y|x)log₂p(y|x)/pᵧ
=ΣₓpₓD(p(·|x)∥p)。
p(·|x)中的圆点表示整组关于y的条件分布,D仍是前章的KL散度。只要pₓp(y|x)>0,边缘概率pᵧ也必为正,因此这里没有正概率除以零的问题。这个式子把互信息变成若干KL散度的加权平均。第27章已经证明每个KL非负,所以I(X;Y)≥0,也就是H(Y|X)≤H(Y)。2
什么时候恰好没有减少?有限模型中,正权重下的非负项之和为0,要求每项都为0。由KL的等号条件,对每个正概率x都必须有p(y|x)=pᵧ。乘以pₓ便得到p(x,y)=pₓpᵧ;对pₓ=0的组,两边也都为0。因此等式对所有x、y成立,恰好是X、Y独立;反过来独立也使每项为0。
这个等号条件比“平均差不多”严格。只要有一个正概率组里的完整分布与原来不同,对应的KL便为正,平均互信息就严格为正。反之,增加一个完全独立的随机标记,哪怕它自身每次都难猜,也不会减少关于Y的不确定性。信息是否有用,总是相对于所问的目标。
另一端也能检查:各组的熵非负,所以I(X;Y)≤H(Y)。若每个正概率组都只剩一个可能结果,就有H(Y|X)=0,全部不确定性都被消除了。最极端的例子是直接令X=Y,互信息便等于H(Y)。数学上这完全合法,实践上却再次要求问:答案为什么会提前出现在输入里?“信息量很大”本身不能给特征的来源与使用时机作担保。
再用链式法则改写,有I(X;Y)=H(X)+H(Y)−H(X,Y)。右边交换X、Y不变,所以互信息对称。它度量两者共同关联的部分,并不能据此判定谁造成谁;上一章KL通常不对称,也与此没有冲突。
平均更确定,不等于每次都更确定
另设一个小例子,不再使用四符号Y。标记X有“常见”和“罕见”两种,概率为0.98、0.02。常见组的Y恒为0;罕见组的Y取0、1,各有一半概率。
不看标记时,P(Y=1)=0.02×0.5=0.01,故H(Y)=h₂(0.01)≈0.080793位。原本几乎总能猜0;突然得知处于罕见组,结果却变成五五开,H(Y|X=罕见)=1,比原来大得多。
但把两组重新按概率加权:
H(Y|X)=0.98×0+0.02×1=0.02位,
仍小于0.080793。于是I(X;Y)≈0.060793位。一个具体条件能让原先的偏向消失,同时绝大多数条件让结果完全确定;平均不等式没有被违反。
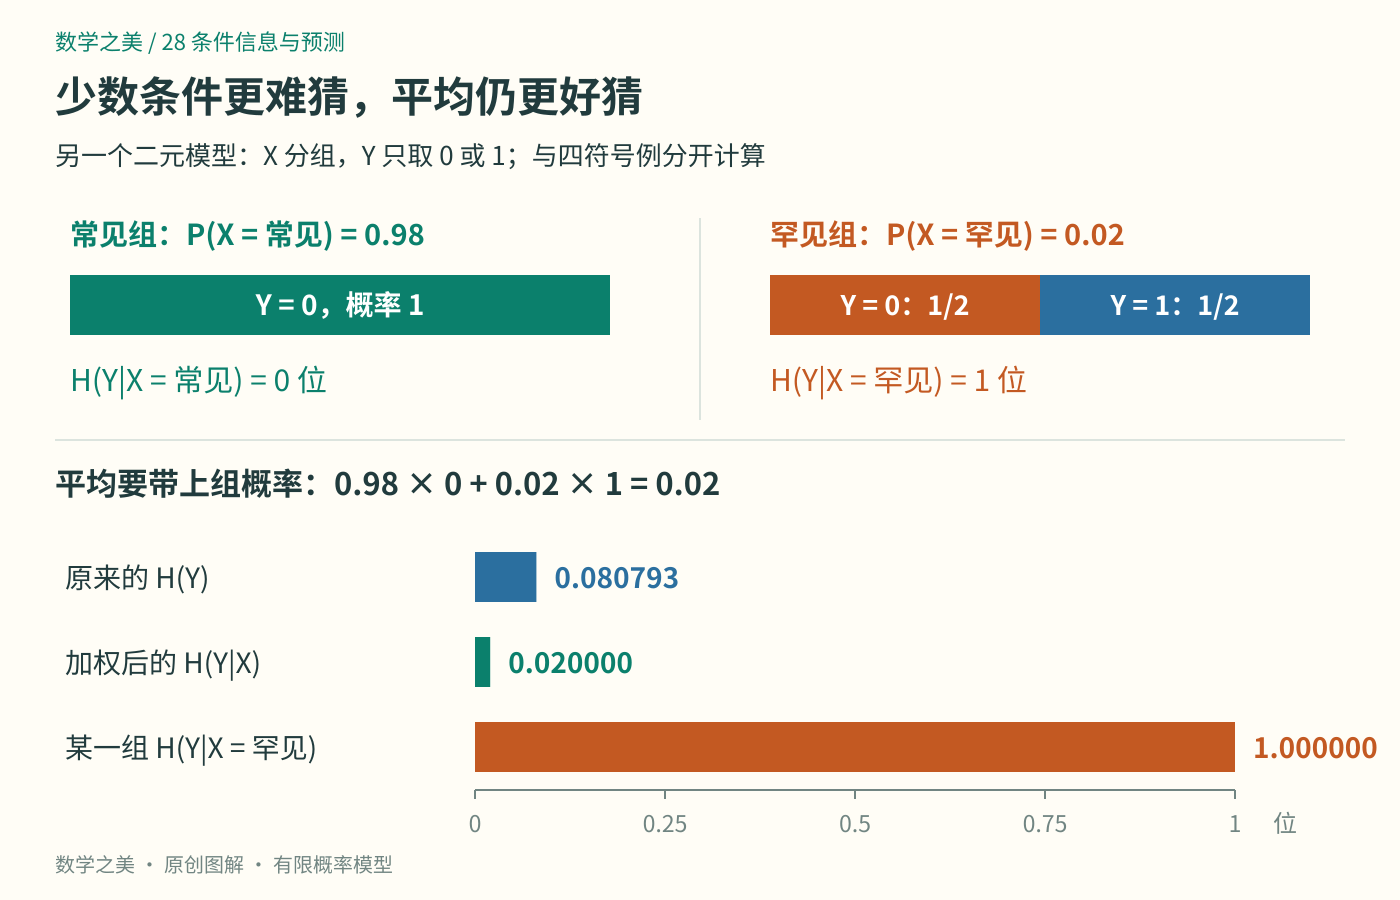
图3:长条表示熵,不表示该组的出现概率;组概率另行标出。不能把罕见组的1位,误当成条件熵H(Y|X)的整体值。
真正的模型还会猜错概率
有了X,不等于模型知道真实的p(y|x)。假设模型输出q(y|x),一次预测的对数损失为−log₂q(Y|X)。对真实联合分布求期望,在每个组内使用第27章的分解,再对组加权,得到
Eₚ−log₂q(Y|X)
=H(Y|X)+ΣₓpₓD(p(·|x)∥q(·|x))。
支持集与零概率条件沿用第27章。第一项是给定这些线索后的剩余不确定性;第二项是模型没有猜准条件分布而多付的代价。降低第一项的机会,不会自动替我们消掉第二项。
为什么这里还要按真实的pₓ加权?因为损失问的是部署时实际会遇到哪些情形。若为了训练方便,把两组各采一半,然后不加区分地报告这批数据的平均损失,评估的组别权重便已经变了。即使每组内部预测完全一样,合并分数也未必回答原来四符号来源上的问题。
即使加入的线索确实有用,有限样本、受限模型或不合适的训练方法,也可能让实际失配更大。理论上的“最优者可以忽略多余输入”,要求允许这样做且确实找到最优者;它不保证某次训练得到的模型更好。训练损失下降,也不等于真实分布的条件熵下降。
评价时还要把期望与样本平均分开。固定模型后,对n条记录计算
L̂=−(1/n)Σᵢlog₂q(yᵢ|xᵢ),
得到的是这批数据的经验损失。要用它判断未来表现,应像第23章那样,预先明确目标分布和记录单位,在未参与训练或方案选择的数据上评估,并检查来源、依赖和时间变化。保留测试集不能保证它代表未来,按时间切开也不能自动证明样本独立。
实际核查可以从每条记录的时间线做起:先写“必须在几点给出预测”,再列当时已入库、能被系统读取的字段,最后单独存放事后核验的标签。字段名称看起来像历史信息还不够,它的生成时间、修改时间和实际可读取时间可能不同。评估应复现当时能看到的版本。
尤其要检查每项输入在预测时刻是否已经可用。未来发生的维修结论、事后补齐的组别,即使只是答案的粗略函数,也可能泄漏。预处理与特征选择若利用了最终测试数据,同样破坏评估隔离。3
比较两个文本模型时,还必须检查分词方式,也就是怎样把文本切成token。每token交叉熵的分母随切分规则改变,数字不能直接横比;应在相同目标材料、可比的计量单位和计分规则下比较。更低的对数损失也不是所有任务指标都会改善的承诺,作决策时仍要说明错一次的代价。
本部从“能否无损表示”走到“概率预测要付多少平均代价”,连接这些问题的是明确的概率、对数与求和。现在我们能写出目标,也能区分理论基准、模型失配与评估证据。接下来还有一件事:怎样选择合适的损失,并实际把它降下来?第29章进入损失函数与优化。不同目标仍需分别论证,不能因为都写成一个数,就当成同一个问题。
顺手试一下
题目1:有标记,却把组内概率猜反
在四符号例中,模型对X=0预测A、B的概率为1/3、2/3,对X=1仍预测C、D各1/2,其余符号概率为0。求真实期望对数损失;与最优条件预测、完全不看X但使用真实p的预测分别比较。
**提示:**先算第一组的KL。比值为2与1/2,所以两个对数分别为1与−1,再乘组权重3/4。
**参考答案:**第一组KL=(2/3)×1+(1/3)×(−1)=1/3,第二组为0。平均失配代价为(3/4)×(1/3)=1/4位。因此损失约为0.938722+0.25=1.188722位,比最优条件预测多0.25位,仍比不看X的1.75位少约0.561278位。有信息与用准信息是两件事。
题目2:新加一枚独立硬币
Y仍服从四符号分布。现在不用分组标记,而给预测者一枚与Y独立的公平硬币结果Z。求H(Y|Z)、I(Z;Y)和H(Z,Y)。若某次训练加入Z后测试分数略有改善,能否据此宣称Z在该模型中提供了关于Y的信息?
**提示:**独立意味着两个条件分布都等于原分布。将理论模型与某批样本的分数分开。
**参考答案:**H(Y|Z)=1.75,I(Z;Y)=0;H(Z,Y)=H(Z)+H(Y|Z)=1+1.75=2.75位。该概率模型中,Z不提供关于Y的信息。某次分数的小幅变化可能来自抽样或训练过程变化;不能用它推翻已设定的独立性。现实中若独立性本来只是假设,可以另收集合适证据检查,但不能把同一批测试数据反复用来挑选支持结论的方案。
参考与延伸
1 MIT 6.441,Muriel Médard,Lecture 1: Introduction,第3—4、6页。核对条件熵的加权定义、链式法则与互信息的等价表达。
2 MIT 6.441,Yury Polyanskiy、Yihong Wu,Chapter 2: Information Measures: Mutual Information,§2.2—2.3,书内第21、23—24页。核对平均KL、非负与独立的等号条件,以及平均条件熵与特定条件的区别;本文沿用前章初等工具展开证明。
3 scikit-learn开发团队,Common pitfalls and recommended practices,§12.2。核对预测时不可得信息、预处理与特征选择中的数据泄漏。
本文四符号模型承接前章;二元反例、练习、图解与叙述均独立编排,数值来自明确的有限概率模型,不是真实系统评测。
作者:Jiancheng Wang · 数学之美(独立原创)