先修:16 列空间、秩与零空间;17 最小二乘与投影;30 导数与极限;32 梯度与下降
上一章教我们沿负梯度试着降低损失。如果最后梯度变成零,能否宣布已经找到最好答案?第30章的t³已经提醒过我们:驻点连局部最小都未必是。计算程序停止,也可能只是改变量低于阈值,或者步长不合适。
把问题问得更强一点:假如我们确实证明了附近没有更好的点,远处会不会还藏着更低的值?本章研究一种能排除这种担忧的结构:可行域是凸集,目标是凸函数。在这些条件下,任何局部最小点都是全局最小点。关键证据是一条线段,而不是一张看起来像山谷的图。
局部与全局分别比较谁
把允许选择的点组成集合C,称为可行域。x是全局最小点,指它属于C,而且对所有y∈C都有f(y)≥f(x)。
局部最小则只要求:存在一个半径ρ>0,使每个满足y∈C、‖y−x*‖<ρ的点都有f(y)≥f(x*)。这里‖y−x*‖表示坐标空间中的欧氏距离。“局部”始终相对于可行域;邻域中不允许选择的点,无须参加比较。比较使用≥,因此并不排除其他点与它一样好。[1]
全局最小点当然也是局部最小点,因为它已经赢过更大的比较范围;需要证明的是反方向。另外,“最小点”是输入位置,“最小值”是它对应的输出。多个位置可能共享一个最小值,也可能有一个可以不断逼近的下界,却没有任何位置真正达到它。
这两个定义都在谈函数值,不是在谈算法行为。试过几个方向没下降,不等于已检查附近所有可行点;梯度数值很小,也不等于在精确数学意义上恰为零。
凸首先要求线段走得通
若任取x、y∈C,以及0≤t≤1,都有
(1−t)x+ty∈C,
就称C为凸集。这个点从t=0时的x,沿直线移动到t=1时的y;条件要求整条线段都留在集合里。[2]
区间、整个平面、填满的圆盘都是例子。只有圆周通常不行:取直径两端,连线中间不在圆周上。凸性检查的是集合包含哪些点,不是轮廓画得圆不圆。
在凸集C上,实值函数f称为凸函数,是指对任意x、y∈C和0≤t≤1,都有
f((1−t)x+ty)≤(1−t)f(x)+tf(y)。
左边先混合位置,再求函数值;右边先算两端的函数值,再按同一比例加权。图像的意思是:线段上位置对应的函数值,不高于两端函数值连成的弦。这里要求每一对端点、每一种比例都通过检查,不是抽几条弦看看。[2]
集合凸,保证中途的点可选;函数凸,保证这些点的值不超过弦。这是两个不同条件。例如f(s)=s²在整条实线上凸,但若只允许C={−1,2},两个孤立点各自都是相对于C的局部最小点,只有−1是全局最小点。不能把可行域的条件删掉。
凸函数也不必处处向上弯,更不必有碗底。例如f(s)=2s+1满足凸不等式中的等号,在实线上却可以不断向负方向降低。由定义判断凸性,比看到一张熟悉的抛物线更可靠;它描述一种比较关系,本身没有承诺最优解存在。
把远处的改进拉到眼前
现在证明核心结论。设C凸,f在C上凸,x是局部最小点,ρ是定义中的半径。假设它并非全局最小,那么存在y∈C,使f(y)<f(x)。
沿连接两点的线段取
zₜ=(1−t)x*+ty,
其中0<t<min{1,ρ/‖y−x*‖}。因为两点函数值不同,y≠x*,分母不为0。
C凸,所以zₜ可行。它与x的距离是t‖y−x‖<ρ,因此已经进入局部最小所管辖的范围。另一方面,函数凸给出
f(zₜ)≤(1−t)f(x*)+tf(y)
=f(x*)+t[f(y)−f(x*)]<f(x*)。
这与“附近所有可行点都不更低”矛盾。所以根本不存在那个更好的y,x必为全局最小点。证明没有使用导数,也没有要求x是可行域的内点。[2]
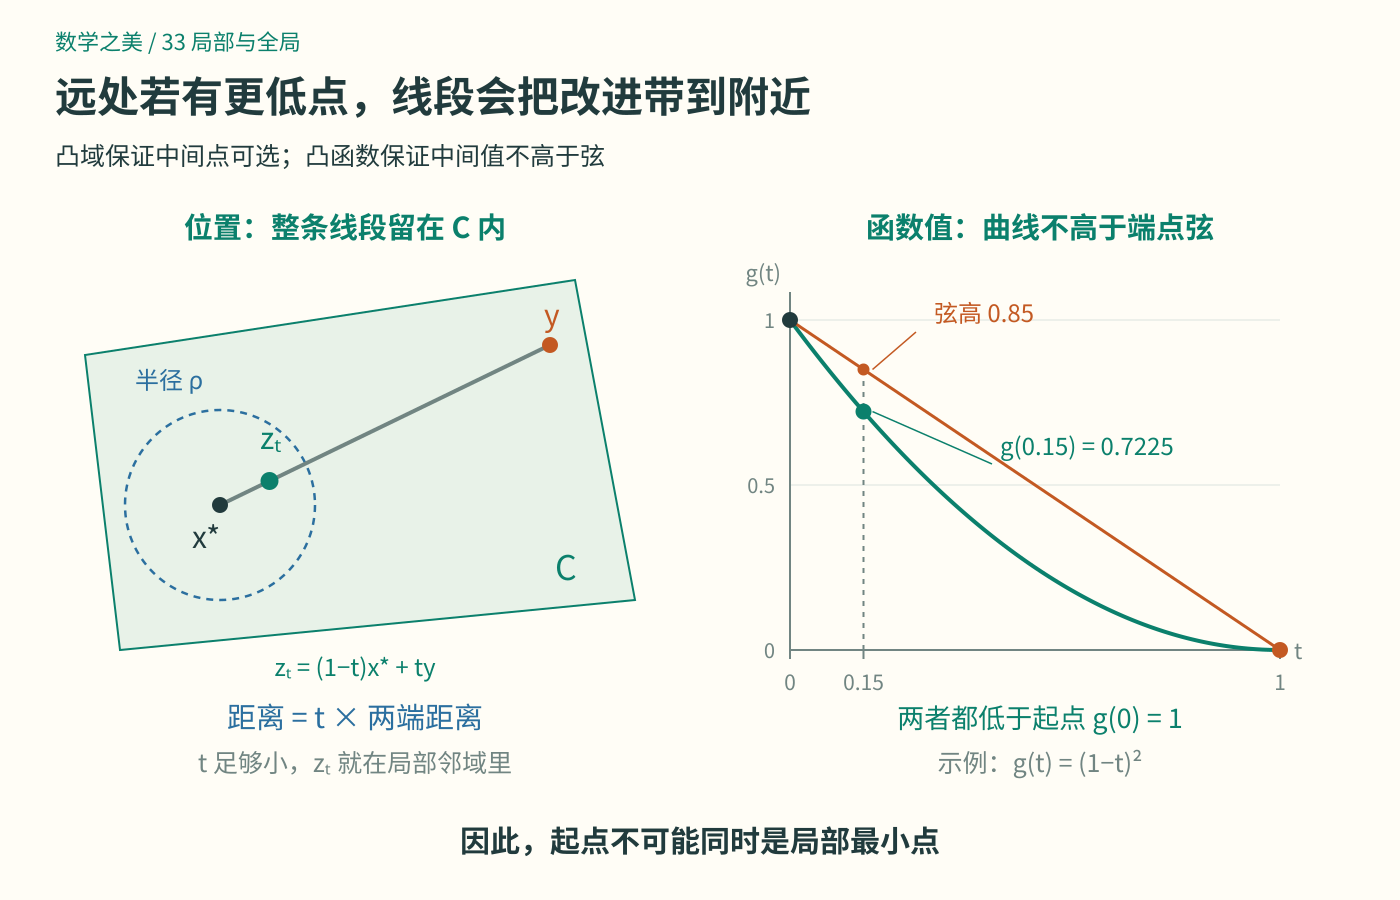
图1:右图用g(t)=(1−t)²演示反证中的比较,t=0只是被检验的候选,并非真最小点。t取0.15时,弦高0.85,函数值0.7225,都低于起点的1;证明则允许t按任意给定的邻域继续缩小。
这也说明为什么只讲“没有坏山谷”还不够。真正接通局部与全局的,是任意远处较低点都能沿可行线段,把较低值带到任意近处。
失去凸性确实会发生什么
看一个处处可微的函数,允许s取任意实数:
f(s)=s⁴−(4/3)s³−4s²。
s=−1给出f(−1)=−5/3。它真的在附近最低吗?不靠图形,也不把驻点直接当极小点。将s写成−1+h,逐项展开得到
f(−1+h)−f(−1)=h²[6−(16/3)h+h²]。
当0<|h|<1/2时,方括号大于6−8/3=10/3,因而整个差严格为正。于是−1是严格局部最小点。
但f(2)=−32/3,比−5/3更低,相差9。甚至可以把全局保证直接配出来:
f(s)+32/3=(s−2)²[(s+4/3)²+8/9]≥0。
方括号始终为正,等号只在s=2成立,所以2才是唯一全局最小点。局部与全局之间的差别,在这个光滑的四次多项式里真实存在。
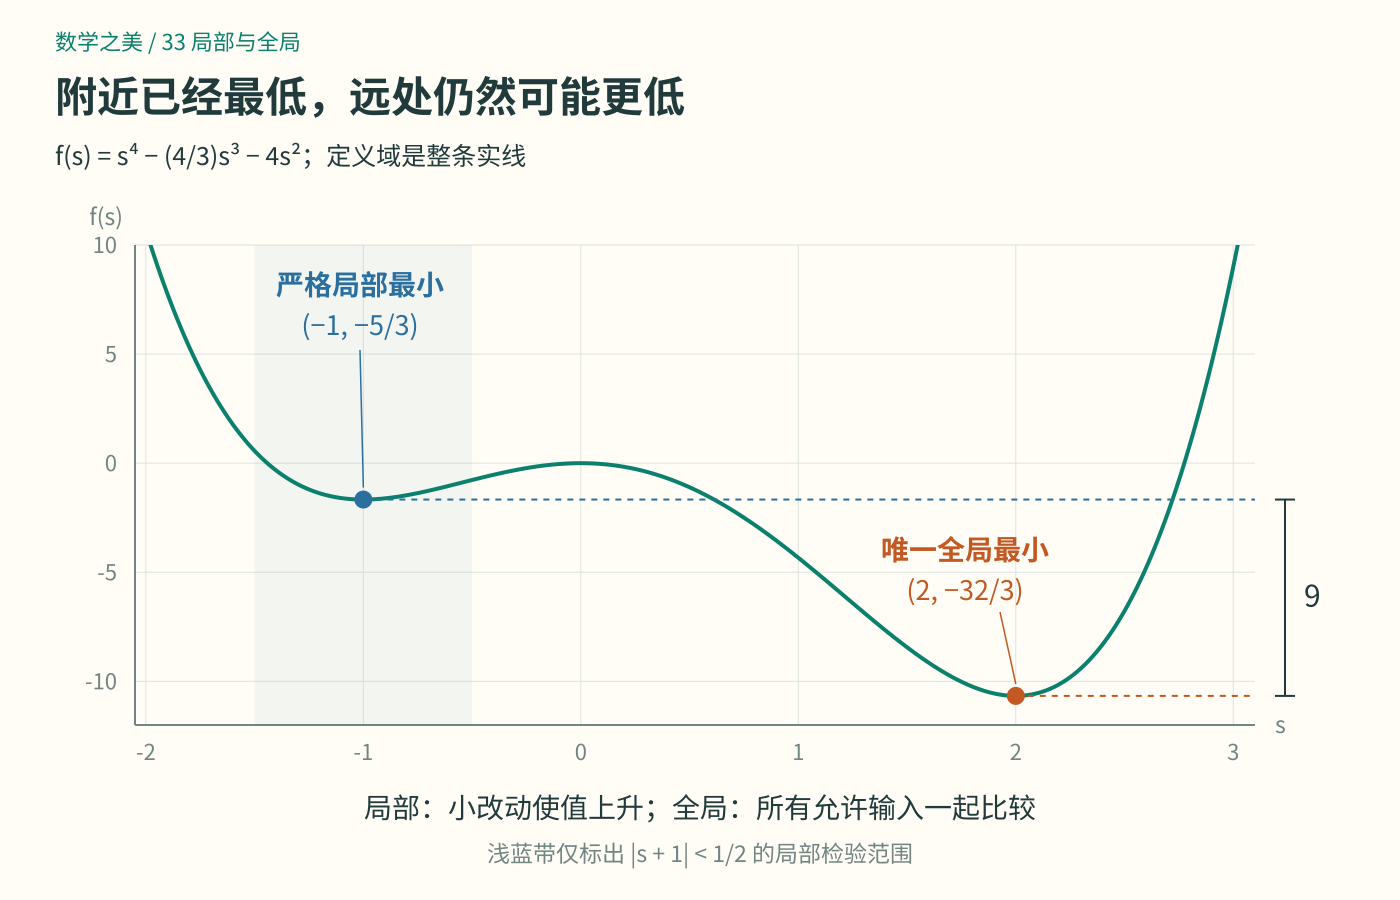
图2:曲线按同一坐标尺度绘制。两个点的身份由正文中的展开与平方分解确认,不能只凭导数为零或谷底的外观。
还能直接检查它为何不凸:0是−1与2按2/3、1/3加权的位置,而f(0)=0,高于同样加权的端点值−14/3,违反凸不等式。
凸函数让局部直线成为全局下界
现在加上可微条件。设f定义在一个开凸集上,并且可微。“开”表示每个点周围都能容纳一个小球,使普通的多变量导数有完整的邻域可用。
任取域内x、y,对0<t≤1,凸不等式可以改写为
[f(x+t(y−x))−f(x)]/t≤f(y)−f(x)。
让t从正侧趋于0。按第32章的局部线性近似,左边趋于沿y−x方向的变化率∇f(x)·(y−x),于是
f(y)≥f(x)+∇f(x)·(y−x)。
这叫一阶支撑不等式。推导只做了减去f(x)、除以正数t、取极限三步。普通可微函数的线性近似主要描述附近;凸性让同一条线性表达式成为整个定义域上的下界。[3]
若∇f(x*)=0,右边便只剩f(x*),从而所有y都有f(y)≥f(x*)。因此,可微凸函数的无约束内点驻点就是全局最小点。这次零梯度有了充分保证,原因是额外的凸性。
边界需要另外理解。例如最小化f(s)=s²,但只允许s≥1。最优点是1,导数却是2。负梯度指向更小的s,可行域恰好禁止从1向左走。支撑式在此给出s²≥1+2(s−1)≥1,最后一步正用到了s≥1。若函数在包含可行域的开集上可微,上述推导对可行线段仍可使用;支撑式中的梯度本身不必为零。更一般地,只要沿所用线段的单侧方向导数存在,取极限这一步也可以按那个方向来做,不能未经说明就在边界套用双侧导数。
三点最小二乘为何属于这一类
回到虚构读数(0,1)、(1,2)、(2,2),模型ŷ=ax+b,参数θ=(a,b)。按固定厘米单位记录的数值运算,令y=(1,2,2),X的三行为(0,1)、(1,1)、(2,1),则
L(θ)=‖y−Xθ‖²。
参数允许取整个R²,这是凸集。要证明目标凸,先取任意两个同维向量r、s。对每一项,都有
[trᵢ+(1−t)sᵢ]²
=t²rᵢ²+2t(1−t)rᵢsᵢ+(1−t)²sᵢ²
=trᵢ²+(1−t)sᵢ²−t(1−t)(rᵢ−sᵢ)²。
把各项相加,就得到
‖tr+(1−t)s‖²=t‖r‖²+(1−t)‖s‖²−t(1−t)‖r−s‖²。
最后一项非正,因此混合后的平方长度,不超过原来两份平方长度的加权平均。
取两组参数θ、φ,令r=y−Xθ、s=y−Xφ。由于X对参数的作用是线性的,混合参数后的残差恰好也是混合残差:
y−X[tθ+(1−t)φ]=tr+(1−t)s。
代入恒等式,就有L(tθ+(1−t)φ)≤tL(θ)+(1−t)L(φ),SSE的凸性得证。这里不能只说“平方是凸的”;预测怎样依赖参数,是不可省略的一环。
虽然模型写着截距b,预测对参数(a,b)仍是线性的:在固定的三个输入上,每个预测都是参数的固定系数组合。这里研究的是调节参数,观测y与矩阵X都不随混合而改变。如果改变数据或让X也依赖待调参数,就必须重新检查这一步。
再看等号。若X列满秩,即各列独立,那么θ≠φ意味着Xθ≠Xφ,因此r≠s。当0<t<1时,恒等式减去的那项严格为正,凸不等式就严格成立。这称为严格凸。
严格凸的函数至多有一个最小点:假如两点都达到同一个最小值,它们中点的值会严格更低,立刻矛盾。“至多”不等于“一定存在”。例如f(s)=s²在s>0上严格凸,却没有最小点;任何s都能换成s/2,使值变为原来的四分之一,0又不在可行域里。
我们的三点例子已在第17章构造出θ*=(1/2,7/6),并证明最小SSE为1/6平方厘米,所以存在性没有欠账。X的两列独立,再由严格凸性得到参数唯一。
还可以接上上一章的梯度:∇L=(10a+6b−12,6a+6b−10)。代入θ*,两项都是0。用矩阵写,就是∇L=−2Xᵀ(y−Xθ),因此零梯度恰好等价于第17章的正交残差条件。投影证明与凸性证明并非给出不同答案,而是从不同结构确认同一个解。
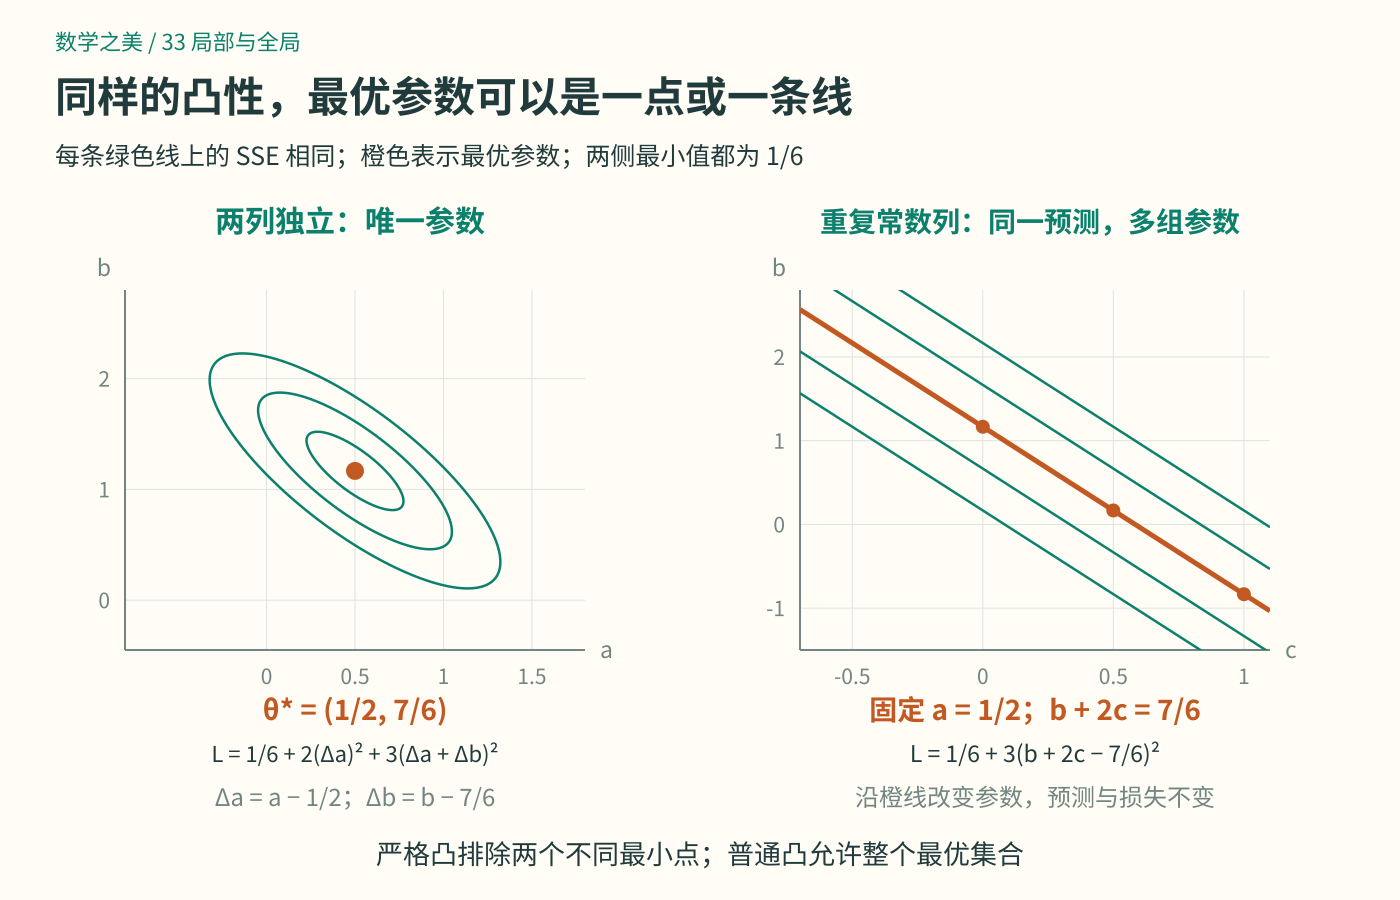
图3:左侧是原模型的参数平面;右侧是重复列模型中固定a=1/2的切片。等高线表示相同SSE,橙色点或线表示最优参数集合,不是数据平面里的预测直线。
若像第16章那样改成X′=[x,u,2u],预测只依赖a和b+2c。全部参数(1/2,7/6−2q,q)都给出相同最佳预测。损失仍凸,但沿这条线不严格凸;普通凸问题完全可以有一整片同样好的解。
事实上,凸问题中任意两个最优点之间的整条线段都同样最优:凸不等式使中间值不高于端点的共同最小值,而最小值的定义又不允许它更低。两边夹住,便只能相等。于是最优集合可以宽,可以窄,却不能在两个同样好的点之间隔着一个更差的必经点。
凸性保证什么又没有保证什么
平方误差对预测值凸,不代表对任意模型参数都凸。例如预测p=uv,目标F(u,v)=(uv−1)²。两组参数(1,1)、(−1,−1)的损失都是0,中点(0,0)的损失却是1,超过端点值的平均,直接违反凸性。
所以第31章即便只在层间相乘,也不能自动沿用线性参数模型的结论;更不能据此说神经网络的局部最小都必为全局最小。凸性必须对实际优化的那组变量检查。
凸性也没有撤销第32章的步长限制。固定a=1/2时,L(b)=3(b−7/6)²+1/6严格凸。令e=b−7/6,梯度更新仍给出e的新值为(1−6η)e。取η=1/2,误差变为−2e,除非本来就在最优点,否则越走越远。目标的结构与算法能否稳定到达目标,是不同的问题。
本章获得的是一个带条件的全局保证:可行线段与凸不等式,把附近的最优推广到整个可行域。它保证的是既定数据、模型与损失下的最优;下一章将追问,即使把这个目标优化到底,是否就能在新数据上表现更好。
顺手试一下
题目1: 对f(s)=s²,分别考虑可行域C₁=[1,∞)、C₂=(0,∞)、C₃={−1,2}。各自有哪些局部最小点和全局最小点?哪些集合凸?为什么它们不与本章结论冲突?
**提示:**局部比较只看可行点;对孤立点,可以选一个不含其他可行点的小邻域。
**参考答案:**C₁凸,1是唯一局部及全局最小点,导数2不妨碍边界最优。C₂凸,但没有局部或全局最小点:任意s>0都能向左移任意小的一步,保持正数并降低平方。C₃不凸;−1与2都是局部最小点,只有−1是全局最小点。前两种满足“任一局部最小都是全局最小”,其中第二种没有局部最小点;第三种缺少凸域条件。
题目2: 重复列模型中,取A=(1/2,7/6,0)、B=(1/2,−5/6,1)。求中点参数、三点预测和SSE。它是否反驳“严格凸函数至多有一个最小点”?再用F(u,v)=(uv−1)²的两个零损失点说明另一种失效。
**提示:**前一个模型看a与b+2c;后一个模型必须在参数空间取中点。
**参考答案:**中点为(1/2,1/6,1/2),有效截距b+2c=7/6,预测为(7/6,5/3,13/6),SSE=1/6平方厘米,与A、B相同。这说明重复列后的损失不严格凸,但仍凸,没有反驳唯一性定理。F的两个零损失点是(1,1)与(−1,−1),中点损失1>0,因此F连普通凸性也不满足。参数冗余导致不严格,与非线性参数化破坏凸性,是两件不同的事。
参考与延伸
[1] 莱斯大学OpenStax,Gilbert Strang、Edwin “Jed” Herman,《Calculus Volume 1》,4.3 Maxima and Minima。核对局部与全局极值、可微内点极值的必要条件及其逆命题不成立;本文明确采用相对于可行域的局部定义。
[2] Stephen Boyd、Lieven Vandenberghe及Parth Nobel修订,Convex Optimization讲义,幻灯片2.3、3.2与4.10。核对凸集、凸函数与严格凸的定义,以及局部最优到全局最优的线段证明。
[3] 麻省理工学院MIT OpenCourseWare,Dimitri Bertsekas,6.253 Lecture 3,第2—4页。核对可微凸函数的一阶支撑条件和受约束最优的一阶条件。
本文算例沿用本系列虚构读数;四次反例的展开、SSE恒等式与三幅配图为本章独立编排,不代表真实训练实验。
作者:Jiancheng Wang · 数学之美(独立原创)