先修:12 数据与损失;15—17 矩阵、模型与最小二乘;29 优化目标;30 导数与局部变化
上一章把“参数动一点,损失会怎样”变成了可计算的问题。我们从差商出发,得到L′(b)=6b−7。但那时,损失还能写成一条不长的式子。如果预测先经过一次乘加,再经过另一次乘加,最后才与读数比较,早先那个参数造成的影响,该怎样穿过中间步骤?
一种办法是把所有括号展开。不过,展开以后,计算原有的层次也消失了。本章换一条路:保留每一步运算,先弄清变化穿过一步时会乘上什么,再把这些局部影响接起来。这条路通向链式法则,也通向训练AI时常说的反向传播。
两个局部倍率为什么相乘
把两步计算写成u=g(x),q=f(u),总结果就是q=f(g(x))。这里u是中间结果,不是独立改变的另一个输入。
假设g在当前x处可微,f在当前u=g(x)处可微,并且复合运算在x附近有定义。链式法则说:[1]
(f∘g)′(x)=f′(g(x))g′(x)。
“可微”沿用上一章的含义:输入变化很小时,输出变化可以用一个固定倍率乘上输入变化来近似,而且误差相对于输入变化会趋于零。g′(x)是第一步的局部倍率;f′(g(x))是第二步在实际收到的中间值处的局部倍率。不是把f′也代入g′,而是先算中间值,再去那里求导。
例如g(x)=3x+1,f(u)=u²,在x=1处,u=4。第一步的倍率是3,第二步的倍率是2u=8,所以总倍率是24。若输入增加h,总输出恰好增加
(4+3h)²−4²=24h+9h²。
这里24h是一阶变化,余下的9h²除以h后是9h,趋于0。这才说明24是导数;仅凭“两个倍率看起来应该相乘”,还没有证明一般情形。
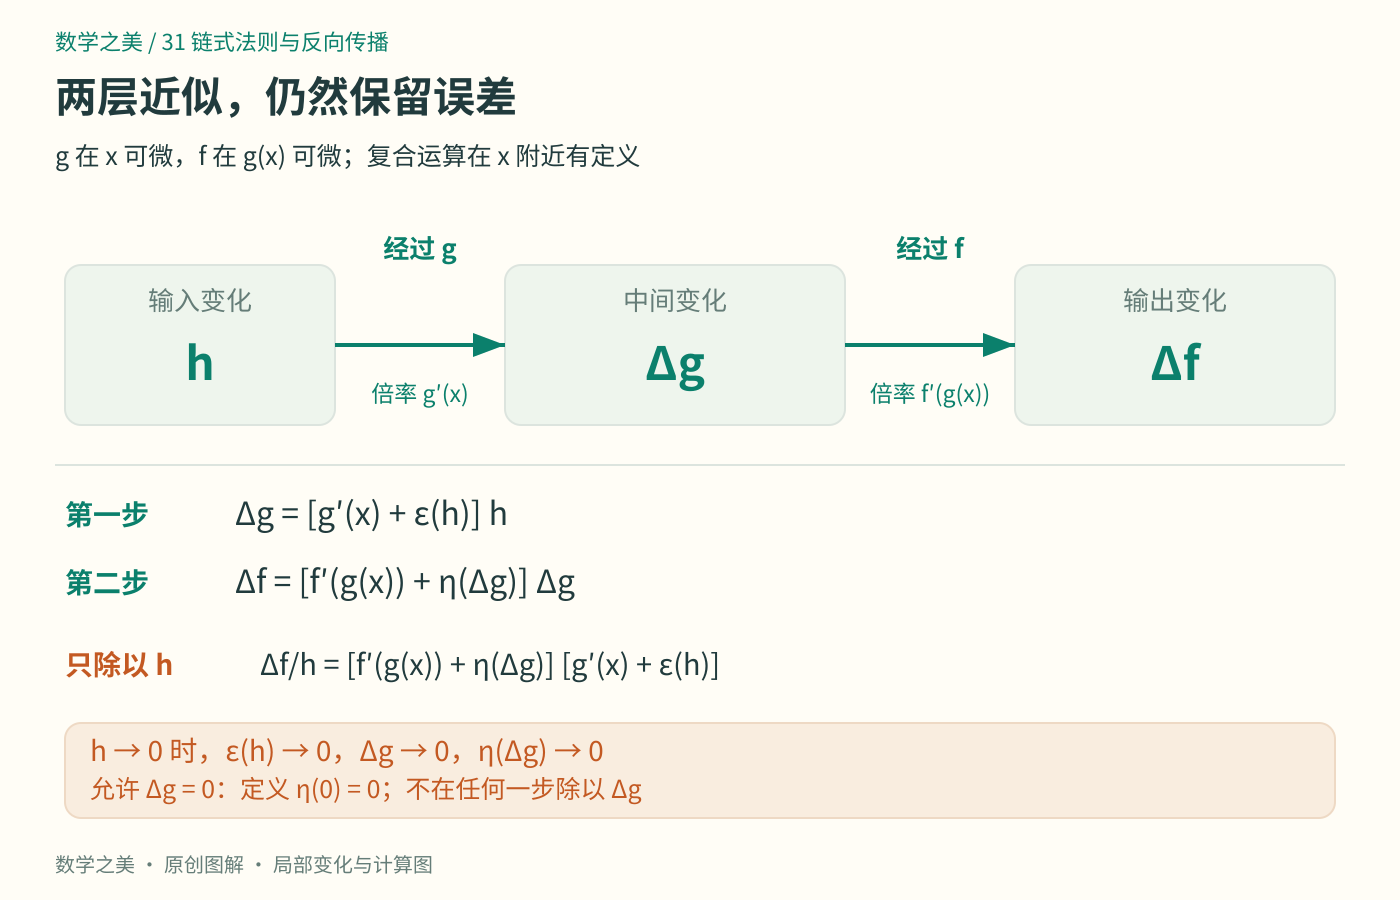
图1:实线表示变化依次经过两步。下方保留误差项,说明相乘不是把近似当成完全相等。
不除以可能为零的中间变化
固定当前x,令非零的h趋近于0,记Δg=g(x+h)−g(x)。由g可微,可以把等式准确写成
Δg=[g′(x)+ε(h)]h,其中ε(h)→0。
ε(h)就是第一步差商与导数的差。于是Δg→0,且Δg/h=g′(x)+ε(h)在h足够小时有界:它靠近一个有限数,不会突然变得无限大。
在u=g(x)处,对第二步也可以写出
f(u+t)−f(u)=[f′(u)+η(t)]t。
当t≠0时,把η(t)定义成第二步差商减去f′(u);由可微性,η(t)→0。当t=0时,规定η(0)=0,等式两边仍都为0。这个补充很重要:g可能在附近保持不变,也可能沿某些h给出同样的中间值,不能假装Δg永远不为0。
现在把t换成Δg,只除以确定非零的h,得到
[f(g(x+h))−f(g(x))]/h
=[f′(g(x))+η(Δg)]·[g′(x)+ε(h)]。
因为Δg→0,η(Δg)→0;另一边ε(h)→0。两项乘积就趋向f′(g(x))g′(x),证明完成。特别地,第二步带来的误差除以h后是η(Δg)·Δg/h:前一项趋零,后一项有界,所以仍趋零。
这也解释了“误差小于一阶”究竟在说什么。不是笼统地说误差很小,而是把误差与原始步长的大小相比,所得比例趋于0。两层的误差能够控制住,局部线性近似才能一层接一层。整个证明没有要求g′(x)非零,也没有要求两层导数在附近连续。
把一个读数拆成计算图
回到虚构玩具的读数,这次只取其中一条:x=1,观测y=2。仍按选定单位下的读数数值计算。把预测写成两层:
z=wx+b,ŷ=vz+c,L=(ŷ−y)²。
参数w、b、v、c是四个独立旋钮。先取w=1,b=0,v=1/2,c=1,顺着式子往前算:z=1,ŷ=1.5,L=1/4。这一遍叫前向计算。这里L只含一条记录,不是上一章三条记录的总损失,数值不能直接混作同一个L。
我们要分别问:只调整w、只调整b、只调整v或只调整c,损失的局部变化有多快?固定其他独立参数与数据,只改变其中一个参数所求的导数,叫偏导数。例如∂L/∂w就是把b、v、c、x、y固定后,对w求导。z与ŷ仍要随着w重新计算,它们不是被固定的独立参数。
先从末端看。令e=ŷ−y=−1/2,这里取“预测减观测”,与此前“观测减预测”的残差符号相反,平方损失不变。平方的导数告诉我们
∂L/∂ŷ=2(ŷ−y)=−1。
意思是,在其他条件固定、预测只改很小一段时,预测每增加一个小量,损失的一阶变化约为这个小量的负一倍。导数为负符合直觉:预测目前偏低,往上挪一点,会更接近2。
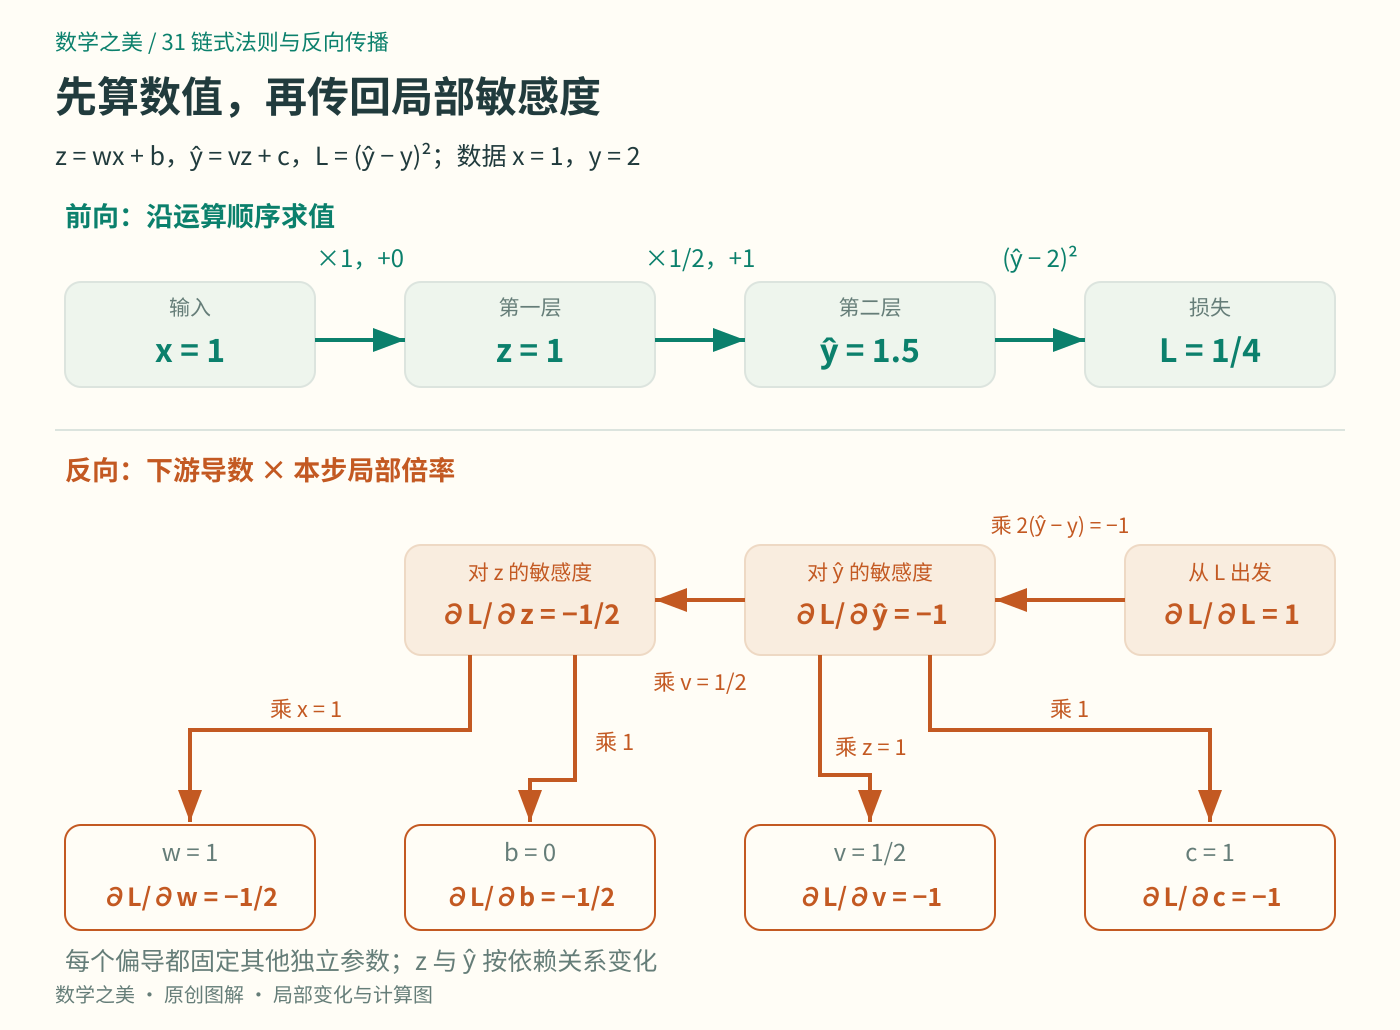
图2:绿色箭头传数值,橙色箭头传损失对节点的导数。橙色箭头上的“乘”表示这一小步使用的局部倍率。
从末端把影响传回来
现在看ŷ=vz+c。固定v、c时,z变化经过这一步要乘v=1/2。因此
∂L/∂z=(∂L/∂ŷ)(∂ŷ/∂z)=(−1)×(1/2)=−1/2。
再看z=wx+b。固定数据x=1,w到z的倍率是x=1,b到z的倍率是1,所以
∂L/∂w=(−1/2)×1=−1/2;
∂L/∂b=(−1/2)×1=−1/2。
另两个参数直接进入第二层。只改v时,z不变,ŷ的变化倍率是z=1;只改c时,倍率是1。因此
∂L/∂v=(−1)×1=−1;
∂L/∂c=(−1)×1=−1。
按(w,b,v,c)的顺序,把四个偏导排起来,就是此处的梯度(−1/2,−1/2,−1,−1)。梯度记录的是当前参数、当前数据和当前损失下的局部敏感度;换一个计算点,数字可能全部改变。
这里w与b的偏导相同,是因为恰好x=1,两种调整对z的一阶影响一样大;这并不说明两个参数总是等价。若输入改为x=0,改w根本不会改变z,而改b依然会。类似地,v的局部倍率依赖前向得到的z。这些倍率都是有位置、有当前数值的,不能把本次求出的四个数字当成模型永久不变的属性。
注意,我们只算了一次∂L/∂ŷ、一次∂L/∂z,就把已经得到的结果接着传给了各参数。没有为每一个旋钮重新展开一遍大式子。反向传播正是把这种复用组织成算法:从标量损失出发,按依赖关系的反方向处理节点,用下游传来的导数乘本步的局部偏导。[2]
为什么尤其适合从损失往回算?因为当前只关心一个最终标量,却要知道许多参数怎样影响它。靠近末端的一段导数,往往被许多上游参数共同需要,算一次就能复用。若坚持从每一个参数单独出发,重复经过共同的后半段,就会重复劳动。反向处理时,要先等齐一个节点所有下游贡献,再把它的累计结果继续往前传;否则就可能漏路。
“反向”也不是把计算倒着求逆。平方未必能唯一反解出原数,链式法则却照样适用。往回传的是影响有多大,不是试图从损失还原输入。
还要守住“局部”两个字。∂L/∂w=−1/2并不意味着w增加1,损失就精确减少1/2。那样会从1/4算出负损失,显然不可能。实际把w改成2,预测变成2,损失降到0;有限步长必须算上被一阶近似略去的余项。导数提供起步时的变化率,不负责把任意远处的结果线性外推。
一条路相乘,多条路还要相加
计算图不一定只有一条链。现在另设一个例子:ŷ=wx+w,L=(ŷ−y)²;取x=2,y=4,w=1。两处w指向同一个参数,只能一起改变。当前ŷ=3,L=1,∂L/∂ŷ=−2。
w有两条路影响预测。一条先乘x再进入加法,贡献(−2)×2=−4;另一条直接进入加法,贡献(−2)×1=−2。总导数必须把它们相加:
dL/dw=−4+(−2)=−6。
为什么不能任选一条?把w增加h,第一路让预测增加2h,第二路增加h,总共是3h。因此损失的变化恰好是
(−1+3h)²−(−1)²=−6h+9h²。
除以h再取极限,得到−6。这里“沿路径相乘、在汇合处相加”并非记账习惯,而是在收集同一个变化造成的全部一阶影响。
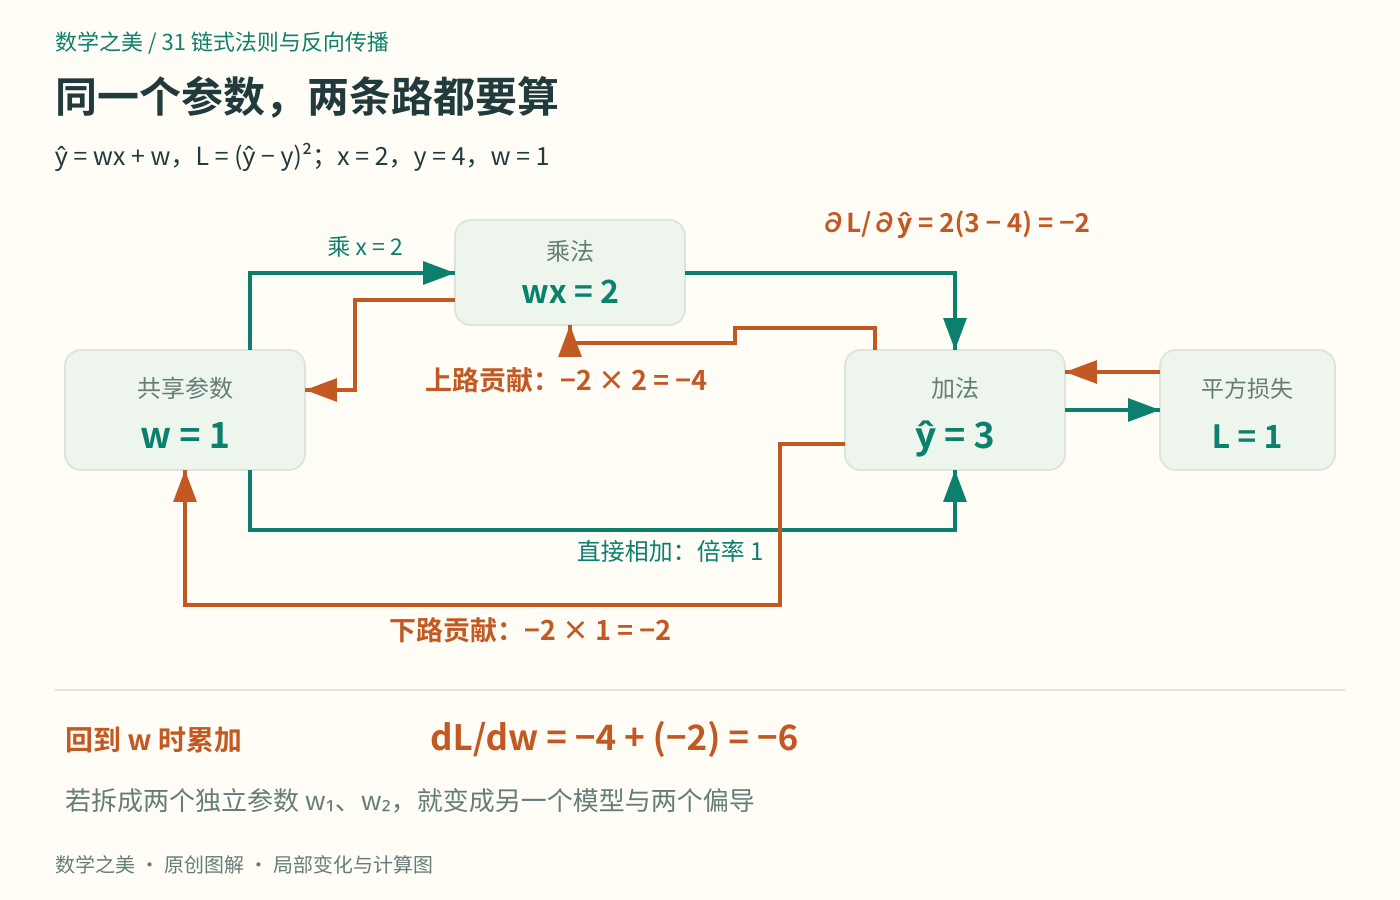
图3:两个w的出现共用同一个旋钮。若把它们改成独立参数w₁、w₂,求到的是两个偏导−4、−2,不是一个导数−6。
对于本章的乘法与加法节点,多输入的一阶变化也可以直接检查。例如两个输入同时变化时,(a+Δa)(b+Δb)−ab=bΔa+aΔb+ΔaΔb。若二者都由同一个小步长h引起,且各自变化除以h有界,最后那一项除以h便趋零。留下的一阶贡献相加,正是分支求导所需的规则。一般多输入节点则需要相应的多元可微条件,不能仅凭各个偏导存在就自动推广。
加法也把我们接回上一章。固定斜率1/2,对三个读数(0,1)、(1,2)、(2,2)共用截距b,总损失是三条平方误差支路之和。每条预测对b的局部倍率都是1,三条预测减观测的差分别为b−1、b−3/2、b−1。因此传回b的贡献相加,得到
2(b−1)+2(b−3/2)+2(b−1)=6b−7。
同一答案现在有了计算图的解释:一个参数同时影响三条记录,三条路都要计入。若定义的是三条记录的平均损失,而不是总和,末端还多了一步“除以3”,传回的梯度也要除以3。反向传播忠实计算你写下的目标,不会替你决定用总和还是平均值。
让计算机做的是哪一种求导
自动微分可以把已执行的计算拆成有导数规则的基本运算,再按链式法则组合结果;反向传播属于反向模式的自动微分。[3] 前向通常保存反向所需的中间值。例如上面的∂ŷ/∂v需要用到z,平方那一步需要用到e。知道图的连线还不够,也要知道这一遍实际算到了哪里。
这与数值差分不同。数值差分会真的挪动参数,再比较两次损失。比如只把第一例的w增加0.001,损失从0.25变成0.24950025,差商为−0.49975,接近−1/2。这个核对有助于发现程序错误,却不是导数存在或算法正确的一般证明。
自动微分不靠挑一个很小的步长来估计导数,也不必先生成整个函数展开后的符号表达式。它沿计算过程应用局部求导规则;实际在计算机上运行,仍受浮点舍入、溢出以及所用运算规则的影响,不能因此称作“绝对没有数值误差”。
求到了梯度,仍有三道边界
第一,可微条件不能丢。常见的max(0,z)在z>0处导数为1,在z<0处为0,在z=0处左右导数不同,经典导数不存在。程序可以在该点采用约定或其他广义工具,但一个返回值不能替代经典可微性的证明,也不能直接冒用本章定理。
反过来,某个中间节点不可微,也不能草率断言整个复合函数必不可微。例如f(u)=|u|在0不可微,g(x)=x²却使f(g(x))=x²,在0有导数0。定理的条件是保证结论成立的一套充分条件,不是对所有复合函数的完整判决。遇到不满足条件的节点,必须另查整体,或明确所用的替代规则。
第二,多层不自动带来更强的表达能力。本章两层乘加展开仍是ŷ=(vw)x+(vb+c),对于输入x依旧是仿射函数。正如第15、16章提醒的,增加写法与增加可表示的函数是两件事。这里增加层次,是为了看清求导的组织方法。
第三,反向传播算出梯度,还没有选择更新步长、找到最优参数,更没有证明对新数据预测准确。第17章的最小二乘最优性另有证明,第23章的独立评估也仍然必要。下一章再问:拿到这些局部方向以后,怎样真正迈出参数更新的一步?
顺手试一下
题目1: 设g(x)=x²,f(u)=3u+1。在x=0处求(f∘g)′(0)。有人说“g′(0)=0,所以链式法则不能用”,对吗?若把g改成在0附近恒等于0,证明还能成立吗?
提示: 检查定理要求的是可微,还是导数非零;再看证明有没有除以Δg。
参考答案: 两个函数在对应点均可微,复合导数为3×0=0;直接差商是3h,也趋于0。导数为零不妨碍链式法则。若g在0附近恒为0,复合函数恒为1,导数仍为0;此时Δg一直是0,正文给η(0)的定义使证明照常成立。
题目2: 沿用共享参数的ŷ=wx+w,保持y=4、w=1,却令x=−1。求两条路径对dL/dw的贡献和总和。损失是否因此变成0?
提示: 先算预测,再分别乘两条路径的局部倍率;不要把“导数为0”误读成“损失为0”。
参考答案: ŷ=0,L=16,∂L/∂ŷ=−8。两路贡献为(−8)×(−1)=8和(−8)×1=−8,总导数为0。固定x=−1时,不论w取什么值,wx+w都等于0;两路影响完全抵消,这个参数根本无法降低当前损失。零梯度并不说明预测正确。
参考与延伸
[1] OpenStax,《Calculus Volume 1》,3.6 The Chain Rule。核对链式法则的可微条件与导数取值位置;本文用余项形式补足中间变化可能为0时的证明。
[2] PyTorch官方教程,Automatic Differentiation with torch.autograd。核对计算图、前向记录、反向传播与梯度累积。
[3] Atilim Gunes Baydin等,Automatic Differentiation in Machine Learning: a Survey,JMLR 18(153),2018。进一步区分自动微分、数值差分、符号微分及反向模式。
本文沿用前文虚构玩具的一条读数,并另设共享参数算例;数值推导、练习与配图为本章原创。
作者:Jiancheng Wang · 数学之美(独立原创)