先修:19 有限概率模型;20 条件概率与贝叶斯公式;平方与平方根
两套服务都宣称:“平均响应时间100毫秒。”这是否意味着,使用哪一套都差不多?
先搭一个完全已知的虚构模型。系统A每次都用100毫秒;系统B以0.99的概率用90毫秒,以0.01的概率用1090毫秒。B的加权平均是0.99×90+0.01×1090=100毫秒,确实与A相同。但一次请求若超过500毫秒就算超时,A的超时概率为0,B为0.01。
一个平均数没有说错,却省略了影响使用体验的信息。本章就从这处省略出发,看看怎样描述波动,以及两份波动相加时,为什么还要知道它们怎样一起发生。
给每种结果配一个数
把样本空间中的每个结果映射成一个实数,得到的函数叫随机变量。名字里的“变量”,不是说它会自行改变规则,而是说实验结果尚未确定,最终取到的数也尚未确定。
例如设样本空间有100个等可能的标签。A把每个标签都映射为100;B把前99个映射为90,把最后一个映射为1090。标签并不是时间,它们经由不同的规则才变成响应时间。随机变量可以是常量,A就是这样的例子。
本章只讨论有限模型。若X的可能取值为x₁,…,xₖ,相应概率为p₁,…,pₖ,期望定义为:
EX=x₁p₁+…+xₖpₖ=∑ᵢxᵢpᵢ。
这里∑表示把标出的各项加起来。概率非负、总和为1,所以期望是按概率加权的平均数,也叫均值。1 若X以毫秒计,EX也以毫秒计。
也可以直接对样本空间的各个结果求和:EX=∑ωX(ω)p(ω)。如果几个结果映射到同一个数,就把它们的概率相加,再乘这个共同取值,恰好回到上面的公式。因此,“按结果求和”与“按不同取值求和”只是在分组方式上不同。
期望不一定是可能出现的结果。B从不取100,却有期望100。也不能把它读成“接下来的100次,必定有99次快、1次慢”。我们刚才规定的是一次实验的概率模型,并没有规定一串实验之间的关系,更没有给出任何有限次数的保证。模型里的期望,与已经拿到的一组读数的算术平均,需要分开。
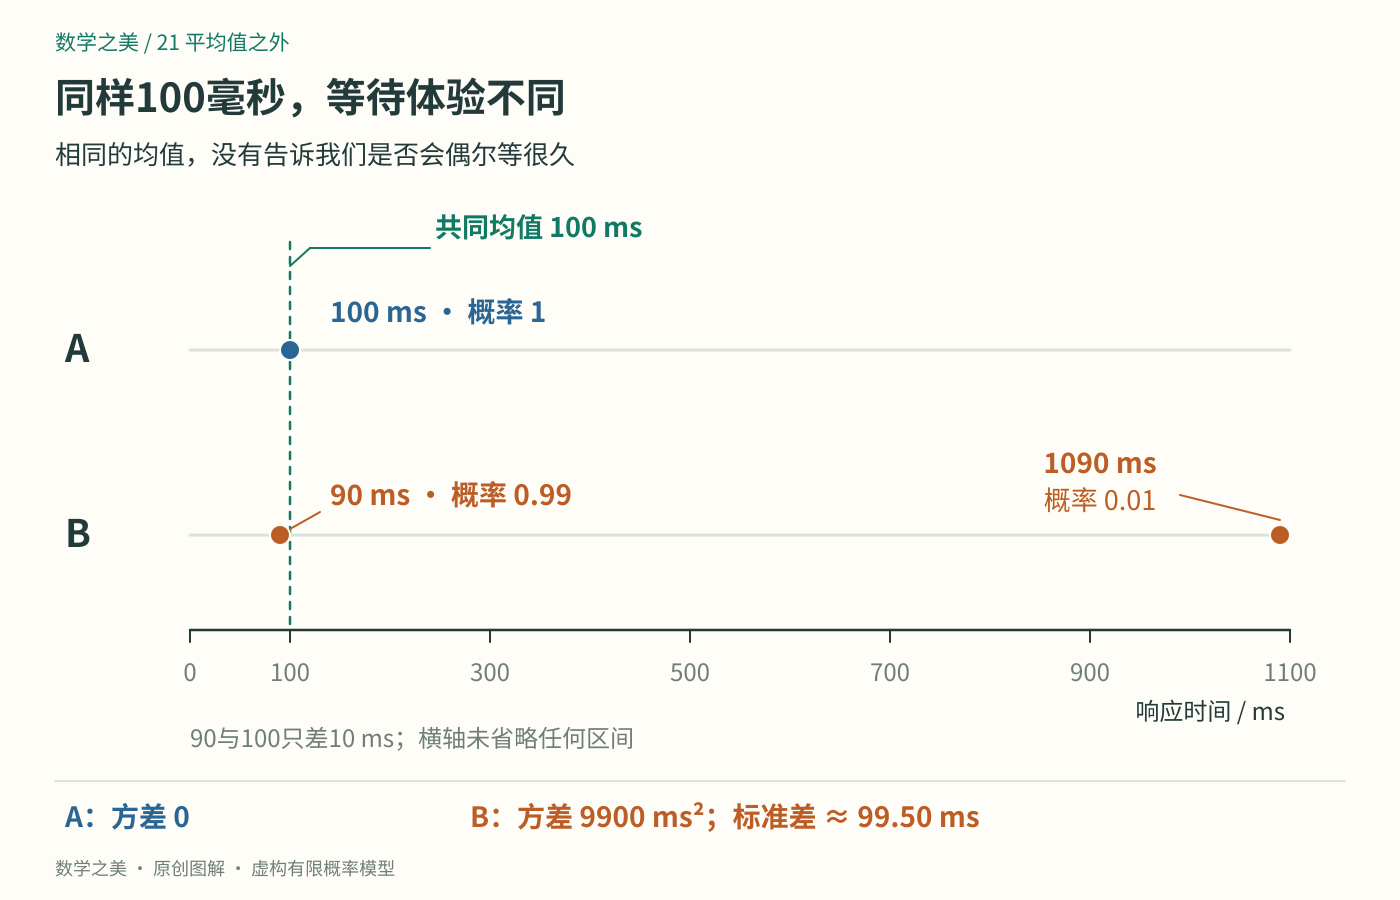
图1:横轴是响应时间,不是请求顺序。点的位置表示可能取值,概率由文字标出,点的面积不表示概率。B的90与均值100仅相差10毫秒,因此在完整横轴上非常接近。
相加的平均,不要求各自独立
如果一项任务依次经过两个环节,耗时分别为X和Y,总耗时就是X+Y。即使它们受同一台机器的负载影响,也有:
EX+Y=EX+EY。
理由可以在最底层逐项看清。把共同样本空间中的结果记作ω,其概率记作p(ω)。在每个结果下,先加耗时再乘概率,得到
EX+Y=∑ωX(ω)+Y(ω)p(ω)
=∑ωX(ω)p(ω)+∑ωY(ω)p(ω)
=EX+EY。
这里只用了有限和的分配律,没有使用独立性。即使Y恰好是X的复制品,等式仍然成立。类似地,固定数a、b可以从加权和中整理出来,得到EaX+b=aEX+b;常数项能保留为b,是因为全部概率之和等于1。这些性质合称期望的线性性。
但接下来不能照抄一句“总波动也等于各自波动之和”。平均耗时可以直接相加,波动还缺一条关于共同发生方式的信息。
怎样让正负偏离不再抵消
记μ=EX。每次偏离平均数的量是X−μ。若直接取期望,EX−μ=μ−μ=0。偏离并没有消失,只是正负抵消了。
与第12章处理残差的想法相似,可以先平方,再按概率平均。这个数叫方差:
Var(X)=E(X−μ)²=∑ᵢ(xᵢ−μ)²pᵢ。
这里不是对一组观测求平方和,而是在已知概率模型中,求“偏离均值的平方”的期望。假如手里只有实际测得的几十次延迟,未知系统的全部取值与概率,就还不能把按这几十次记录算出的数,当作真实模型方差已被精确知道。如何用样本估计总体,是另一个问题。各项非负,所以方差非负;在有限模型中,方差为0意味着所有具有正概率的取值都等于μ。2
A的方差是0。B的两种偏离为−10毫秒和990毫秒,因此:
Var(B)=0.99×(−10)²+0.01×990²
=99+9801=9900平方毫秒。
只占1%的慢响应,贡献了9801平方毫秒,占总方差的99%。平方会放大远处取值的影响,这也是均值附近看似平稳、偶尔却严重卡顿的系统需要额外留意的地方。
方差的单位是原单位的平方。为了回到毫秒,取非负平方根,得到标准差σ=√Var(X)。B的标准差为√9900≈99.50毫秒。这个数不是最大偏离,也不能单凭它宣布所有结果都在均值上下99.50毫秒之内;本例的1090毫秒已经明确否定了这种读法。
计算时常用另一种写法。将平方展开,再用期望的线性性:
Var(X)=EX²−2μX+μ²
=EX²−2μEX+μ²
=EX²−μ²。
因为μ是固定数,Eμ²=μ²。对B,EB²=0.99×90²+0.01×1090²=19900平方毫秒,减去100²,仍得9900。注意EX²是先平方再平均,通常不等于先平均再平方的(EX)²;两者之差恰好就是方差。
还有一个实用的检查:给所有取值加上同一个常数,均值也加同一个常数,中心化偏离不变,所以方差不变。若把全部偏离放大a倍,平方便放大a²倍。准确地说,
Var(aX+b)=E(aX+b−aμ−b)²=a²Var(X)。
因此,延迟统一多出20毫秒会增加平均等待,却不增加方差;毫秒改写成秒时,数值除以1000,方差数值则除以1000000。低方差不等于低延迟,一个始终很慢的系统同样可以拥有零方差。
方差也不是完整的风险说明。若关心超时,应同时检查超过业务阈值的概率;单独保留均值和方差,仍会丢掉分布中的其他信息。
两个环节为什么可能一起变慢
换一个更小的虚构模型:两个串行环节各以一半概率耗时90或110毫秒。各自均值100毫秒,方差都是100平方毫秒。现在比较两种共同发生方式。
这里说有限随机变量X、Y独立,指对每一对取值x、y,都有P(X=x,Y=y)=P(X=x)P(Y=y)。逗号表示两件事同时发生;也就是要求每一对取值事件满足第19章的独立定义。
第一种,两个环节独立。四对耗时(90,90)、(90,110)、(110,90)、(110,110)的概率都为1/4。总耗时180、200、220毫秒的概率分别为1/4、1/2、1/4,均值为200,方差为:
(1/4)×(−20)²+(1/2)×0²+(1/4)×20²=200平方毫秒。
第二种,两者受到同一份扰动:负载低时一起取90,负载高时一起取110,两种情况各占一半。总耗时仍然平均200毫秒,却只会取180或220,方差变成:
(1/2)×(−20)²+(1/2)×20²=400平方毫秒。
每个环节单独看,分布完全相同;总耗时的方差却翻倍。现实中的公共队列、共享网络等,可能让多个环节一起变慢。能否假设独立,需要来自运行机制的理由,不能由“记录在不同列里”推出。
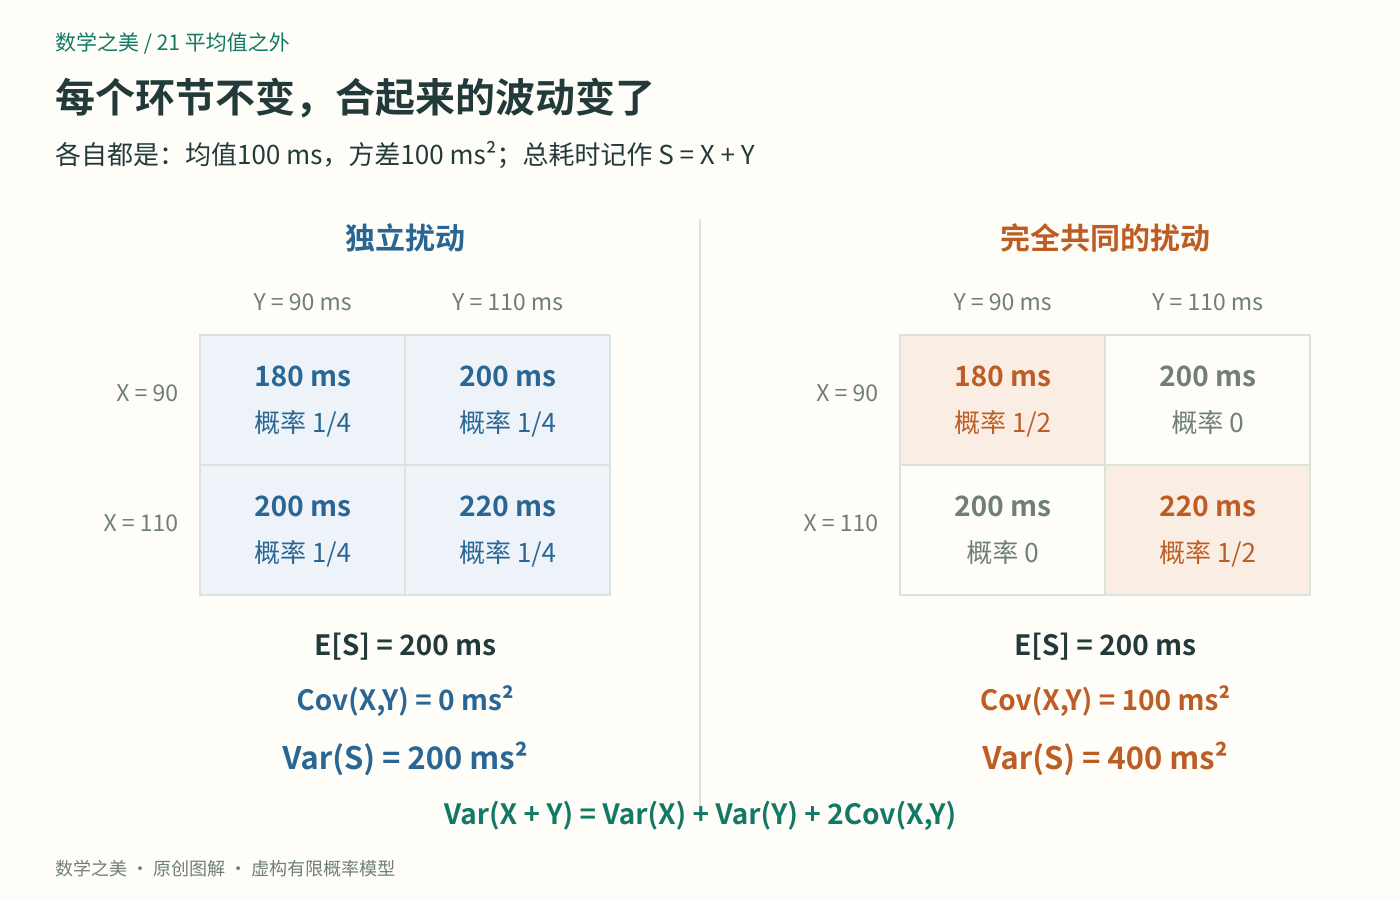
图2:每格先列总耗时,再列联合概率。两侧每个环节的90、110毫秒仍各占一半;改变的是配对方式。
把这种配对造成的影响单独记下来,就得到协方差:
Cov(X,Y)=E(X−EX)(Y−EY)。
两份偏离同号时乘积为正,异号时为负。把这些乘积加权平均,便能分辨共同偏高、共同偏低的作用,与一高一低的作用,哪边在这个模型里占上风。协方差的单位是X、Y单位的乘积。3
令U=X−EX,V=Y−EY。由于EX+Y=EX+EY,和的中心化偏离就是U+V。于是
Var(X+Y)=E(U+V)²
=EU²+2EUV+EV²
=Var(X)+Var(Y)+2Cov(X,Y)。
独立的情形中,协方差为0;共同扰动的情形中,U=V,协方差为EU²=100平方毫秒,恰好多出2×100。若协方差为负,和的方差反而会小于两项方差之和。正负号都来自同一个展开式。
独立能推出零协方差,反过来不行
为什么独立时协方差为0?记μ=EX,ν=EY,先展开定义:
Cov(X,Y)=EXY−νX−μY+μν
=EXY−νμ−μν+μν
=EXY−EXEY。
若X、Y独立,联合概率可以分解为P(X=x,Y=y)=P(X=x)P(Y=y),所以
EXY=∑x∑y xyP(X=x)P(Y=y)
=[∑x xP(X=x)]∑y yP(Y=y)
=EXEY。
这里对x、y遍历全部可能取值。能把双重求和拆成两个和的乘积,靠的正是联合概率的分解,而不是分别知道X、Y的分布就够了。
相减就得到0。因此独立变量的方差可以相加。独立性在这里用于分解联合概率,而没有用于上一节的平方展开。
这也提醒我们区分充分条件与必要条件:想让两项方差直接相加,零协方差已经够用;独立是一条更强、便于说明这一点的条件。不能因为发现方差恰好相加,就倒推两个环节彼此独立。
然而,协方差为0只能说明这一份乘积平均为0,不能说明变量之间毫无联系。取一个无单位的例子:X等概率取−1、0、1,令Y=X²。于是Y依次为1、0、1。
EX=0,EY=2/3,而EXY=(−1+0+1)/3=0,所以Cov(X,Y)=0。可一旦知道X,Y就完全确定了。例如P(Y=0)=1/3,但P(Y=0|X=0)=1,显然不独立。
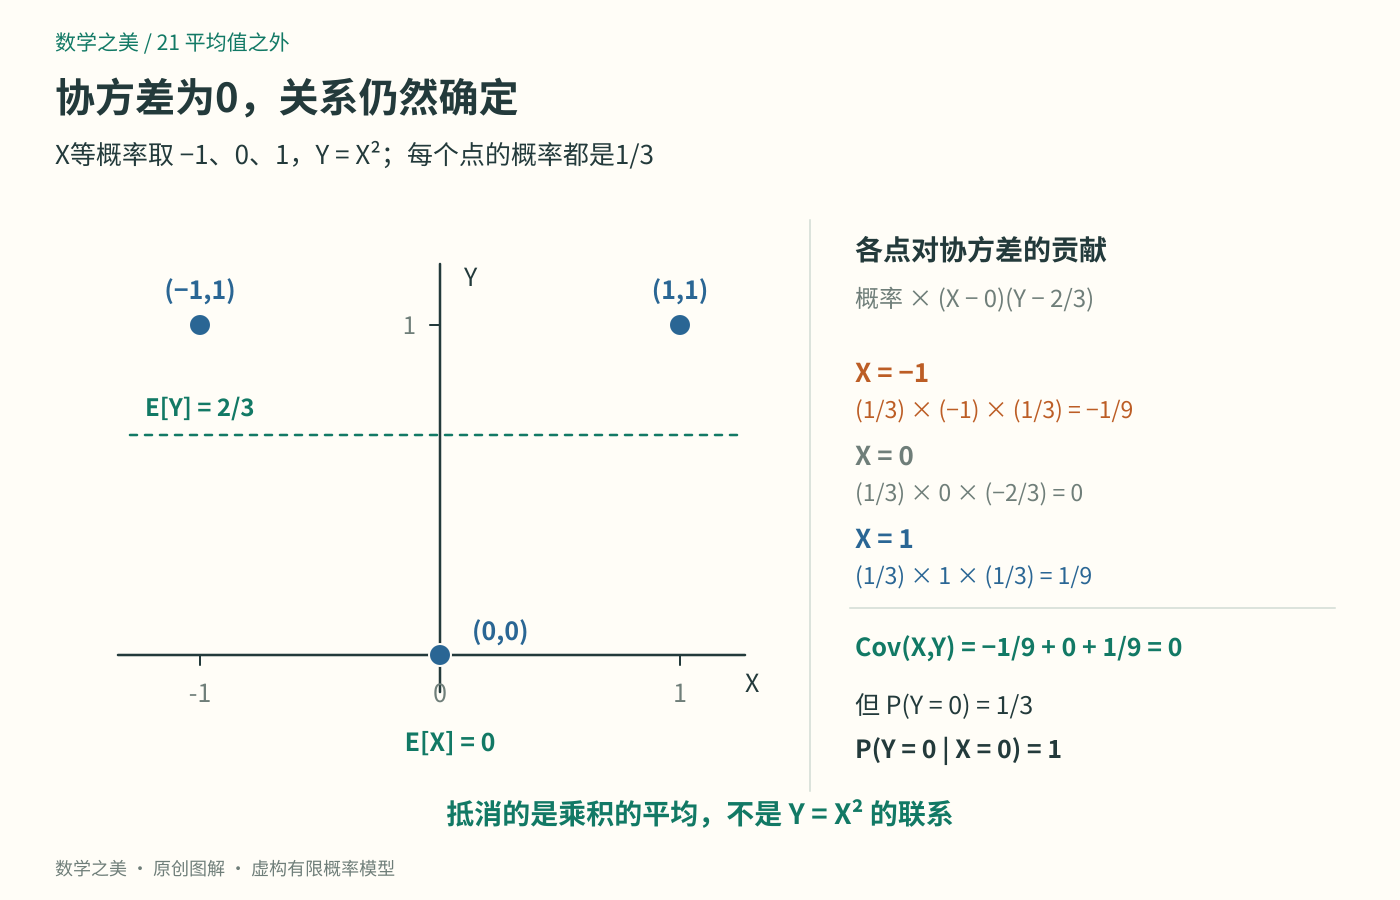
图3:竖轴所在的X=0与横向虚线Y=2/3,分别标出两个均值。左右两点对协方差的贡献相反,抵消的是这一种汇总量,不是Y=X²的依赖关系。
若要将协方差标准化,可以定义相关系数ρ=Cov(X,Y)/(σXσY),前提是两份方差都大于0。常量的标准差为0,分母也为0,不能照用此定义。上例Var(X)=2/3,Var(Y)=2/3−(2/3)²=2/9,两份方差都为正,相关系数也为0,但依然不独立。本章不需要靠相关系数继续计算,只需记住:把一类线性共同变化汇总成0,不等于排除了所有关系。
从告警的一次取值走向多次计数
回到第18—20章的告警台账。D表示确有故障,E表示发出告警。在低基准比例的10000个窗口中,198个发出告警。若从这张固定台账均匀抽取一个窗口,定义I在告警时取1,否则取0,就有p=P(E)=0.0198。
这种只取0和1的变量叫伯努利变量。一般地,若P(I=1)=p,则
EI=0×(1−p)+1×p=p。
因为0²=0、1²=1,所以I²=I,进而
Var(I)=EI²−(EI)²=p−p²=p(1−p)。
这里的p是总体告警率,不是告警中真故障所占的比例。后一个条件概率是P(D|E)=99/198=1/2,两者回答的问题不同,不能把0.5代入总体告警次数的模型。
记录n次,把告警指标相加,S=I₁+…+Iₙ就是告警总数。若每次告警概率均为p,期望线性性给出ES=np;若进一步假设这n次相互独立,所有成对协方差都为0,将和的平方展开便得Var(S)=np(1−p)。这条独立性需要另加,不是写下n个下标就已经拥有。
若仍使用固定台账,可以每次放回、重新独立均匀抽取一个窗口,构造满足上述假设的实验。不放回抽取时,前面抽到了什么会改变后续机会,就不能直接照用独立模型。若改成真实系统未来的连续窗口,还要核查告警率是否稳定、是否存在成串故障等,台账本身没有替我们保证这些条件。
尤其是,把同一次读数复制n份,得到的是S=nI。此时ES仍为np,但Var(S)=E(nI−np)²=n²p(1−p)。行数增加了,新的独立信息却没有增加。
下一章将换到告警集合,用抽样得到的真故障比例估计相应的p。那时指标变量在真故障时取1,p指告警中真故障的概率,不再是本节的总体告警率。我们已经准备好了两件工具:期望怎样相加,以及独立性怎样控制方差。还差一步:怎样把波动的大小,转成“偏差超过指定幅度的概率”这一更直接的问题。
顺手试一下
题目1: 系统C以相同概率耗时80或120毫秒。求它的均值、方差、标准差,以及超过500毫秒的概率。与A、B比较:仅凭均值能区分三者吗?标准差20毫秒能否单独保证任意系统都不会超过500毫秒?
提示: 先求相对均值的两个偏离;最后一问要区分“已知完整分布”与“只知道一个标准差”。
参考答案: EC=100毫秒,Var(C)=(20²+20²)/2=400平方毫秒,标准差为20毫秒。由明确的两个取值,P(C>500)=0。三者均值相同,不能据此区分波动;方差依次为0、9900、400平方毫秒。C不会超过500的依据是其完整分布,不能把标准差20普遍解释成结果偏离均值的上限。甚至同样均值100、标准差20的另一个模型,也可以以1600/1601的概率取99.5毫秒,以1/1601的概率取900毫秒:其均值仍为100,方差为1600×0.5²+800²/1601=400平方毫秒,却有非零的超时概率。
题目2: X、Y都以相同概率取90或110毫秒,现在让Y=200−X。求协方差、总耗时的均值和方差,并判断两者是否独立。
提示: X−100与Y−100符号相反;也可先直接算X+Y。
参考答案: 两种配对为(90,110)、(110,90),各占一半。中心化乘积恒为−100平方毫秒,因此Cov(X,Y)=−100平方毫秒。X+Y恒为200毫秒,均值200、方差0;公式也给出100+100+2×(−100)=0。两者不独立,例如P(Y=110|X=90)=1,而P(Y=110)=1/2。
参考与延伸
1 Hossein Pishro-Nik,《Introduction to Probability, Statistics, and Random Processes》,3.2.2 Expectation。核对离散期望的加权和定义及线性性。
2 同教材,3.2.4 Variance。核对方差、标准差、单位,以及方差展开式。
3 同教材,5.3.1 Covariance and Correlation。核对协方差、和的方差,以及零协方差不推出独立的限制。
本文服务、算例和图解均为原创教学构造;告警数字沿用本系列虚构台账。教材用于核对概念,不是这些系统延迟或告警数据的来源。
作者:Jiancheng Wang · 数学之美(独立原创)