先修:12 数据与损失;17 最小二乘投影;21 期望;22 独立样本的平均规律;23 可信评估;27—28 对数损失与条件预测
第17章已经为一条直线找到了全局最优的证明;第27—28章又把概率预测写成了对数损失。两种问题都出现了一个动作:调整模型,让某个数尽量小。
但在开始调整之前,那个数究竟是谁定的?把三次偏差加成一个分数,会保留什么,又会省略什么?进入变化与优化这一部,我们先把这件事说完整。目标写清以后,才轮到怎样高效地接近它。
先把任务写进算式
回到第12章的虚构玩具:已知滑杆位置x,预测指针读数y,两者都以厘米计。三条教学记录仍是(0,1)、(1,2)、(2,2),不是真实测量。模型也不变:
fθ(x)=ax+b,θ=(a,b)。
fθ表示“参数选为θ时的那条预测规则”。数据固定以后,要调的是a、b;不能为了压低分数,顺手修改观测值y。我们也只在这一族直线中选择,并没有允许每个点各用一套参数。
下一步,给一次预测定义损失。选平方损失时,
ℓ(y,ŷ)=(y−ŷ)²。
ℓ是一个规则:输入真实读数与预测读数,输出非负的单次费用。例如用候选C:a=1/2、b=7/6,在中间点x=1预测5/3厘米,而观测为2厘米。这次残差是1/3厘米,单次损失便是1/9平方厘米。
把三次损失相加,才得到关于参数的整体目标:
L(a,b)=Σᵢ₌₁³ℓ(yᵢ,axᵢ+b)
=(1−b)²+(2−a−b)²+(2−2a−b)²。
这就是SSE。单次损失ℓ回答“这一次怎样计分”,目标函数L回答“这批记录怎样合计”。有时两者都被简称为损失函数,读公式时要看清求和有没有发生。
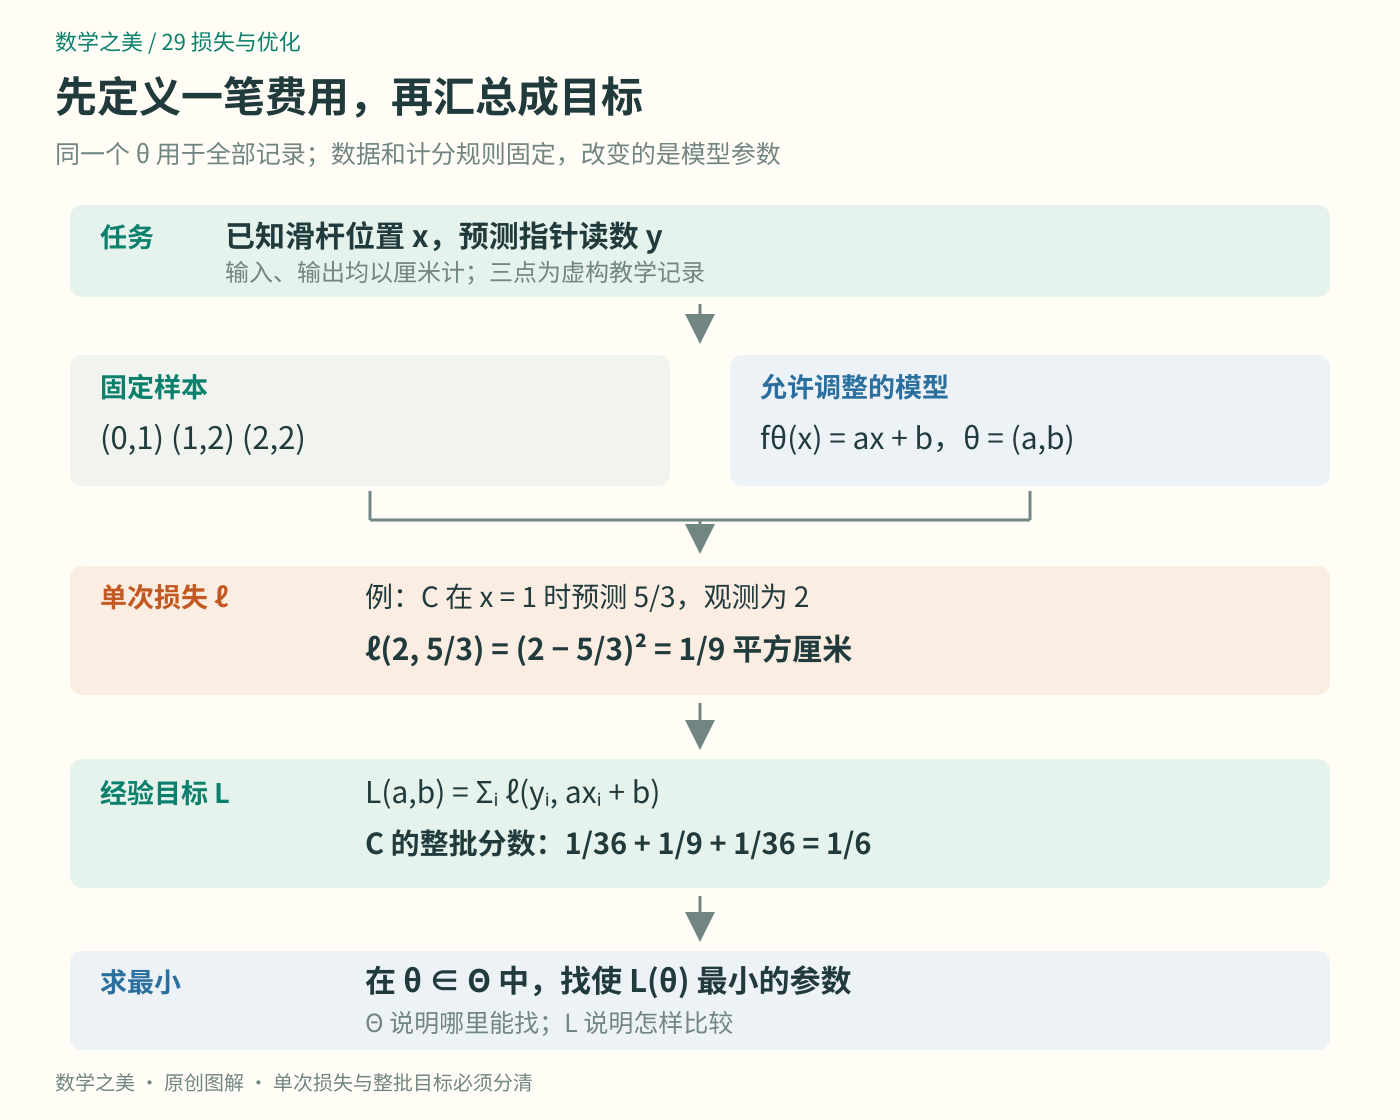
图1:实线串起本章的计算过程;任务要求还要决定采用什么损失与权重。图中的数值来自候选C的一次预测,不能直接当成整批分数。
合计也会丢掉信息。两组残差可以得到同一个平方和,却把偏差集中在不同位置;总分相同,并不表示每个位置都同样准确。为了找参数,我们暂时采用一个共同的比较数;为了理解模型哪里出了问题,仍应保留逐条残差和输入位置。把它们汇成一个数,不必同时把原记录扔掉。
如果取平均,得到MSE=L/3。一般在固定的同一批n条记录上,MSE=SSE/n,n>0,因此两者给出的参数排序、最优参数完全一样。C的SSE为1/6,MSE为1/18,单位都为平方厘米。它们只是总和与平均的区别;换了样本数量或内容,不能再凭这句比例关系断言分数可直接比较。
“求最小”还需要说明在哪里找
现在把任务正式写成一个优化问题:[1]
在(a,b)∈R²中,最小化L(a,b)。
R²在这里表示a、b都可以取任意实数。若把允许的参数集合记为Θ,通用写法是
θ*∈argmin₍θ∈Θ₎ L(θ)。
argmin收集使目标达到最小的参数,min给出的则是最小目标值。对当前问题,第17章已经证明:θ*=(1/2,7/6),而min L=1/6平方厘米。参数答案与分数答案,不能混为一谈。一般问题也可能有多个最优参数,或根本无法达到最小值;写出符号不等于已经证明答案存在。
假如玩具的使用要求另有依据,规定斜率和截距都不能为负,就把Θ改成{(a,b):a≥0,b≥0}。这叫可行集合,约束负责排除不允许的候选,损失负责比较留下的候选。仅有“a、b非负”并不能告诉我们哪一条线更好。
本例的C满足这两个约束,所以原来的最优答案仍可保留。但由此得到的结论始终是:在选定集合里,按选定目标,这条线最优。一个低分无法反过来证明,真实玩具就应当用直线描述,或者平方惩罚就代表使用者的实际需要。
同样三次偏差,换权重就会换选择
第12章已经看到,换一种损失会改变偏好。现在连单次平方损失都不换,只改变各次记录的权重。
假设我们明确约定:中间位置的平方偏差,按两倍费用计;两端各按一倍。这是新的计分要求,不是从三条数据里发现的自然规律。相应目标为
Lw(a,b)=(1−b)²+2(2−a−b)²+(2−2a−b)²。
一般的加权平方和写成Σᵢwᵢ(yᵢ−fθ(xᵢ))²;权重决定各项如何参与合计。[2] 本例w=(1,2,1)没有单位,故Lw仍以平方厘米计。
拿C与第12章练习中的D比较。D保持a=1/2,把b改为5/4。两者残差依次为
C:(−1/6,1/3,−1/6)厘米;
D:(−1/4,1/4,−1/4)厘米。
等权时,C的平方和为1/36+1/9+1/36=1/6;D为1/16+1/16+1/16=3/16。因为1/6<3/16,C胜出。
中点加倍后,必须重新逐项结算:
Lw(C)=1/36+2×1/9+1/36=5/18;
Lw(D)=1/16+2×1/16+1/16=1/4。
于是5/18>1/4,排序反过来了。D牺牲了一些两端表现,把中间残差从1/3降到1/4;中点更贵时,这笔交换就变得划算。
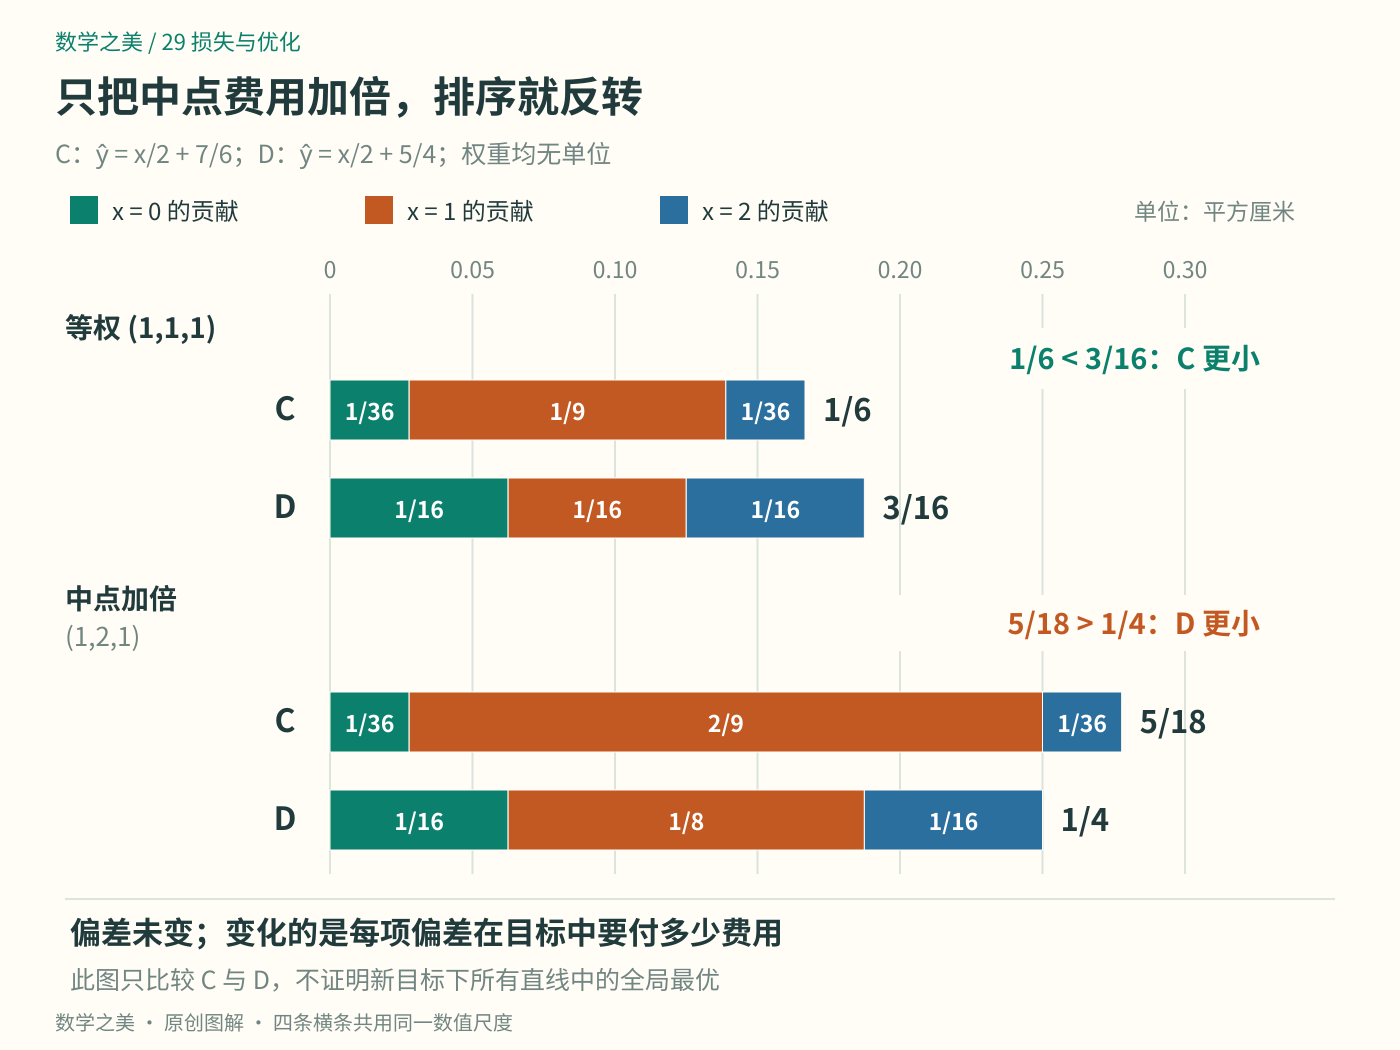
图2:四条堆叠条使用同一长度尺度,三个色块依次对应x=0、1、2;第二组只把中间色块的贡献翻倍。两组目标分别排序,不能跨组直接比较谁的任务表现更好。
这次翻转说明,权重是问题的一部分。应先根据使用需要交代理由,再比较候选;如果只是看到谁赢,就反复调权重直到喜欢的模型胜出,那是在改变题目,不能当成该模型天然更好的证据。
到这里,我们证明了D在新目标下胜过C,还没有仅凭这场比较证明D胜过所有斜率与截距。可以再做一个范围明确的小证明:固定a=1/2,只允许上下平移。
Lw(1/2,b)=(1−b)²+2(1.5−b)²+(1−b)²
=2(1−b)²+2(1.5−b)²
=4(b−1.25)²+0.25。
最后一步只是展开、合并,再配成平方。平方项非负,且只在b=1.25时为0,所以D确实是这个固定斜率子问题的唯一最优解,最小值为0.25平方厘米。这个证明没有检查改变a的候选,结论的范围也就止于这里。
一个数的标尺与含义都要交代
本章用非负权重:wᵢ≥0。某项权重为0,表示它不影响这个目标;这不代表对应观测已被证明无用。若权重全为0,所有参数的加权平方和都为0,目标不再提供任何区分信息。负权重则可能奖励更大的偏差,不符合这里“累计错误代价”的约定。
若把全部权重乘同一个正常数c,新目标就是cLw。任何两组参数的大小关系不变,最优集合也不变;但同一次参数改动造成的目标差值会乘c。最优位置相同,不等于目标的变化尺度相同,后面讨论调整方法时还会回来处理这一点。
当权重和大于0时,也可除以Σᵢwᵢ得到加权平均。分母固定且为正,仍不改变当前问题的最优者。要说“平均”时必须注明分母,不能把除以样本数与除以权重和混用。
权重的解释也不能只写“重要性”。它可能表达某些使用位置更值得照顾,也可能用于处理不同测量精度;这两种理由需要不同依据,不能随意互换。本例只约定前一种计分偏好,并未证明中间读数更可靠。
单位会提醒我们自己究竟在算什么。绝对误差平均以厘米计,平方误差平均以平方厘米计;取平方根才得到以厘米计的RMSE。第27章的有限分类概率预测则可用ℓ(y,q)=−log₂q(y),对实际结果要求q(y)>0以得到有限值,费用以位计。平方损失衡量数值偏差,对数损失评价给实际类别分配的概率;不能因为0.1小于0.2,就把两个不同目标下的数拿来排模型高下。
即使仍用平方损失,单位变化也会改分数:把输出读数与预测同时从厘米换成毫米,数值残差乘10,平方目标乘100。模型描述的物理预测未变。因此报告结果时,目标定义、单位、样本范围与汇总方式,都属于分数不可省略的说明。
若还想把预测误差、等待秒数和误判费用合成一个总分,必须明确换算系数与取舍依据。把单位调成一致,只解决能否相加,没有证明这种交换公平或合适。允许等待多久、哪类错误不能接受,往往需要单列要求,不能指望一个数字自动替人作出决定。
样本上的目标与未来的期望
把平方损失换成一般的ℓ,在n条记录上取平均,就得到经验风险:[3]
Rₙ(θ)=(1/n)Σᵢ₌₁ⁿℓ(yᵢ,fθ(xᵢ))。
这里n>0,“经验”指眼前这批已记录的数据。寻找使Rₙ最小的模型,叫经验风险最小化。我们的三点例中,R₃就是MSE;它和L描述同一批记录,但采用平均的尺度。
实际使用时,我们通常还关心未来。若用P表示目标使用情景中输入X与结果Y的联合分布,相应的期望风险是
R(θ)=E₍X,Y₎∼P[ℓ(Y,fθ(X))]。
Rₙ逐项使用手里的记录,R对目标分布中可能遇到的情形求期望。这里的P需要由任务说明,通常并不完全已知。三条虚构读数没有附带抽样模型,不能据此把经验平均宣布为真实玩具的未来平均。
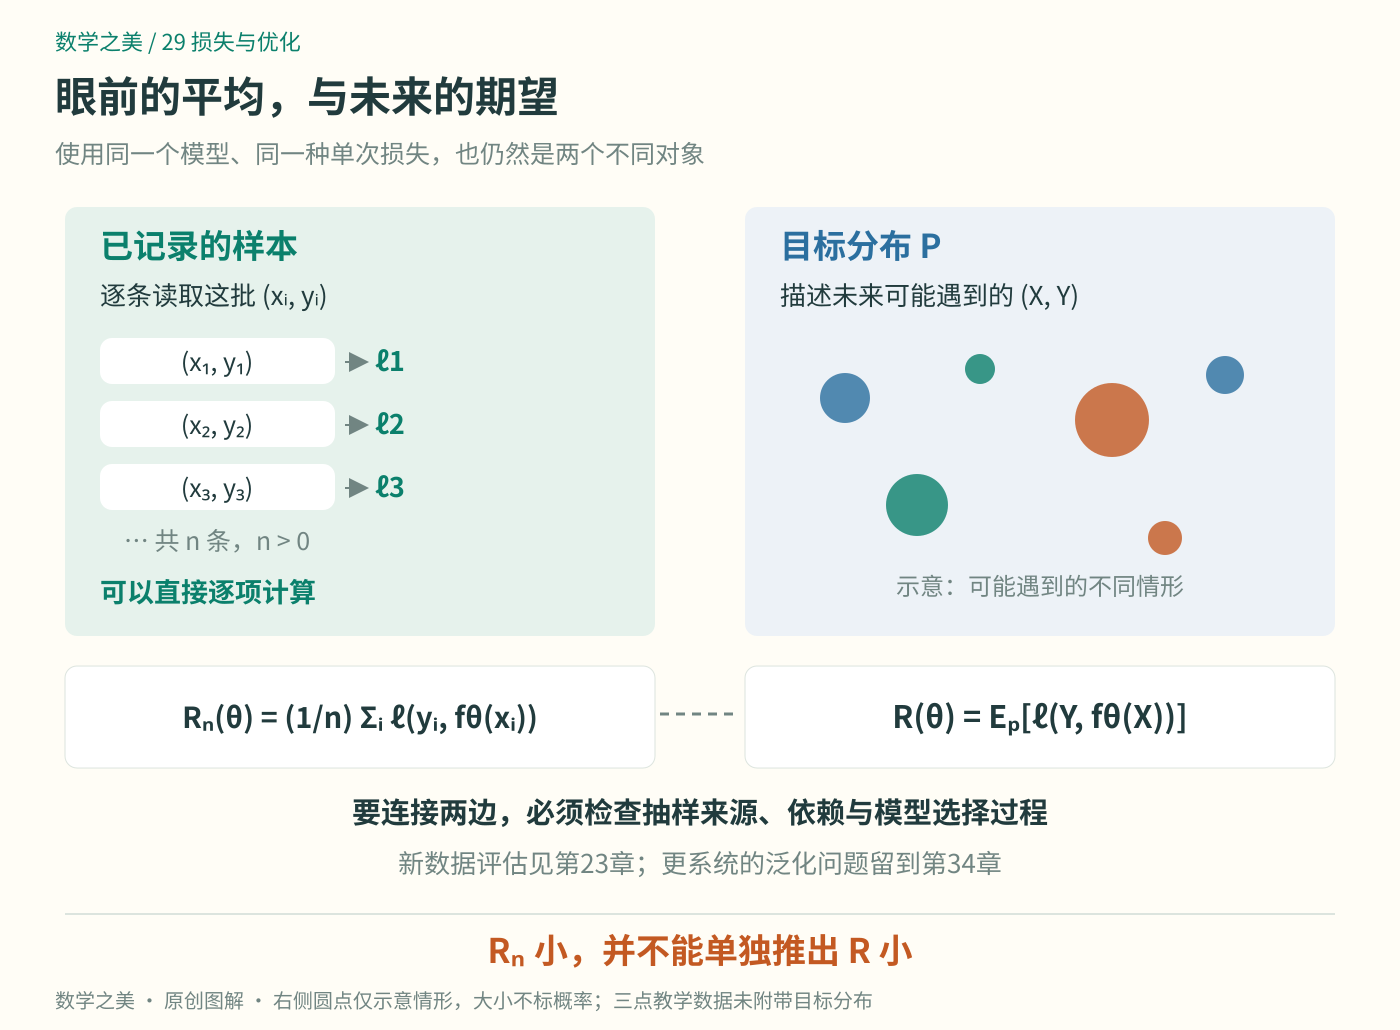
图3:左侧求和遍历已见记录,右侧期望遍历目标分布。连接两边的是需要检查的假设与证据;图中没有把一次训练结果当成未来保证。
例如,先在第19—22章的有限概率模型内考虑事先固定的模型。若记录独立同分布地来自P,且各情形的损失都是有限值,单次损失就有有限方差,记为σ²。沿用第21—22章的计算,E[Rₙ(θ)]=R(θ),独立性给出Var(Rₙ(θ))=σ²/n;再把第22章的非负变量取成[Rₙ(θ)−R(θ)]²,便得到对任意ε>0的界:
P(|Rₙ(θ)−R(θ)|≥ε)≤σ²/(nε²)。
这个上界随n增大而趋于0,说明在这些条件下,样本平均能以越来越高的概率接近期望。本段只用前文已建立的有限模型论证,不在这里宣称更一般的大数定律。若参数也是看着同一批数据选出的,就必须把选择过程带来的影响一并考虑;不能把“固定模型”的推理直接搬给训练后的赢家。
目标分布也可能与采样来源不同。专门在三个易操作位置收集记录,并不等于未来滑杆只会到这三处;各处使用频率不同,平均时的分量也可能不同。把一张训练成绩单算得再精确,都不能补上这些缺失条件。
未见数据上的评估、记录单位、来源与时间变化,回到第23章的方法检查;更系统的泛化问题留到第34章。现在只需牢牢记住:Rₙ小,不自动推出R小;把Rₙ求到最小,也不能单独回答目标是否选对。
目标明确之后,怎样动参数
本章完成了优化之前的一次翻译:说明预测任务,固定样本与模型,选择单次损失和汇总方式,写明可行集合,再询问其中哪个参数让目标最小。
接下来我们暂时回到等权平方和,固定a=1/2。同样用配方,可以把目标写成
L(b)=3(b−7/6)²+1/6。
这里每个b对应一个分数;把b稍微增加一点,分数究竟下降还是上升?每改动一点,变化有多快?第30章将从这种局部变化出发,引入导数。我们已经说清想降低什么,现在开始研究怎样有根据地调整。
顺手试一下
题目1:中间位置多重要,排序才翻转?
两端权重仍为1,把中点权重改为t≥0。求C、D各自的加权平方和,并找出两者打平的t。这个结果是否证明其中一个是所有直线中的最优者?
**提示:**分别写成(1+2t)/18与(2+t)/16,通分比较。
**参考答案:**C为(1+2t)/18,D为(2+t)/16,差值C−D=(7t−10)/144。t=10/7时打平;t<10/7时C更好,t>10/7时D更好。单位为平方厘米。这里只比较了两个候选,不能据此宣布全局最优。
题目2:分数变小了,预测改善了吗?
某人把等权SSE改成MSE,发现C的分数从1/6变成1/18,于是宣称“错误减少了三分之二,未来表现也会更好”。另一个人说,只要再限制a≥0、b≥0,就不必选择损失了。两句话分别错在哪里?
**提示:**检查预测是否改变、分数的分母是什么,以及约束能否给可行候选排序。
**参考答案:**三点上的预测没有变,只是总和除以3;分数的数值变小不代表偏差减少,也没有新增未来评估证据。非负约束只限定可选参数,许多不同直线都满足,仍需损失来比较。C本已可行,加入这些约束也不会改变它在当前等权平方和问题中的最优性。
参考与延伸
[1] Stephen Boyd、Lieven Vandenberghe、Parth Nobel,Stanford EE364a,Introduction,讲义1.2—1.4、1.7。核对变量、目标、约束的分工及模型参数的优化表述;本文不展开凸性与求解算法。
[2] NIST/SEMATECH,e-Handbook of Statistical Methods:Weighted Least Squares,§4.4.3.2。核对加权平方和及优化时数据、权重固定而参数可调的含义。本文的权重用于明确的教学计分要求,不把它当成已估计的测量精度。
[3] Shai Shalev-Shwartz、Shai Ben-David,Understanding Machine Learning: From Theory to Algorithms,§2.2、§3.2.2,作者提供PDF的第35、48页。核对经验风险、期望风险与一般损失的定义;两者差别在本文沿用的三点例中另行说明。
本章沿用第12、17章的虚构三点读数和候选C、D;权重比较、配方、练习与三幅图为独立教学编排,不代表真实系统的测量或评估结果。
作者:Jiancheng Wang · 数学之美(独立原创)