先修:01 建模时的目标与假设;02 命题、必要条件与充分条件;03 图与可达性
程序能处理一张长达百万行的表,每次却只能执行眼前的几条指令。我们怎样知道,这些小步骤连起来,最后会给出正确答案?
先把问题缩小。一份记录里有五次请求的耗时,依次是12、7、19、15、9毫秒。我们想找出其中最大的数。眼睛扫一遍,就知道答案是19;如果记录多到放不进一屏,程序会怎样做?
一个朴素办法是从左往右看,手里始终留着“目前见过的最大值”。新来的数更大,就换成它;否则保留原值。这个办法看起来很可靠。本章要走完更重要的一步:给出一个理由,说明它对任意长度的合格输入都可靠。
把已经做完的事说准确
先约定输入:它是一份有限、非空的整数列表,计算过程中内容不变。我们只求最大值,重复出现的最大值算同一个答案;空列表如何处理,暂时放在约定之外。这些是算法的前置条件,也就是开始运行时必须满足的要求。
用两个小记号记录进展:i表示已经看过多少项,M表示手里保留的值。共有多少项,记作n。字母只是给三个量取短名字,并没有增加新的运算。
先看第一项12,于是i=1,M=12。接着读7,M仍是12,i变成2。再读19,M换成19,i变成3。随后读15和9,M都不用换;最后i=5,M=19。
注意这几个时刻共同成立的一句话:M等于前i项的最大值。i与M都可能变化,这句话在每轮检查时始终成立。
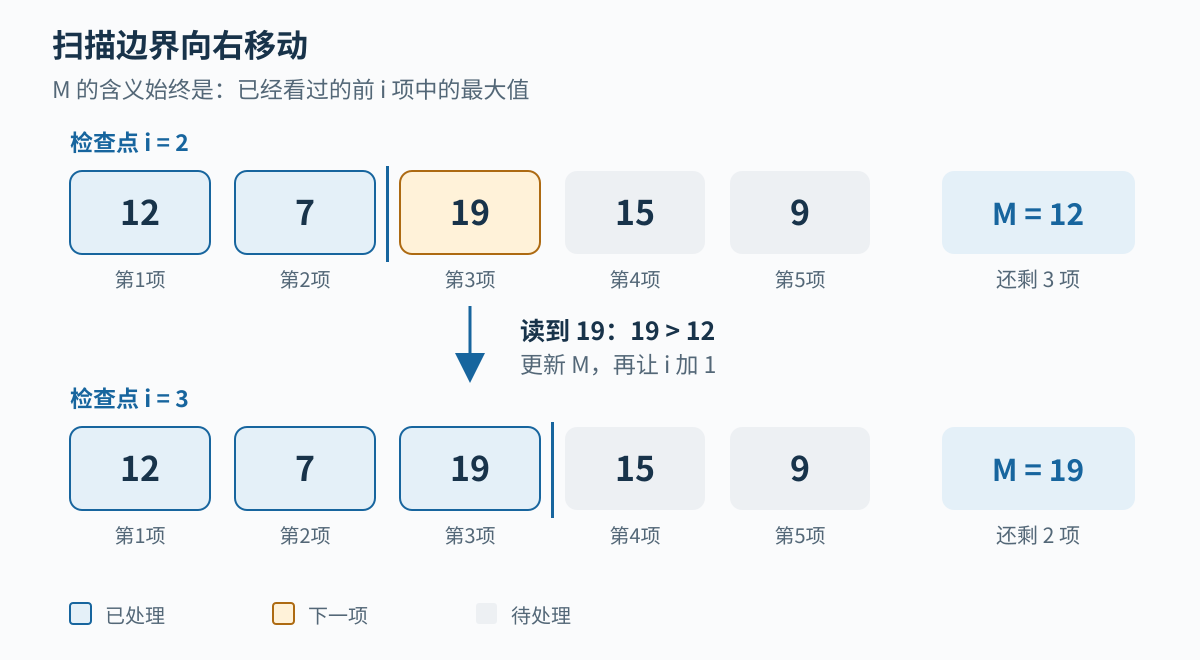
图1:上方已经看过12、7,M=12;把下一项19纳入后,下方已经看过三项,M=19。蓝色区域代表已经处理的前缀,灰色区域仍待处理。
这样的陈述叫作循环不变量。“循环”指重复做同一组步骤;“不变量”指在约定检查点始终为真的关系。这里把检查点放在每次判断“还有没有下一项”的地方,包括第一次判断,以及最后一次判断。这个位置约定很重要,一轮内部修改变量的中途,关系可以暂时尚未恢复。康奈尔大学的循环不变量讲义也采用这样的检查方式。
为了把边界和最大值都交代清楚,我们将不变量完整写成:
- i是整数,而且1≤i≤n
- M是前i项中的某个值,并且不小于前i项中的每一项
“某个值”保证答案确实来自已经看过的输入,“不小于每一项”保证没有已读数字超过它。两句合起来,正好表达“前i项的最大值”。
用中文伪代码把动作固定下来。这里各项从第1项开始编号;箭头表示把右边的值存进左边的变量。
n ← 列表的项数
i ← 1
M ← 第1项
当 i < n 时,重复:
    如果第 i+1 项 > M,就令 M ← 第 i+1 项
    i ← i+1
返回 M
每轮处理一项,再把已处理项数加1。这组动作足够简单,能够逐条核对。
一条承诺怎样走到最后
证明要回答三个问题:开始时成立吗?做完一轮还能成立吗?结束时它能推出我们要的答案吗?
初始化。 刚开始,i=1,M取第一项。由于列表非空,第一项存在,1≤i≤n。前一项只有它自己,它当然既属于这一小段,也不小于这一小段中的任何数。因此,第一次到达检查点时,不变量成立。
保持。 假设某轮开始时,不变量成立,而且i<n,确实还有下一项。先把此刻的i叫作“旧i”,新读的数叫作x,它就是第旧i+1项。
如果x大于旧M,程序把M换成x。旧M已经不小于之前每一项,x又大于旧M,所以x不小于扩展后的每一项,而且x本身就在扩展后的这段里。
如果x不大于旧M,程序保留M。它原本不小于旧的每一项,现在也不小于x,仍然来自已经看过的那段。
两种情况都说明:处理完x后,M是前旧i+1项的最大值。随后把i加1,于是M恰好对应前新i项。旧i<n还保证了新i≤n,范围约束也保留下来。下一次到达检查点时,整条不变量重新成立。
退出。 循环停止时,“i<n”已经不成立,所以i≥n;不变量又告诉我们i≤n。两者合在一起,只能得到i=n。此时“前i项”就是全部输入,M因而是整份列表的最大值。我们返回它,正好满足目标。
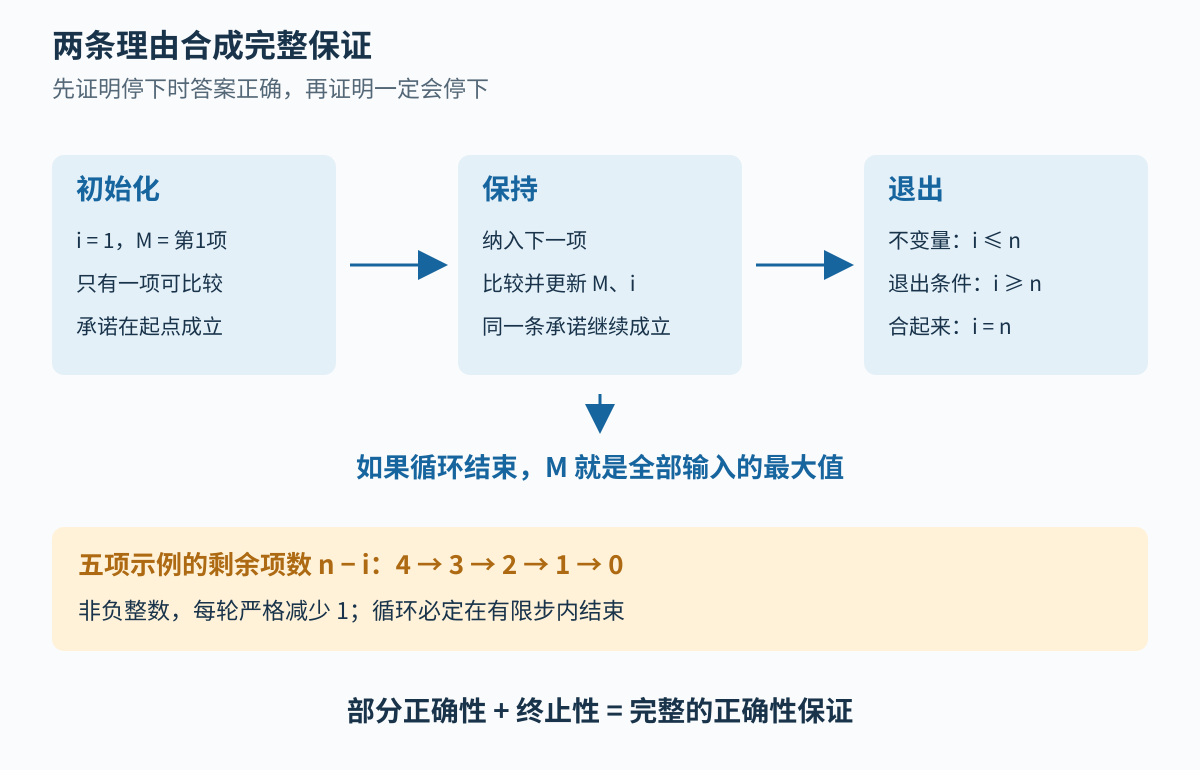
图2:蓝色路径回答“停下时结果为什么正确”。橙色路径另行检查剩余项数,回答“为什么一定会停下”。
这段证明没有逐个列出一百万轮。它只研究了一轮,却把这一轮放在任意位置:只要进入它时承诺成立,走出它时承诺就继续成立。
背后的数学叫作归纳法。设想完成零轮时的检查点,初始化已经保证了它正确;保持步骤把这个保证传到完成一轮之后,再传到完成两轮之后。对于任何一个实际到达的有限轮数,都可以这样接下去。保持步骤中的“假设成立”,是推导下一轮的前提;初始化给这条推导链提供了确实成立的起点。
这也解释了证明与试跑的区别。试跑五项数据,可以检查这五项执行得怎样;上述保持论证没有用到12、7、19这些具体数字,使用的只有大小关系和输入约定。因此,同一段理由适用于任何满足约定的列表。
结果正确,还需要等得到
到这里,我们得到了一个带条件的结论:如果循环结束,返回值就正确。这个性质叫作部分正确性。“部分”提醒我们,程序是否会结束还没交代。
在本例里,还剩多少项没看,是一个现成的量:n-i。刚开始是4,随后依次变成3、2、1、0。对任意合格输入,这个量都是非负整数,每完成一轮就严格减少1。有限的非负整数无法这样永远减少,最多经过n-1轮,剩余项数就到0,循环条件随之变假。每轮里的比较与赋值本身也会在有限步骤内完成。
这个用来衡量“离结束还剩多少”的量,叫作终止度量。把终止性与前面的部分正确性合起来,就得到全正确性:在约定条件下,算法会结束,并返回正确答案。
这里的“整数”值得停下来想一想。假设另有一个过程:从x=1开始,只要x>0,就把x除以2。现在使用精确的数学数值,得到的依次是1、1/2、1/4、1/8……
x每次都严格变小,也始终有0这个下界,可是经过任何有限次除法,结果仍大于0。循环永远等不到它精确等于0。可见,“每次下降,而且不会低于0”还不足以证明终止;非负整数额外保证了每次严格下降至少跨过一个整数单位。
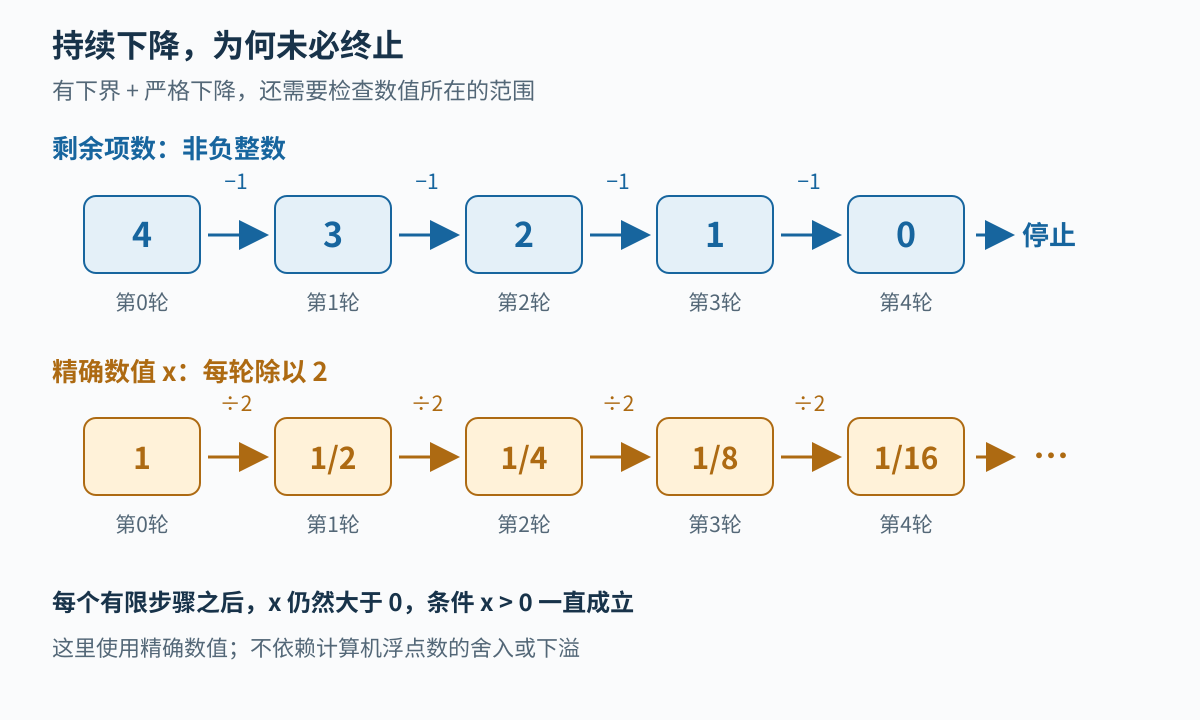
图3:上方剩余项数每轮减少1,四轮后为0;下方精确数值每轮减半,任何有限轮之后仍大于0。下方不使用计算机浮点近似。
现实中的浮点数可能因舍入或下溢变成0,那属于另一套数值模型,不能用它替上面的精确数过程证明终止。第一章强调过,结论始终带着模型假设;这里又遇到了同一个边界。
这套方法也进入了实际工具。Dafny的官方终止教程介绍了decreases标注:写出一个每轮变小、且不能无限下降的量,让验证器检查终止性。我们的n-i就是这类最简单的度量。工具可以检查推理义务,前提与目标仍需要人说明白。
从一小段扫描,走到软件内部
找最大值很小,却暴露了软件正确性的一个关键结构:输入有约定,中间状态有含义,每个动作都要维持这个含义,退出条件再把中间承诺接到最终目标。
例如,一个AI分类模块给候选类别打分,选择模块再取最高分。当分数列表非空、分数可正常比较时,后半段就能采用这种扫描结构。证明可以保证它选中了输入分数中的最大值;分数是否真实反映类别的合适程度,需要另外的证据。代码满足规格,与规格解决了实际问题,是两个都需要检查的环节。
同样,AI写出一段循环后,我们可以要求它解释i表示什么、哪些项已经处理、结果在哪个检查点成立,再逐项核对。可执行的代码和看似流畅的解释,都值得接受这些具体检查。
回到上一章的图,类似的承诺可以是“已经发现的每个节点,都能从起点到达”。若新节点通过一条从已发现节点出发的边加入,这个承诺就有了保持的依据。至于是否找全所有可达节点,以及路线是否最短,还需要各自的条件与论证。
许多算法的困难,藏在这种中间承诺里。局部动作要保住的关系一旦说准,我们就能看见它怎样一步步覆盖更大的范围,也能找到某次修改究竟破坏了哪一环。
顺手试一下
题目1:
把输入换成8、3、11、11、6,沿用本章算法。
- 看完前三项时,i、M和剩余项数各是多少?接着读到第二个11时,程序会不会更换M?
- 如果把比较条件“新项>M”改为“新项≥M”,最终返回的最大值会改变吗?本章是否保证返回最大值第一次出现的位置?
提示:
把“数值是多少”与“它来自哪一项”分开看。再核对我们一开始到底承诺返回什么。
参考答案:
- i=3,M=11,剩余项数为5-3=2。下一个11不大于当前M,所以按原算法不会更换M;i仍会增加到4,剩余项数变成1。
- 改为≥后,遇到相同值时也会赋值,但11换成11,最大值仍是11。本章算法没有保存位置,也没有承诺返回首次出现的位置。若要满足那个目标,需要增加记录位置的变量,并补上相应的不变量。
作者:Jiancheng Wang · 数学之美(独立原创)