先修:07 计数;19 有限概率模型;21 期望;24 无损编码与前缀码;25 信息量与对数
第24章为四个符号安排了长短不同的码字:A用0,B用10,C用110,D用111。常见的符号走短路,少见的走长路。一个八符号样例因此从16位缩到14位。
但一个例子省了两位,不等于找到了极限。能不能再换一棵码树,让平均长度更短?要回答,先得找到所有合法码树都逃不开的限制。
这一章把两件看似不同的东西接起来:树上有限的位置,与概率加权的平均数。最后得到的下界叫熵。它不是某个压缩软件的经验成绩,而是在明确编码条件下可以证明的限制。
先写清“平均”在平均什么
设随机符号Y只取A、B、C、D,概率分别为1/2、1/4、1/8、1/8。这是用于推导的已知分布模型,不是凭一段短消息就确认的真实规律。把这些概率依次记为pᵢ,下标i表示第几个符号。
码字长度记为ℓᵢ。它必须是非负整数,因为二进制码字只能包含非负整数个0或1。只要需要区分至少两个符号,前缀条件就不允许空码字,所有长度至少为1。按第21章的期望定义,平均码长为
L=Σᵢpᵢℓᵢ。
原来的长度是1、2、3、3,所以L=(1/2)×1+(1/4)×2+(1/8)×3+(1/8)×3=7/4,即1.75位/符号。固定两位编码则有L=2。
这里1.75不是说某个符号用了四分之三个位,也不是每段八符号消息都恰好需要14位。实际长度由出现了哪些符号决定;在这个模型下,把长度按概率加权才得到1.75。
本章只比较二进制前缀码的正文码长:一个码字不能是另一码字的开头,接收者沿树走到叶子即可认出符号。发送方与接收方已共用码表、符号数量或消息结束规则;码表、封装等额外开销不包含在L里。若比较完整文件大小,必须把这些也加回来。
一个短码字,会占掉多少位置
假设所有码字里,最长的有m位。先画一棵完整的m层二叉树,它最底下有2ᵐ个位置,每个位置代表一种m位串。
一个长度为ℓᵢ的码字,占据了深度ℓᵢ处的一个节点。把它往下延长到m位,会得到2^(m−ℓᵢ)个不同后缀。因为它已经是一个完整码字,这些后代不能再分给另一个符号,否则就违反前缀条件。
不同码字占住的后代集合互不重叠,而底部总共只有2ᵐ个位置。因此
Σᵢ2^(m−ℓᵢ) ≤ 2ᵐ。
两边除以2ᵐ,就得到
K=Σᵢ2^(−ℓᵢ) ≤ 1。
这叫Kraft不等式。1 长度为1的码字占一半容量,长度为2的占四分之一,长度为3的占八分之一。短码字不是可以无限分发的优惠:给它多一点位置,其他符号就得让出位置。
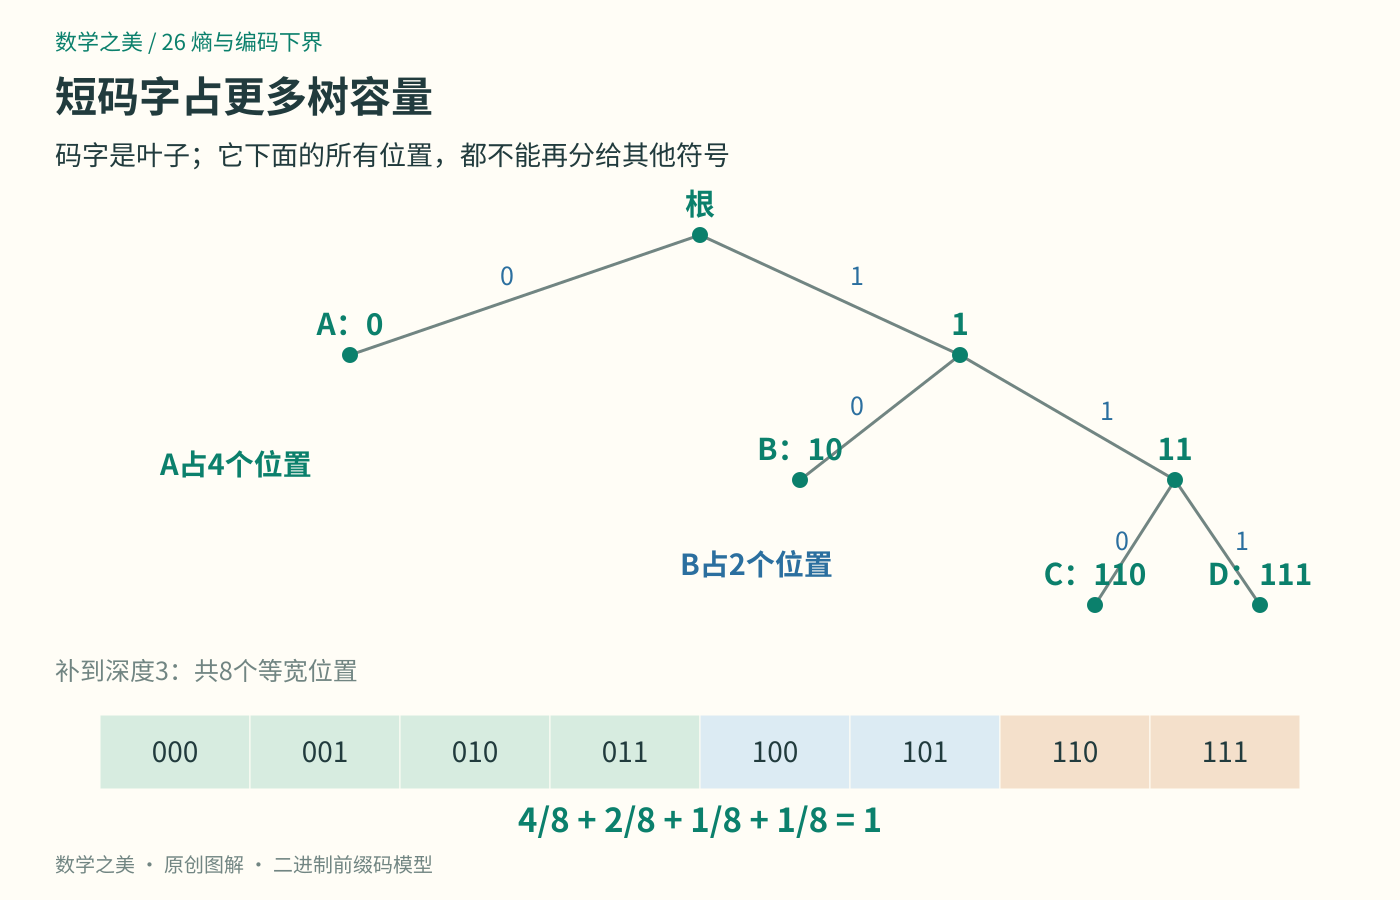
图1:A的0占住全部0开头的位置;B的10占住10开头的位置。最后8个位置恰好用满,所以K=1/2+1/4+1/8+1/8=1。
例如想给三个符号都分配一位,就会要求3×1/2≤1,显然不成立。给三个符号安排1、2、2位则可以:0、10、11正好是一组前缀码。限制针对的是整张码表,不能只盯着某个特别短的码字。
从树的容量,走到概率的下界
下一步需要一条明确的不等式。对正数aᵢ和正权重pᵢ,若Σᵢpᵢ=1,则加权几何平均不超过加权算术平均:
∏ᵢ aᵢ^(pᵢ) ≤ Σᵢpᵢaᵢ。
∏表示把各项相乘,与Σ表示相加对应。两个数、各占一半时,这就是√(ab)≤(a+b)/2,直接来自(√a−√b)²≥0。一般形式的依据放在文末推导补充中;这里先使用它。2
现在把aᵢ选成2^(−ℓᵢ)/pᵢ。先只讨论概率全部为正的有限符号表。右边立即变成
Σᵢpᵢ2^(−ℓᵢ)/pᵢ=Σᵢ2^(−ℓᵢ)=K≤1。
于是左边也不超过1。对两边取以2为底的对数,乘法变加法,得到
Σᵢpᵢ−ℓᵢ−log₂pᵢ ≤ log₂K ≤ 0。
把L=Σᵢpᵢℓᵢ移到另一边,就有
L ≥ −Σᵢpᵢlog₂pᵢ。
右边正是第25章单次信息量−log₂pᵢ的期望,定义为这个分布的熵:
H(Y)=−Σᵢpᵢlog₂pᵢ。
因此,每一种这样的前缀码都满足L≥H(Y)。我们并没有枚举所有码表,而是从所有码表共有的树容量限制,推出了一个共同下界。[1]3
对四符号模型,H=(1/2)×1+(1/4)×2+(1/8)×3+(1/8)×3=7/4。原来的码表恰好达到这个数,所以它已经是该分布下平均码长最小的前缀码。第24章只展示了节省,现在才有了“不能更好”的证明。
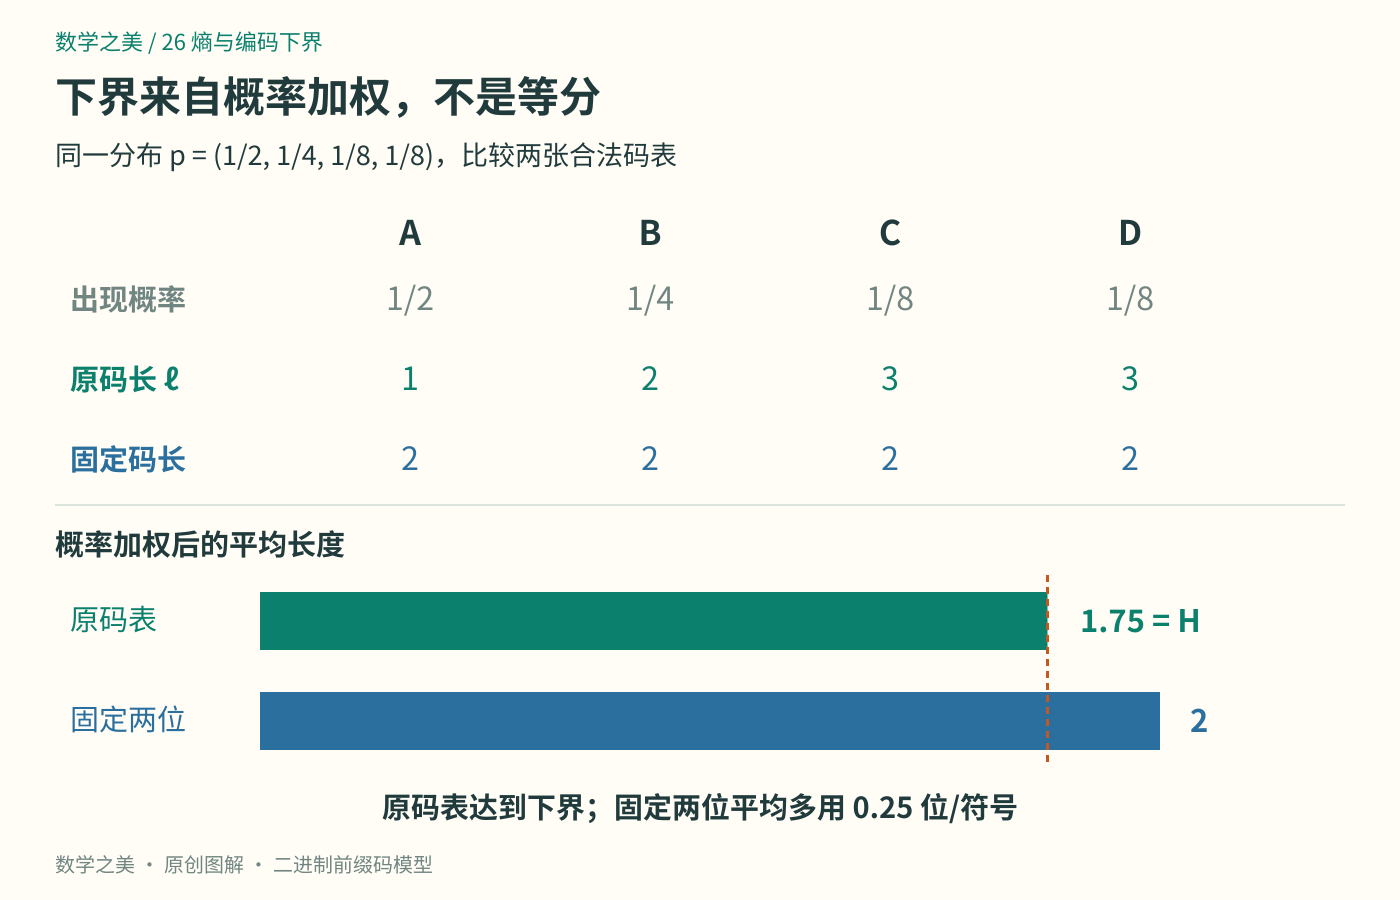
图2:两张码表都可以无损恢复。差别在于怎样把有限的短码字位置分配给各个概率。比较的是同一分布下的期望正文长度。
若符号概率为0,它对期望没有贡献,约定0log₂0=0;可以先从概率模型的支持集中去掉它。不过,工程格式若仍必须接收这种符号,就仍要为它准备码字或转义方案,不能把“样本里没见过”草率当作永远不可能。
达到下界,需要什么条件
刚才的证明包含两次不等式。若想最终取等号,树容量必须用满,即K=1;加权均值不等式也必须取等号。由于所有pᵢ都为正,后者要求各个aᵢ相同。
而Σᵢpᵢaᵢ=1,所以这个共同值只能是1。也就是说,每个符号都必须满足
2^(−ℓᵢ)=pᵢ,或ℓᵢ=−log₂pᵢ。
长度却必须是整数。因此,本章这种逐符号前缀编码恰好达到熵,需要各个正概率正好写成2^(−k),其中k为非负整数。四符号例子满足;三个等可能符号的概率都是1/3,就不满足。若只有一个可能符号,概率为1且H=0;在符号数量已知的约定下,可以不给正文发送任何位,采用长度0的空码字。若符号数量未知,说明数量或结束位置的费用仍不能省略。
对三个等可能符号,H=log₂3≈1.585位/符号。码字0、10、11的长度为1、2、2,平均为5/3≈1.667。小数差距不是计算失误,是整数码长带来的余量。
这组1、2、2也确实最优:三个符号不能有空码字,否则它会是其他码字的前缀;最多一个码字长1,因为两个一位码字已占满全部容量。其余两个至少长2,因此长度总和至少5,平均至少5/3。若没有一位码字,三个长度都至少为2,反而更长。
熵因而是下界,却未必能由一个符号一个符号地编码精确达到。把“下界”直接说成任何压缩器都能得到的长度,会丢掉这层条件。
下界上方,最多留多少余量
一个自然做法是把信息量向上取整:ℓᵢ=⌈−log₂pᵢ⌉。⌈x⌉表示不小于x的最小整数。因为ℓᵢ≥−log₂pᵢ,有2^(−ℓᵢ)≤pᵢ,相加得到K≤1。
但满足容量不等式,就一定能真的安排出码字吗?对于有限个非负整数长度,可以。先把长度从短到长排列,在二叉树的当前深度,依次挑未被先前码字占住的节点。
轮到长度ℓ时,每个已经分配的长度k都不大于ℓ,它会挡住2^(ℓ−k)个当前位置。已占位置互不重叠。若连一个空位都没有,先前码字的容量之和便已达到1,再加入当前的2^(−ℓ)就会超过1,与全部长度满足K≤1矛盾。因此总能继续放下去。这也证明了Kraft条件在这里不仅必要,而且足够。1
又因为对每个实数z都有⌈z⌉<z+1,所以这张向上取整的码表满足
H ≤ L < H+1。
它未必是最优码表,但保证平均每个符号多用不到1位。三个等可能符号都向上取到2位,平均L=2;刚才的1、2、2更好。这两个结论完全相容:一种构造提供上界,不等于它达到最优。
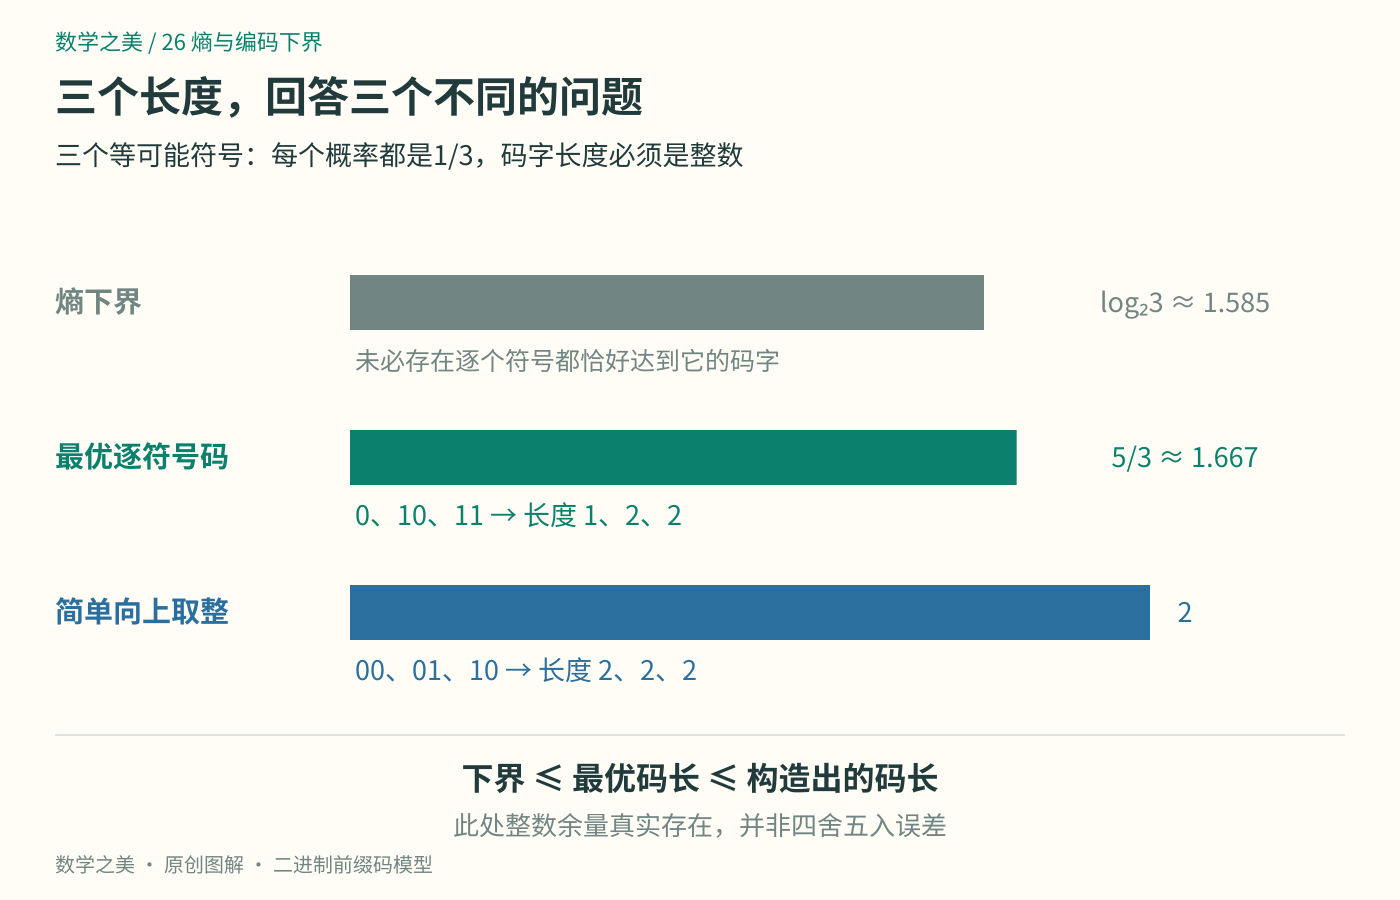
图3:理论下界、已构造的最优逐符号码、简单取整方案,是三个不同的量。不要把整数长度约束从问题中删掉。
还可以把k个符号捆成一个大符号再编码。若这k个符号独立且同分布,整组出现概率是各项概率的乘积。负对数把它拆成k项之和,再用期望的线性性,就得到整组熵为kH。因此存在整组平均码长Lₖ,使
kH ≤ Lₖ < kH+1,或H ≤ Lₖ/k < H+1/k。
整数余量由k个符号共同分摊,平均每符号的上界就可以逼近H。这并不是说真实软件可以零成本处理无限大的码表:字母表、码表存储、延迟与实现复杂度也会增长。若符号相互依赖,整组熵也不能直接写成kH,需要用真实的联合分布重新计算。
带着下界回到压缩
现在我们知道,“还有没有改进空间”至少要分两层问。固定分布、固定逐符号前缀编码时,熵限制平均正文长度,整数条件决定能否刚好达到。到了真实文件,还要问概率模型是否合适、符号之间是否有关联,以及格式开销到底多少。
单符号熵高,不代表一段有结构的序列无法压缩。比如先均匀选择A或B,再把选中的符号重复很多遍:每个位置单看都有一位熵,整段却只有“全A”与“全B”两种可能。若长度已知,传一位就能区分。错误不在熵,而在把相关位置当作独立,把整段熵错写成位置数。
反过来,一张按旧分布设计的短码表,也可能在新数据上变长。本章的最优性始终是相对于指定的p。下一章就把这个p与实际使用的另一个分布分开,算出“预测错了概率”究竟多付出多少平均代价。
推导补充:加权均值不等式从哪里来
正文没有使用导数。这里交代所借不等式的一个初等路线,愿意顺着检查的读者可以继续。
先由两个正数的情形,推出4个、8个直到2ᵏ个数的情形:把数分成同样大的两组,各组几何平均不超过各组算术平均;再用一次两数不等式合并。这个过程按组数归纳,便得到所有2ᵏ项的结论。
任意n个正数的算术平均记为A。取2ᵏ≥n,补进2ᵏ−n个A。补完后的算术平均仍是A。把已证明的不等式两边取2ᵏ次幂,得到(∏ᵢaᵢ)A^(2ᵏ−n)≤A^(2ᵏ)。由于A>0,约去补入的因子,就得到∏ᵢaᵢ≤Aⁿ,即原n个数的几何平均不超过A。这一步没有预先假定n项结论。
若权重pᵢ=mᵢ/M为有理数,把aᵢ重复mᵢ次,总共M项,再用上一步即可得到加权式。一般正实数权重可由保持为正、且和为1的有理权重逼近:先足够精确地逼近前n−1项,再用1减去它们的和作为最后一项。有限乘积与实幂的连续性让不等式保留下来。最后这个延伸借用了实数分析的连续性,不在本章从头建立。
等号条件还要单独检查,不能只靠连续性传递。所有aᵢ相同时显然取等号;若有aᵢ≠aⱼ,从这两项各抽取一份相同的正权重δ,例如δ=min(pᵢ,pⱼ)/2。把这两份替换为权重2δ、数值b=(aᵢ+aⱼ)/2的一项,其余权重不变。新的加权算术平均不变,而b>√(aᵢaⱼ),所以几何平均严格增大。新几何平均仍不超过同一个算术平均,原几何平均便必定严格小于它。因此在所有权重为正时,取等号当且仅当所有aᵢ相同。2
顺手试一下
题目1: 四符号概率仍为1/2、1/4、1/8、1/8。有个方案打算使用长度1、2、2、2。它能成为前缀码吗?若改用2、2、2、2,平均码长比熵多多少?
**提示:**先检查Σ2^(−ℓᵢ),再按给定概率计算期望,不要把四个长度直接作不加权平均。
**参考答案:**第一组容量为1/2+3×1/4=5/4>1,不可能安排成前缀码。第二组容量为1,可以用00、01、10、11;平均长度为2,比H=7/4多1/4位/符号。
题目2: 一个符号只有A、B两种,概率分别为3/4、1/4。计算其熵,说明逐符号前缀码最少平均用几位。若100个符号独立同分布并一起编码,本章能保证每符号平均长度落在哪个范围?
**提示:**两个正概率符号各自至少需要一位;捆成一组时应用H≤Lₖ/k<H+1/k。
**参考答案:**H=−(3/4)log₂(3/4)−(1/4)log₂(1/4)≈0.811278位/符号。逐符号使用0、1即可达到L=1,两个码字都不可能少于一位,所以这是最优。对100个独立同分布符号,存在前缀块码使H≤L₁₀₀/100<H+0.01,约在0.811278至0.821278之间;这是期望正文长度的范围,不保证每一个具体块都一样长,也未计码表和封装开销。
参考与延伸
1 MIT 6.441,Muriel Médard,Lecture 5: Codes, Kraft Inequality, Optimal Codes,第4—6、10—12页。核对前缀码长度的必要与充分条件、整数码长及块编码界。本文用加权均值不等式组织下界证明,没有使用讲义中的拉格朗日乘子。
2 Manuel Eberl,Pólya’s Proof of the Weighted Arithmetic–Geometric Mean Inequality,Archive of Formal Proofs。核对加权不等式及正权重时的等号条件;文末采用两数不等式逐步扩展的路线,与该文采用的证明路线不同。
3 MIT 18.440,Scott Sheffield,Lecture 34: Entropy,第6、11—12页。核对有限分布熵的定义及平均码长解释。四符号码表也是教材中的标准例子;本系列的消息、图解和推导展开独立编排。
作者:Jiancheng Wang · 数学之美(独立原创)