先修:07 计数与指数增长;09 对数与比较排序
把一叠乱序单据分成两半,再把每半分成两半,直到每份只剩一张。假如有八张,只要分三层;有一千零二十四张,也不过十层。既然每次减半,排序是不是只要做十来次事情?
问题出在“做”的对象变了。三层描述的是一份任务向下缩小的深度;整理八张单据,却需要把同一层的所有小份都处理完,还要把它们重新接起来。分割没有让另一半凭空消失。
上一章用对数衡量连续减半的次数。这一章把账本展开:每层有多少份任务,每份各花多少工作,最后怎样合计。我们只沿着归并排序这一个例子,把“分得很快”与“全部做完”之间的差距算清楚。
先说清楚数的是什么
输入是n个可比较大小的数(n≥1),目标是按从小到大排列,保留每个数出现的次数。本章所用的归并排序,先按位置将输入尽量平分,分别排好两半,再把两个有序列表合成一个;只有一个数时,不用排序。
“分别排好”仍使用同一方法,这叫递归。它能够停下,是因为每次交给下一步的列表更短,最终长度为1。若两半已经有序,而合并能得到完整的有序列表,就可以从最小任务逐层保证整个排序正确。
我们先只数键比较:拿两个输入值判断谁更小,算一次;相等时约定先取左边。判断列表是否为空、移动下标、复制一个值,都暂时另记。这里不用“假想的无穷大”补在列表末尾;一边用完,就直接接上另一边的剩余值。
这种分账不是说复制免费,而是先隔离一个能够准确计算的指标。否则有人数比较,有人数赋值,却都称为“步骤数”,公式看似矛盾,实际没有在量同一件事。
八个数怎样收回一张有序清单
从这组数开始:
7, 2, 6, 3, 1, 8, 5, 4
按中间位置分成左右两半,继续拆开,得到八个单元素列表。随后从底部向上合并。首先把相邻的单元素配对:
7与2合成2, 7;6与3合成3, 6;1与8合成1, 8;5与4合成4, 5。
每次比较两个数就知道次序,各用1次,总共4次。再合并前两个长度为2的列表:比较2与3,取2;比较7与3,取3;比较7与6,取6。右边用完,把7接上,得到2, 3, 6, 7,共3次比较。
另一组同样用3次,得到1, 4, 5, 8。这一层合计6次。
最后合并两个长度为4的列表。依次比较的数对是:(2,1)、(2,4)、(3,4)、(6,4)、(6,5)、(6,8)、(7,8)。每次取较小值,依次写出1、2、3、4、5、6、7;左边用完,直接接上8。这一层用了7次。
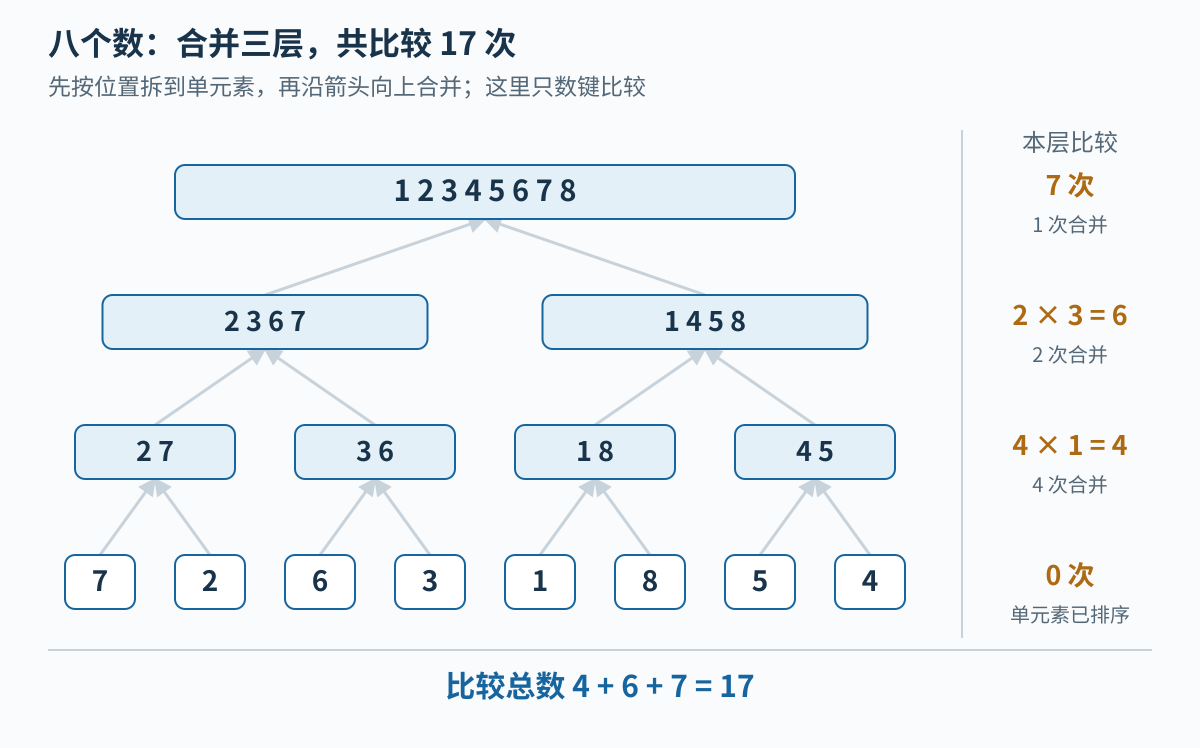
图1:箭头沿实际合并方向向上。每个框都是已经有序的列表;右侧按层汇总比较次数,不重复计算下面已经记过的工作。
总数是4+6+7=17。看见“只分了三层”时漏掉的工作,现在都有了去处。
为什么合并至多需要m-1次比较
先把一个合并步骤单独拿出来。两个非空列表已经有序,总长度为m。它们尚未输出的最小值,各自在当前表头;全部剩余值中的最小者,因此必在两个表头之中。比较表头,取出较小者,便能安全地写下输出的下一项。
取走之后,两边剩余部分仍有序。同一个理由可以继续使用。某一边空了,另一边本来就有序,而且不会小于已经输出的最后一项,直接接上即可。这说明合并为何正确。康奈尔大学CS 2110的归并讲义也从“下一项只能来自两个表头”解释这一过程。
“两边已经有序”不能删掉。若把3, 1与2, 4直接交给这个过程,先取2,再取3,然后才遇见1,输出已经错了。分割本身不制造有序性;必须等两份递归任务各自完成,才能使用合并步骤的保证。这也是为什么不能分完以后,只整理其中一边就收工。
每次键比较恰好输出一个值。做完m-1次这样的操作,未输出的总共最多只剩一个值,两边不可能都还有值。因此,需要比较两个表头的阶段一定已经结束,比较次数至多m-1。
这个论证没有说每次都要做到上限。合并1, 2与3, 4,只比较1与3、2与3,就能把剩余部分接上,共2次,小于3次。若改成1, 3与2, 4,就需要3次。关键在于两边何时有一边先耗尽。
有重复值也一样。例如2, 2与2, 2,按照相等先取左边的约定,比较两次后左边为空,但输出仍保留四个2。证明依赖“每次取走一个值”,不依赖“所有值互异”。
用整层的账,替换一条路径的账
先令n=2ᵏ,其中k是非负整数,好让每层都能平均分。最上面的合并处理n个值,至多比较n-1次;下一层有两个合并,各处理n/2个值,这一整层的上限是:
2×(n/2-1)=n-2。
再下一层有四个合并,每个处理n/4个值,整层上限为n-4。任务数量翻倍,每份长度减半,同层处理的总长度始终是n。它没有随着分割一起减半。
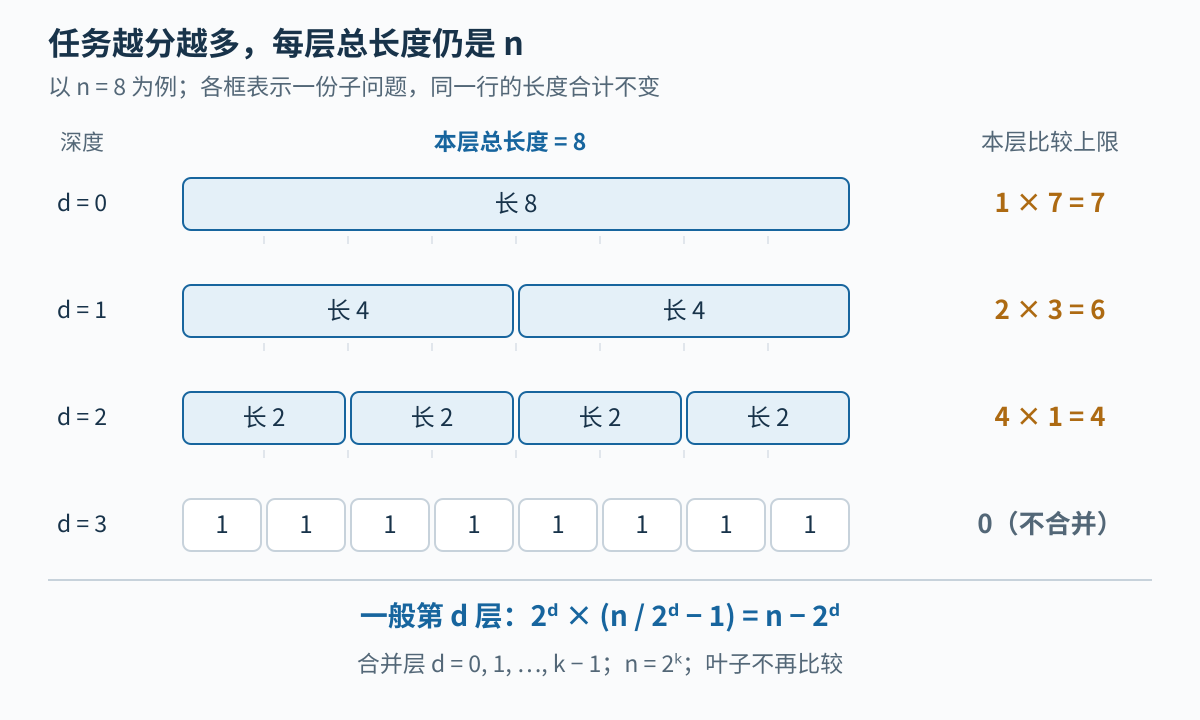
图2:深度d从最上面的合并算起,d=0。每层有2ᵈ个任务,每份长n/2ᵈ,所以比较上限是2ᵈ×(n/2ᵈ-1)=n-2ᵈ。
当长度降到2时,仍要合并;降到1时不再比较。于是有合并工作的深度为0、1、…、k-1,共k=log₂n层。长度为1的叶子在深度k,不要把它误算成又一层合并。
将各层上限相加:
(n-1)+(n-2)+(n-4)+…+(n-2ᵏ⁻¹)
=kn-(1+2+4+…+2ᵏ⁻¹)。
设括号里的和为S。2S比S多出最后的2ᵏ,少了最前面的1,所以2S-S=2ᵏ-1,即S=n-1。因此总比较次数不超过:
n log₂n-n+1。
现在,乘积中的两部分各有来处:n来自同一层所有列表长度的总和,log₂n来自合并层数。减去的n-1则来自每个合并至少留下一个不用再比较、直接接上的值。这个修正累计遍布各层,不能只在整次排序结束时减去1。
也可以把这份账写成递推。令C(n)表示本章算法在长度n的所有输入中,键比较次数的最大值。那么:
C(1)=0;C(n)≤2C(n/2)+n-1。
右边分别计入两半排序和最后合并。用归纳再核对一次:n=1时,公式给出0;假设长度n/2的上界成立,代入便得:
C(n)≤2(n/2)log₂(n/2)-n/2+1+n-1
=n(log₂n-1)+1
=n log₂n-n+1。
这里始终保留“≤”。推导已经证明所有输入都不会超过它,没有仅凭递推就宣布每个输入都达到它。八数示例确实得到8×3-8+1=17,因此在n=8时达到了上界;对一般n,本章到这里证明的是上界。
MIT 6.006的归并排序与递归树讲义用“两份半规模工作,加上线性合并”记录总成本。我们的逐层账本把其中的键比较进一步细化到了减去多少。
相同的减半,为什么得出不同代价
在有序数组里做二分查找,查看中间位置后,可以排除一边,接下来只查另一边。只要一次中点访问和比较的成本有固定上限,单次查找就是沿一条越来越短的路径走下去。
归并排序也把长度减半,但左右两边都要排。递归树上的两条分支是都要执行的任务,不是两个只能选其一的答案。并且每个合并节点的工作随它处理的长度增加,不能一律记为“一次”。
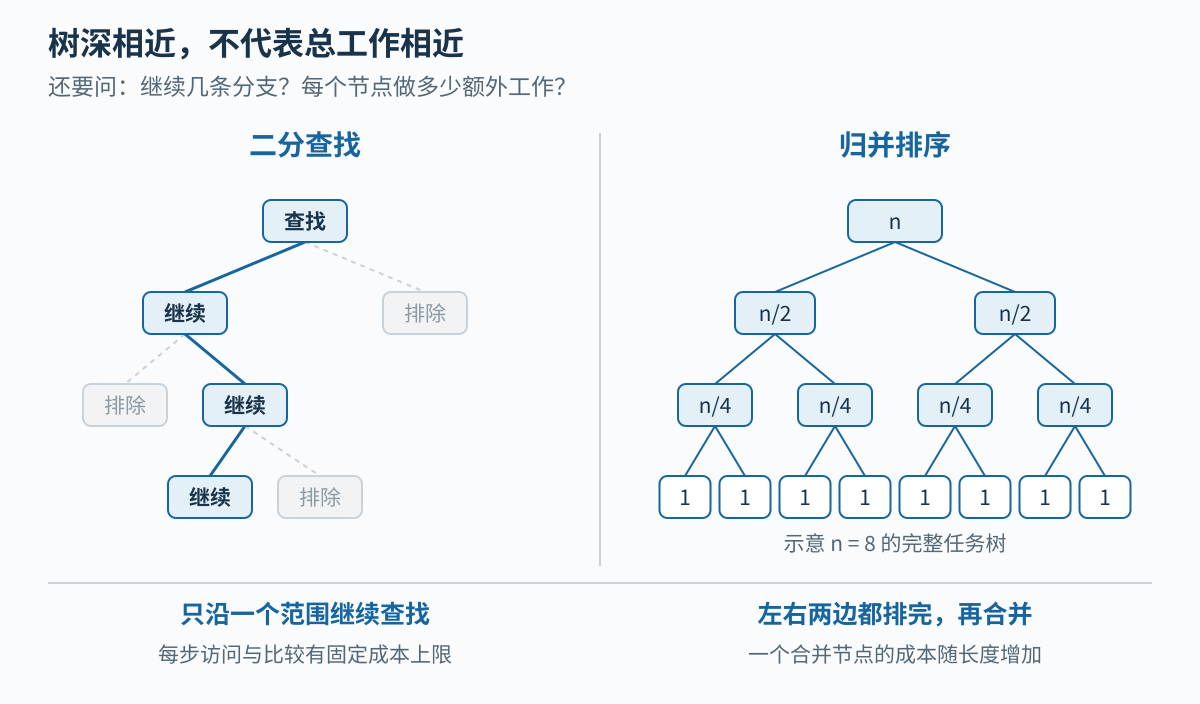
图3:左图表示有序范围持续减半,灰色部分不再搜索;右图所有子问题都要处理。图中的层数只描述深度,不能直接代替总工作。
这就给出了“每次减半,所以总工作只有log₂n”的反例。那句话遗漏了两个条件:是否只继续处理一份子问题,每一步的额外成本是否有固定上限。归并排序在这两处都不同。
通常把上面的增长上界简写为C(n)=O(n log n)。大O表示:存在固定常数K和起始规模,从那以后C(n)都不超过K倍的n log₂n。这里C已被定义为最坏比较次数;“最坏”来自我们选择的函数,不是字母O天生就代表最坏情况。
若n不是2的整数次幂,就将两半长度取成尽量相近的整数。树深至多为log₂n向上取整,每层的合并总长度不超过n,因此同样得到O(n log n)的上界。前面那条带“-n+1”的精细公式,本章只在n=2ᵏ的条件下使用。
账本能告诉工程师什么
首先,17不是八个数排序的固定费用。如果输入本来就是1, 2, 3, 4, 5, 6, 7, 8,按本章不提前跳过合并的版本,三层分别比较4、4、4次,总共12次。每次合并都是左半先耗尽。树形一样,实际比较数仍会因输入改变。
其次,比较上界不是毫秒数。比较两个整数与比较两个长字符串,单次费用可能不同;将结果复制到辅助数组,也会消耗时间和内存带宽。复用一个与输入等长的缓冲区,可以避免为每次合并反复申请大块空间,但这并没有消除数据移动。
两半可以独立处理,允许一定的并行安排;然而总比较工作不会因为换成两名执行者就自动减半,等待时间还受合并和调度影响。总工作量、峰值额外空间、实际耗时,需要分别测量。
因此,判断一次优化是否有效,先说它减少了什么:比较、复制、分配,还是等待。分而治之给我们的可贵视角,是把一团看不清的费用拆成能够逐项检查的账。
写实验时,可以单独给比较操作加计数器,再分别测试随机、递增和含重复值的输入;计数结果用来核对模型,计时结果用来观察机器上的费用。若实现增加了“检查两半边界、已经整体有序就跳过合并”的优化,那次边界比较也应入账,不能沿用未经修改的精确次数。代码变了,账本的口径也要跟着变。
顺手试一下
题目1:把规模从8加到16
仍用本章算法处理16个数。请从最底层向上列出每层的合并数量、单次比较上限和该层总上限,再求总上限。只凭这个结果,能说任意16个数都恰好需要这么多次比较吗?
**提示:**最底层先合并成长度为2的列表,每次至多比较1次。
**参考答案:**四层依次为:8个合并、每个至多1次,共8次;4个合并、每个至多3次,共12次;2个合并、每个至多7次,共14次;1个合并、至多15次。相加为8+12+14+15=49,也等于16×4-16+1。不能把上界当成每次执行的精确值;例如输入已经递增时,每层只需8次键比较,共32次。
题目2:把“重新合并”改成“求和”
另一个算法求n=2ᵏ个数之和:一个数直接返回;否则分别求左右两半的和,再把两个结果相加。不计拆分和返回,只数加法。它也有k层分割,总共需要多少次加法?为什么没有出现n log₂n?
**提示:**两个部分和无论代表多少个原始数,合起来只做一次加法。
**参考答案:**设加法次数为A(n),则A(1)=0,A(n)=2A(n/2)+1。从顶部向下,各层加法数为1、2、4、…、2ᵏ⁻¹,总和为2ᵏ-1=n-1。也可归纳核对:2(n/2-1)+1=n-1。这里仍处理两个半边,但每个内部节点只做一次加法;各层工作随节点数增加,不是每层都处理n次左右的操作。树深相同,合并规则不同,总费用就不同。此计数假设一次加法按一个操作记,不讨论大整数位数增长的成本。
作者:Jiancheng Wang · 数学之美(独立原创)