先修:01 建模与假设;04 不变量;18—23 告警与评估;34 泛化;35—38 数值误差;39 计算边界
一条告警出现在值班人员的手机上:“服务错误率超过1%。”它看起来只是一次除法加一次比较,背后却有一串不同的问题:哪些请求被数进来了?缺失数据怎么办?超过阈值就立即通知吗?三条通知代表三次故障吗?
最后一章沿着这条消息往回走。我们以Prometheus公开的监控、告警架构为参照,搭一条可以手算和检查的简化数据流。**这是以实际公开架构为参照的简化教学设计,数值与改造都是假设,不是生产部署或系统审计报告。**数学能给出具体保证,但每份保证都要写明自己覆盖的对象。
先沿着数据走一遍
真实Prometheus从被监控目标拉取指标,保存时间序列,并用规则计算和生成告警。指标名与标签共同标识序列,例如服务、实例等维度使不同来源可以区分。[1] 告警规则负责判断条件;Alertmanager接收告警,进行去重、分组和路由,决定通知如何送达。[3][4]
下面保留这条主线,增加两个教学环节:阈值附近允许回答“不确定”,事后用独立证据核验故障标签。这两个环节不是对Prometheus默认行为的描述。
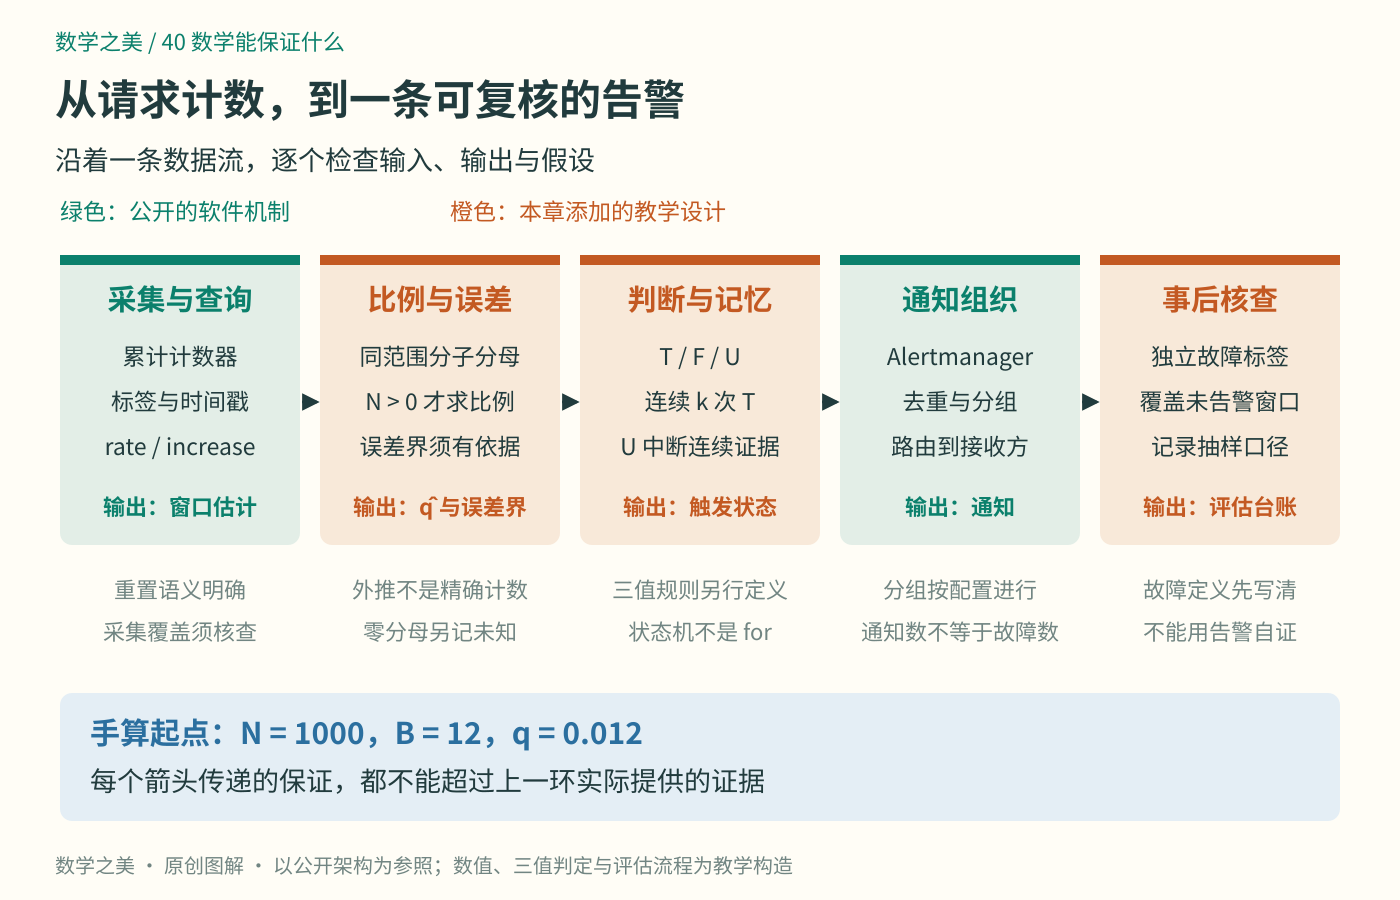
图1:箭头表示传递的数据。每个接口都要说明输出是什么、依赖什么条件。橙色部分是本章的教学设计。
先约定研究某个服务、某个环境中已完成的HTTP请求;错误指其中返回5xx状态码的请求。一次重试算另一次请求,所以这里衡量的是请求尝试,不是用户操作成功率。分子和分母必须来自同一范围、同一窗口,错误请求须属于总请求。
取一个固定的五分钟窗口。先在理想化的完整记录中设总数N=1000、错误数B=12,那么
q=B/N=12/1000=0.012=1.2%。
q是这个窗口内的错误比例。它不直接等于下一次请求出错的概率,更不等于“服务有故障的概率”。后两种说法分别需要未来请求模型和故障定义。
还要处理N=0。此时B/N没有定义,我们输出“未知,不评价这个比例”,不能把0/0改成0后称为健康。若没有请求本身值得关注,应另立流量或可用性规则。采集缺失与确实零流量也必须区别记录。
实际采集通常给我们累计计数器的若干快照,不是完整逐请求台账。进程重启会让计数器重置,不能把末值减初值就当窗口请求量。Prometheus的rate计算每秒平均增长率,increase计算窗口增长量;它们会调整观察到的计数器重置,并向窗口边界外推,所以increase即使处理整数计数器,也可能得到非整数。[2]
因此,下文的1000与12是手算设定,不能声称一次查询必定恢复了精确事件数。聚合多实例时,也应先对各序列计算rate,再求和,以免先相加掩盖重置。[2] 从真实请求到查询结果,这一段的数据覆盖与估计误差,需要单独核查。
一条阈值旁边,要留多少余地
设阈值τ=0.01,规则是严格超过才算越线,即q>τ。对精确的12/1000,答案当然是真。但机器拿到的常是估计值q̂,测量、窗口外推与计算都可能使它偏离q。
假定我们另有依据,能保证绝对误差不超过ε,即
|q̂−q|≤ε。
这句话等价于q̂−ε≤q≤q̂+ε。于是可以作三个判断:
- 若q̂−ε>τ,整个允许区间都高于阈值,可证越线,记T
- 若q̂+ε≤τ,整个允许区间都不超过阈值,可证未越线,记F
- 其余情况,越线与未越线都不能排除,记U,表示不确定
这里的F只表示这个比例未越线,不表示服务所有方面健康。τ恰好等于区间上端时仍可判F;恰好等于下端时却不能判T,因为规则用了严格大于。
例如ε=0.001,即0.1个百分点。q̂=0.012时,下界为0.011,仍大于0.01,可以判T;q̂=0.008时,上界为0.009,可以判F;q̂=0.0105时,允许范围为[0.0095,0.0115],应判U。
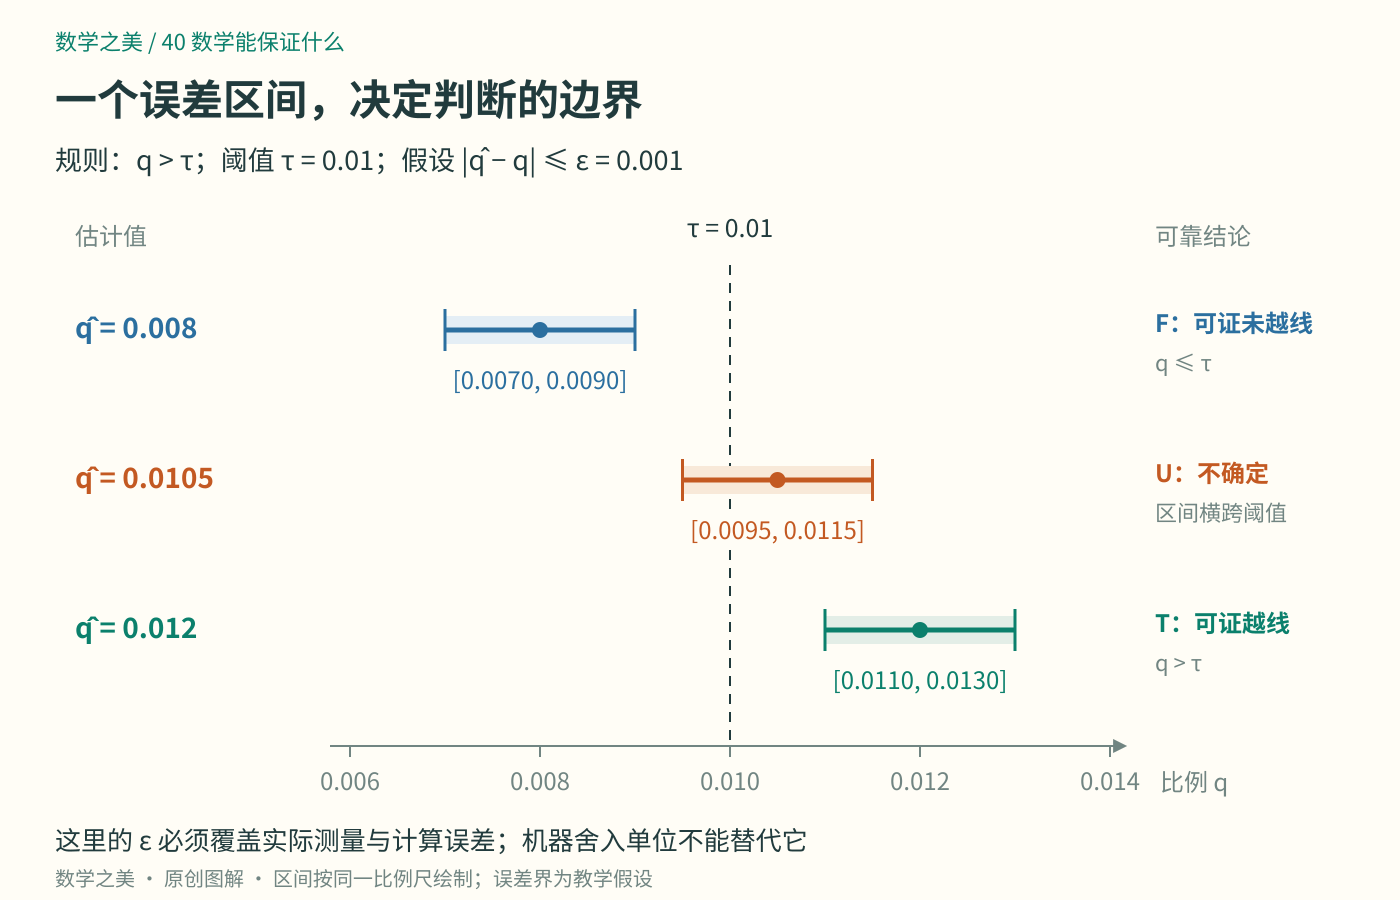
图2:误差区间来自假设的统一上界ε=0.001;图上的横坐标表示比例,三个区间按同一尺度绘制。
推导很短,困难在于误差界是否真的成立。若先有测量估计值q̃,并分别保证|q̃−q|≤ε测、|q̂−q̃|≤ε算,三角不等式才给出ε=ε测+ε算。漏采、范围不匹配或重复计数若没有覆盖,就不能声称这份预算管住了全部误差。
机器舍入单位u只描述特定条件下的浮点运算尺度,不能直接充当这里的ε。Prometheus也不会自动附送上述确定误差界。若现有证据只能提供一个有覆盖概率的统计区间,结论同样要保留概率条件,不能改称对每次窗口都成立的证明。
让局部判断组成一个有记忆的规则
一次越线可能只是短促波动。真实Prometheus规则的for选项要求条件在指定持续时间内、每次评估时保持活跃,之后才进入firing;此前是pending状态。[3]
为了完整证明一个小规则,我们另设“连续k次T才触发”的有限状态机。**它是教学模型,不是for持续时间语义的精确采样实现。**我们将每次判断按顺序送入它,取正整数k;U无论来自误差带、零分母还是数据缺失,都中断连续证据,并另行记录未知原因。
用整数c表示当前连续T的次数,但最多记到k。初始c=0,每次更新为:
T输入:c新=min(c旧+1,k);
F或U输入:c新=0。
更新后c=k,输出“触发状态”;否则不触发。取k=3,输入T、T、U、T、T、T,c依次成为1、2、0、1、2、3,第一次触发发生在第六次判断。
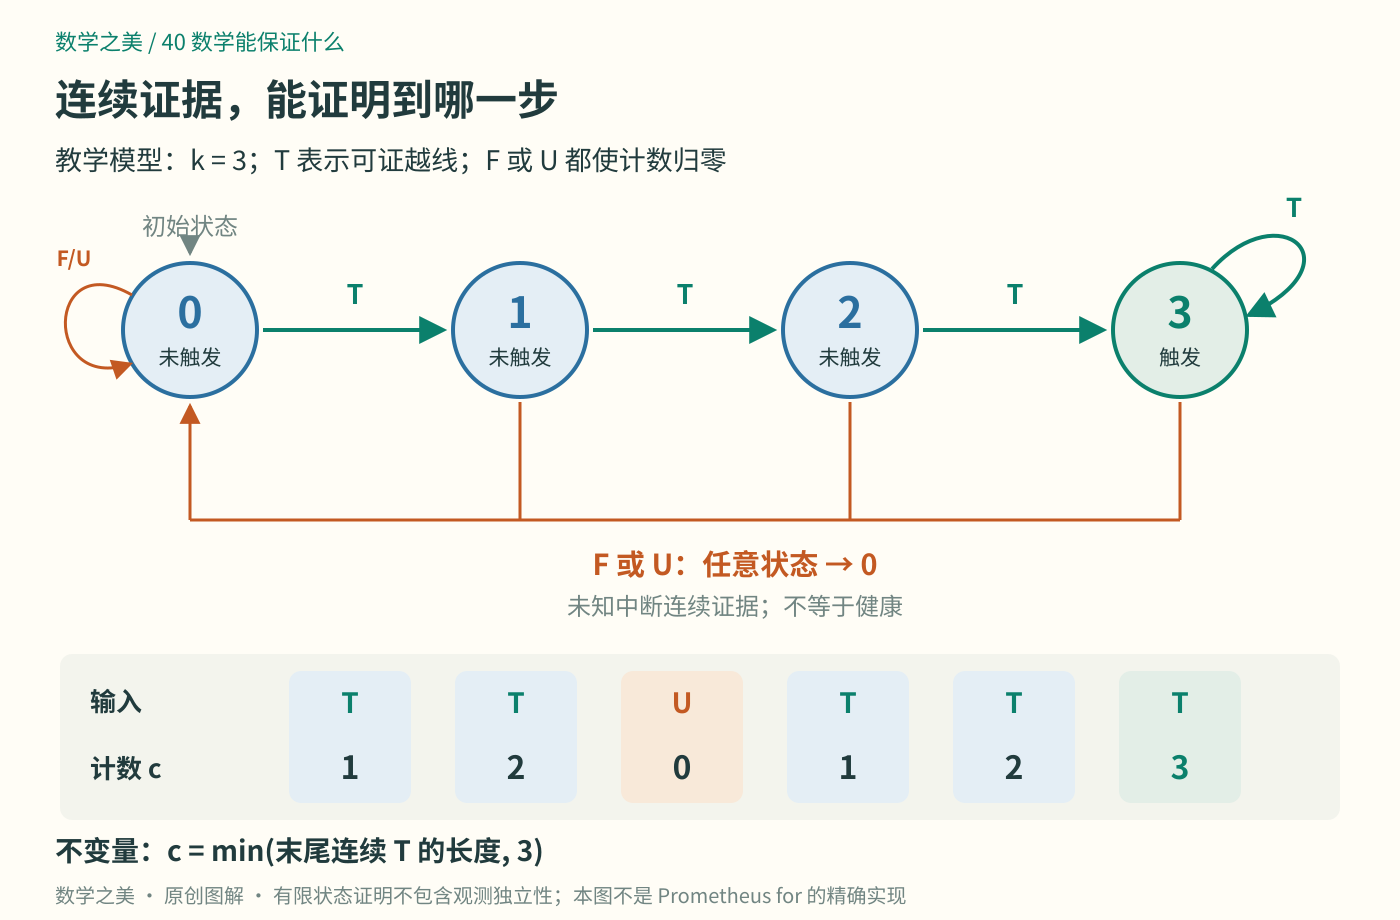
图3:图中k=3。状态3只表明最近至少三个输入连续为T;未知使计数归零,不等于把未知判断成健康。
第04章的不变量在这里派上用场。我们要证明:每次更新后,c等于“输入序列末尾连续T的长度”与k的较小者。
开始没有输入,末尾连续长度为0,与c相符。假设更新前成立:新输入为T,末尾长度加1,饱和加法也恰好把c增加到不超过k的对应值;新输入为F或U,末尾连续长度变为0,c也归零。因此这个关系经过每次转移都保持。
它立刻推出0≤c≤k,也推出第一次到达k之前必有k个连续T。无需列举未来所有输入串,一次初始化与三种输入的保持证明,已经覆盖任意有限前缀。实现时应选用能表示0至k的整数类型,先检查c<k才执行加1,已到k就保持k,避免先计算k+1造成整数溢出。数学式写对了,还须核对代码使用的数据类型与分支。
不过,“连续三次”没有创造三个独立样本。若每分钟评估一次过去五分钟,相邻窗口大量重叠;即便窗口不重叠,同一次故障也可能持续跨窗。不能把单次误判概率α直接改写成α³,除非三个误判事件在同一条件模型下联合独立,且各自误判概率都为α。降低抖动也不等于消灭误报,等待还会增加响应延迟。
未知时归零也是一项选择:它保住“最近连续证据”的含义,却可能让持续异常在采集恢复后重新等待。若要缺数据时保持原告警,或单独发出采集故障通知,就要增加状态或另立规则,再检查新的承诺。不能一边修改转移,一边沿用旧证明。
少收到几条消息,不等于少发生几次故障
接下来,告警进入Alertmanager。它确实支持去重、按标签分组,并沿配置的路由树选择接收方;分组可把多个相关告警装进一份通知。[4] 这解决通知组织问题,不会自动把若干相关观测变成独立事故。
例如,同一服务两个实例产生告警,被合成一条通知。若评估单位原本是“实例与五分钟窗口”,合并后仍是两条待核查记录;若单位是“整个服务的一次事故”,又须先定义事故起止及合并规则。通知数量、告警实例数量、故障数量不能互换。
为了与第18—23章接上,这里评估时另取不重叠的服务五分钟窗口。D表示独立核查确认的目标故障,E表示窗口内至少一次判断后规则处于触发状态。台账应保存服务、环境、窗口、规则版本与未知状态,故障标签则由事后证据给出。软件里的服务标签用于标识序列,这里的故障标签用于评价结果,二者角色不同。
假设全部1000个窗口都核验明确,也没有未知输入窗口,其中告警30个:20个确有故障,10个没有;未告警970个:另有5个故障,965个健康。则
告警中真故障比例=20/30=2/3;
故障检出率=20/(20+5)=0.8;
告警比例=30/1000=0.03,故障比例=25/1000=0.025。
这些是虚构完整台账里的不同除法。只知道告警比例3%,并不能反推出故障比例2.5%。按第20章,P(E)=P(E|D)P(D)+P(E|Dᶜ)P(Dᶜ);缺少检出与误报信息,一条混合比例不足以确定未知的故障比例。
核查不能把“规则曾触发”本身当成故障证据,否则系统在用自己的输出给自己打分。版本、阈值和评价口径也应在收集最终证据前固定,不能看完成绩再挑最有利的说法。
真实评估若只抽查,应覆盖告警和未告警窗口,并记录抽样方法;未知标签另列。把结论推向未来,还要检查代表性、相关性与环境变化。若换成学习得到的预测基线,它是另外加入的模型,须把训练、选择阈值和最终评估隔开;训练误差低仍不是泛化证明。给系统增加AI,并不会删去这些证据要求。
一份保证怎样接到下一份保证
现在我们有了三种范围不同的结论。比例误差界支持T、F的可靠含义;状态机保证何时达到连续触发条件;独立核查与合适抽样支持检测表现的评估。它们可以相接,但不能互相替代:状态机证明无法修补漏采,独立测试也不能证明每次状态转移都写对了。
对k=3,状态只有四个、输入只有T、F、U三种,可以逐项检查12个状态与输入组合,再用不变量理解任意长输入前缀。这里每一步计算都能结束,整个监控服务却可以按设计长期运行。证明对象不是“整个系统终有一天停机”。
第39章排除了无界通用程序上的万能停机判定器,没有禁止这些有限范围的证明与检查。反过来,检查完这12种转移,也没有验证网络传输、所有配置与任意外部程序。一次数学证书只覆盖明说的对象、假设与结论。
遇到一个新系统,可以从一条真实输入走到最终决定:先写它表示什么,再找会丢失信息的接口,给比较留下误差范围,给状态留下不变量,最后问现实效果需要怎样的证据。某个接口只能回答未知,就把未知留在输出里,让后面的判断知道它缺了什么。
第一章的地铁图保留连接,舍去街道形状;这里保留请求类别、时间范围与转移规则,也舍去了许多现实细节。两者都要回答“为这个问题,保留什么,丢掉什么”,却不因此拥有同一套数学定理。证明、数值分析与统计各自处理不同困难。数学之美在于:原先一句模糊的“系统应该可靠”,终于能拆成一条条说得清、算得出、经得起检查的承诺。
顺手试一下
题目1:阈值究竟过没过? 设τ=0.01,确定误差界ε=0.001。三个窗口的q̂依次为0.009、0.011、0.0112,分别应输出T、F还是U?另一个窗口N=0,为什么不能把比例记为0?
**提示:**规则是q>τ,检查区间端点,尤其注意等号。
**参考答案:**第一个区间[0.008,0.010]全部不超过阈值,判F;第二个为[0.010,0.012],仍允许q恰好等于阈值,判U;第三个下界0.0102>0.01,判T。N=0时比例无定义,应输出U并注明零流量,另按需要评价流量或可用性,不能冒称错误比例为0。
题目2:同一个未知,两种记忆策略。 取k=3,输入T、T、U、T。按正文规则写出c。若改为遇U保留c,能否仍保证“触发时最近三次已处理的输入连续为T”?三次T来自同一个持续异常时,能否把单次误判概率α立方?
**提示:**分别跟踪末尾连续T的长度;状态规则与概率假设要分开核对。
**参考答案:**正文规则得到1、2、0、1,不触发。保留策略得到1、2、2、3,在第四次触发,但最近三次输入是T、U、T,原保证已不成立。新策略可能有用途,却需要改写为“忽略U后的连续性”等规格,并说明未知可持续多久。三次T相关时不能直接用α³;必须有同一条件模型下联合独立、且各次误判概率都为α的依据,或另行估计联合误判概率。
参考与延伸
[1] Prometheus官方Overview,架构图及数据采集、带标签时间序列、规则与告警组件的说明。本文只取与这条数据流有关的部分。
[2] Prometheus官方Query functions,rate、increase条目:计数器重置调整、窗口外推及先计算rate再聚合的语义。
[3] Prometheus官方Alerting rules,条件、标签集合、for持续时间及pending与firing状态。正文连续k次模型另行定义。
[4] Prometheus官方Alertmanager,去重、分组与路由。分组通知不等于统计独立样本。
官方资料核对日期:2026年10月7日。本文数值、误差预算、练习及三幅图为原创教学构造。
作者:Jiancheng Wang · 数学之美(独立原创)